פיתוח בינה מלאכותית: מדריך מקיף להקמת פרויקט
העצה הכי פופולרית על פיתוח בינה מלאכותית היא גם אחת המזיקות ביותר: "תתחילו בקטן עם צ'אטבוט". זו עצה נוחה, אבל לרוב היא דוחפת ארגונים לפתור בעיה לא חשובה, עם דאטה לא מוכן, ובלי דרך אמיתית להגיע לייצור. התוצאה מוכרת. דמו יפה, הנהלה מרוצה לשבועיים, ואחר כך פרויקט שנתקע בין ה-POC למחלקת ה-IT.
פיתוח בינה מלאכותית טוב לא מתחיל ממודל. הוא מתחיל מהחלטה עסקית. איזה תהליך צריך להשתנות, איזה צוואר בקבוק שווה כסף, ואיזה סיכון אתם מוכנים לקחת. רק אחר כך בוחרים ארכיטקטורה, ענן, Stack, וצורת הטמעה.
בישראל זה עוד יותר חד. מצד אחד יש אקוסיסטם טכנולוגי חזק, השקעה ממשלתית, הרבה ספקים, ומנהלים שכבר מבינים ש-AI הוא לא צעצוע. מצד שני, יש פער ביצועי אמיתי בין מרכז לפריפריה, בין הייטק לארגונים מסורתיים, ובין מי שיודע להרים MVP ב-Node.js ו-Python לבין מי שצריך להטמיע מערכת בתוך סביבת Legacy, רגולציה, ועובדים שלא יחיו בתוך Promptים כל היום.
תוכן עניינים
- הפער הביצועי בין תל אביב לפריפריה בפיתוח בינה מלאכותית
- ארבע שאלות החלטה לפני שמתחילים פרויקט פיתוח בינה מלאכותית
- בחירת מודלים וארכיטקטורות בעידן ה-AI היוצר
- תשתיות, MLOps והמעבר מקוד לעולם ה-Orchestration
- דוגמאות מהשוקה מקומי שמראות למה אין מודל אחד שמתאים לכולם
- הערכה, מדדים ומעבר מ-POC לייצור
- סיכונים רגולטוריים ואתיים שצריך להכיר לפני שמתחילים
- רשימת החלטות מעשית לפני שמתחילים לפתח
הפער הביצועי בין תל אביב לפריפריה בפיתוח בינה מלאכותית
הנחת העבודה שפיתוח בינה מלאכותית מיועד בעיקר לסטארטאפים בתל אביב כבר אינה רלוונטית. בישראל אימוץ בינה מלאכותית חצה את רף ה-28% מהעסקים, ובקרב עובדים מדובר על כ-32% מתוך מקומות עבודה שבהם AI כבר משולב בפעילות העסקית, לפי ניתוח של המכון הישראלי לדמוקרטיה. השוק המקומי עבר משלב הסקרנות לשלב שבו צריך להפעיל מערכות, למדוד תוצאות ולשלוט בסיכונים.
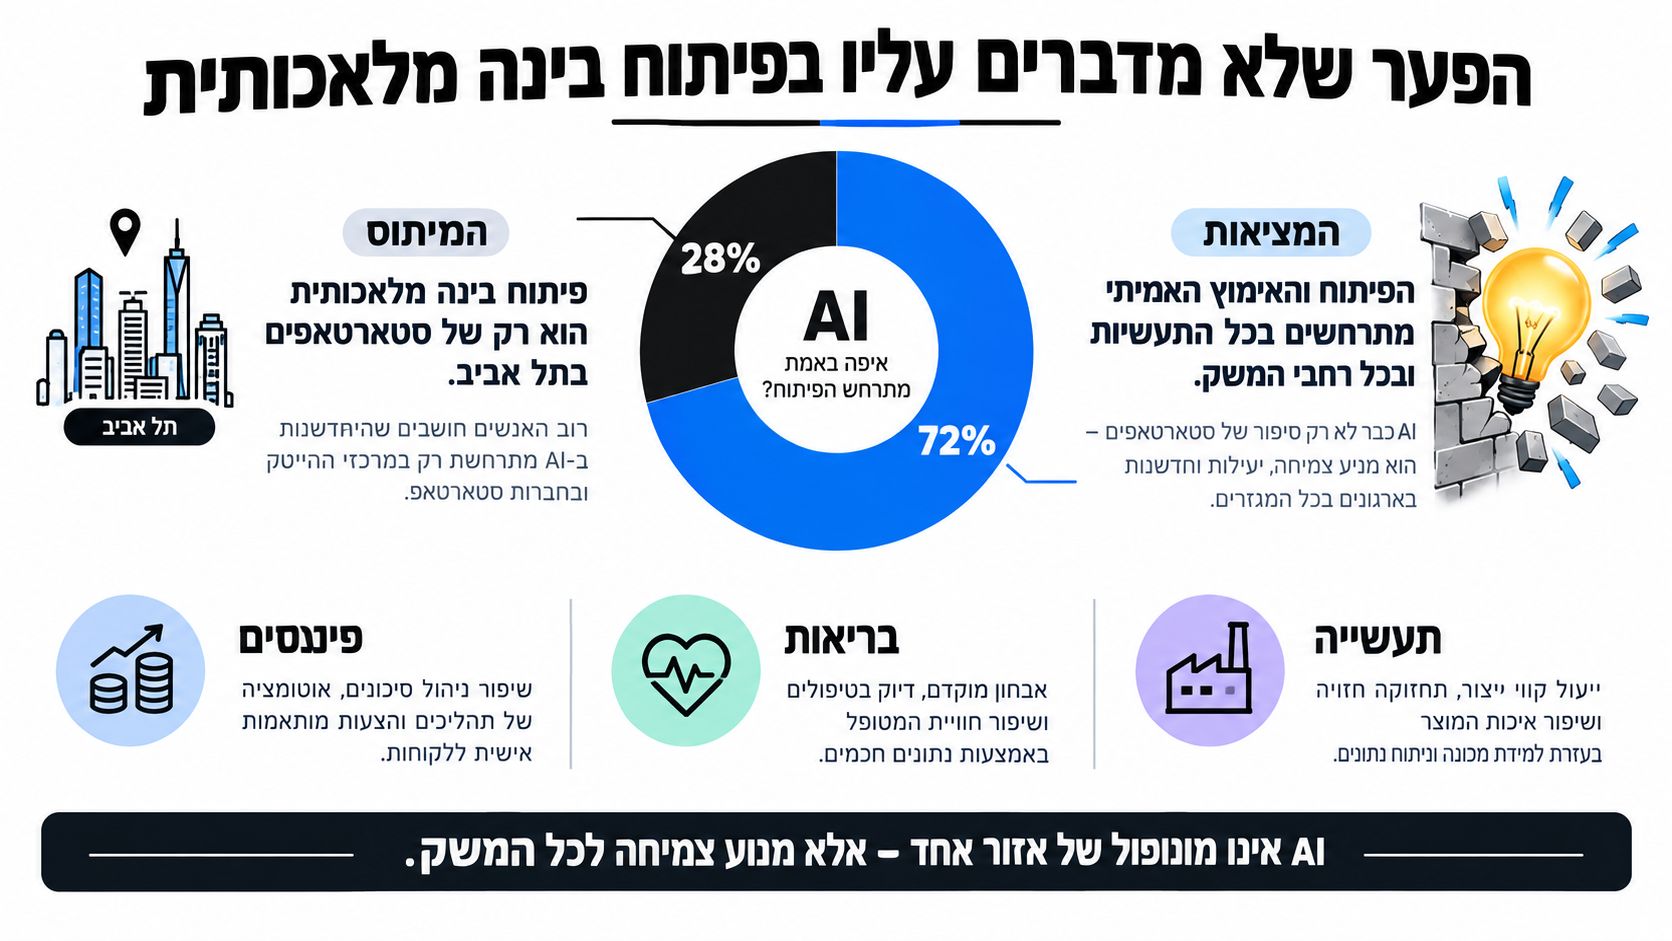
אותו AI, תנאי ביצוע שונים
בתל אביב ארגונים בוחנים Agentic AI, מוצרי SaaS חכמים והרחבת מערכות קיימות באמצעות המלצות, חיפוש, אוטומציה והסקה. מחוץ למרכז, האתגר מתחיל בדרך כלל במקום אחר: חיבור AI למערכות ישנות, בלי להחליף את כל הסטאק ובלי להעמיס על צוות קטן.
לפי סקירה של המכון הישראלי לדמוקרטיה על פערי אימוץ בישראל, שיעור האימוץ בתל אביב עומד על כ-41%, בעוד שבמחוז ירושלים הוא סביב 4%. הסקירה מציינת גם שבתעשיות עתירות ידע האימוץ כמעט פי שלושה לעומת ייצור, מסחר ובנייה. הפער הזה משנה את המוצר עצמו, ולא רק את קצב המכירות.
מוצר שמניח תשתית נתונים מסודרת, משתמשים דוברי אנגלית ואינטגרציות מודרניות עלול להיכשל אצל הלקוחות שזקוקים לו יותר מכל.
דרישות המוצר בארגונים שאינם הייטק
ארגון מסורתי בישראל צריך מערכת שעובדת עם התשתית הקיימת, לא Demo מרשים. בתכנון פיתוח בינה מלאכותית, דרשו לפחות:
- עברית מלאה מקצה לקצה. הממשק, המסמכים, החיפוש, זיהוי הישויות והשפה הארגונית צריכים לעבוד בעברית.
- אינטגרציה למערכות Legacy. ERP ישן, מסדי נתונים לא נקיים, קובצי Excel, מסמכי PDF ונהלים ידניים הם חלק מדרישות המערכת.
- תפעול פשוט. פחות רכיבים ופחות תלות ב-GPU ייעודי מאפשרים לצוות פנימי לתחזק את המערכת.
- חוויית שימוש לא טכנולוגית. עובדים צריכים להשלים משימה מהר יותר, בלי ללמוד מונחים חדשים או לנסח Promptים.
התאימו את הארכיטקטורה ליכולת ההטמעה, לא רק ליכולת הפיתוח. הבחירה בין Web App ב-React, אפליקציית מובייל, שכבת API ב-Node.js או Backend ב-Python קובעת מי יוכל להשתמש במוצר, מי יתמוך בו ואילו סיכוני פרטיות, אבטחה ואחריות יישארו לאחר העלייה לייצור.
ארבע שאלות החלטה לפני שמתחילים פרויקט פיתוח בינה מלאכותית
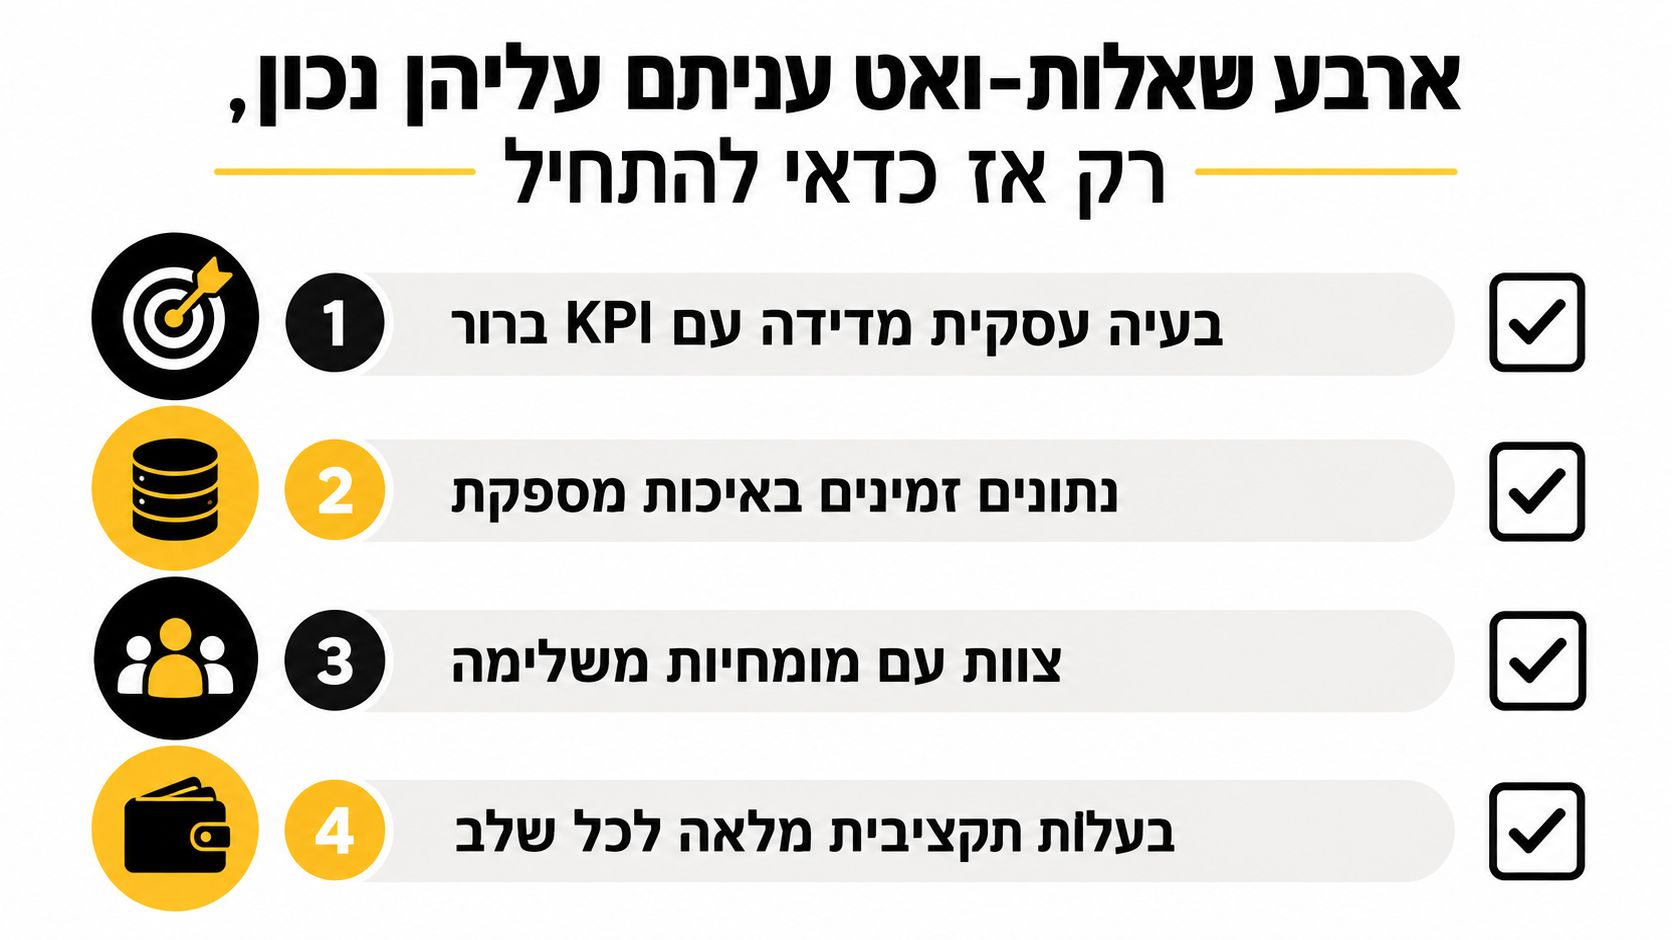
פרויקט AI לא מתחיל בבחירת מודל. הוא מתחיל בהחלטה עסקית שאפשר לבדוק. הנהלה שמכריזה על “עשיית AI” בלי להגדיר בעיה, נתונים, אחריות ויכולת הפעלה, מייצרת בדרך כלל אבטיפוס מרשים שלא שורד את המעבר לייצור. אם אחת מארבע השאלות נשארת עמומה, עוצרים לפני שמקצים צוות ותקציב.
1. האם קיימת בעיה עסקית שאפשר למדוד?
“נבנה עוזר חכם” הוא תיאור של פתרון, לא של צורך. הבעיה צריכה להופיע בתהליך הקיים: זמני מענה ארוכים, טעויות במסמכים, עומס במוקד או תהליך חיתום שמתעכב.
הגדירו KPI אחד לפני כתיבת הקוד. אפשר לבחור קיצור זמן טיפול, שיפור איכות הסיווג או הפחתת עבודה ידנית. חמישה יעדים בשלב הראשון יפזרו את הצוות ויקשו לקבוע אם המערכת באמת עובדת.
2. האם הדאטה זמין, נגיש ובאיכות מספקת?
בארגונים ישראליים המידע מפוזר לעיתים בין SharePoint, מסדי נתונים ישנים, קבצים סרוקים ודוחות ללא תיוג. בארגונים שאינם הייטק, במיוחד מחוץ למרכז, הבעיה כוללת גם הרשאות לא ברורות, תהליכים ידניים ותלות בעובדים שמכירים את המידע בעל פה.
בדקו מי הבעלים של כל מקור, מי רשאי להשתמש בו, איך מנקים אותו ואיך מודדים את איכותו לאורך זמן. מנוע המלצות, מערכת Retrieval ומודל סיווג דורשים תהליך נתונים מתועד, לא תיקייה גדולה של קבצים.
כלל מעשי: אם אינכם יכולים לשלוף דגימה אמיתית של הנתונים בתוך ימים ספורים, אתם עדיין בפרויקט דאטה. אל תציגו אותו כפיתוח בינה מלאכותית.
3. האם יש צוות שמכסה את כל שכבות הפרויקט?
מפתח Python חזק אינו מחליף Data Engineer. Data Scientist אינו מחליף Product Owner, ו-CTO אחד לא צריך לנהל לבדו ארכיטקטורה, ספקים, ניסויים, אבטחת מידע ותפעול.
בחרו את מבנה הצוות לפי מה שחסר בפועל. צוות פנימי מתאים כשיש ידע דומייני וזמן לתחזוקה. Team Extension או CTO as a Service מתאימים כשצריך לחבר במהירות בין הצד העסקי להנדסי. בישראל המחסור בכישורי AI ייעודיים מחייב לשלב בין In-house לספקים חיצוניים, במקום להמתין לגיוס מושלם.
4. האם התקציב כולל הפעלה, ולא רק בנייה?
AI אינו Feature חד-פעמי. לאחר ה-MVP מגיעות עלויות inference, ניטור, אחסון, אבטחה, תיוג, שיפור מודלים ותמיכה. ארגון בפריפריה או חברה שאינה הייטק חייבים לבחון גם מי יתחזק את המערכת ביום שבו הספק או המפתח המקורי אינם זמינים.
התחילו רק כאשר מתקיימים ארבעה תנאים:
- בעיה עסקית עם יעד ברור
- דאטה נגיש ובר-בדיקה
- בעלים לכל שכבה בפרויקט
- תקציב לפיתוח ולהפעלה
אם תנאי אחד חסר, דחו את הפיתוח. זה זול יותר ממערכת שלא תעבור לייצור, או שתיצור בהמשך סיכון תפעולי, רגולטורי ואתי.
בחירת מודלים וארכיטקטורות בעידן ה-AI היוצר
בחירת מודל היא לא מבחן ידע טכנולוגי. היא החלטת trade-off. מהירות מול שליטה, איכות מול פרטיות, עלות מול תחזוקה. מי שמדלג ישר לשאלה "איזה מודל הכי טוב" שואל את השאלה הלא נכונה.
בפועל, רוב פרויקטי פיתוח בינה מלאכותית נופלים לאחת משלוש קבוצות. לכל קבוצה יש מקום, ולכל אחת יש מחיר.
שלוש קבוצות המודלים שצריך להכיר
| השוואת שלוש קבוצות מודלים בפיתוח AI | |||
|---|---|---|---|
| קבוצת מודלים | יתרון מרכזי | חיסרון מרכזי | מתי זה משתלם |
| מודלים מאומנים מראש דרך API | מהירות יציאה גבוהה מאוד ופחות עומס הנדסי | פחות שליטה, תלות בספק, ואתגרי פרטיות ו-Data Residency | כשצריך MVP, עוזר פנימי, או יכולת טקסטואלית מהירה למוצר Web או SaaS |
| מודלי קוד פתוח קלים בפריסה פרטית | שליטה טובה יותר בנתונים, בפרומפטים ובסביבת ההרצה | תפעול מורכב יותר, צורך בתשתית ובאופטימיזציה | כשצריך עברית טובה, Private Deployment, או חיבור למידע רגיש |
| מודלים שמאומנים מאפס או מותאמים עמוק לדומיין | התאמה גבוהה מאוד למשימה ספציפית | יקר, איטי ודורש דאטה חזק וצוות בשל | כשיש בעיה ליבתית שמייצרת ערך עסקי ברור ושאין לה פתרון גנרי סביר |
מתי API הוא הבחירה הנכונה
אם אתם בונים MVP, פורטל שירות, או שכבת AI לתוך מערכת קיימת, API של מודל מאומן מראש הוא לרוב הבחירה הנכונה. אתם מקבלים זמן פיתוח קצר יותר, צוות קטן יותר, ויכולת לבדוק מהר אם המשתמשים בכלל צריכים את היכולת הזו.
אבל זו בחירה טובה רק אם הרגולציה מאפשרת, ואם אפשר לחיות עם תלות בספק. זה קריטי במיוחד בישראל, כי לפי הנחיות AWS ללקוחות פיננסיים בישראל, העברת מידע למדינות זרות כפופה לתקנות העברת מידע לחו"ל, שמאפשרות העברה רק למדינות עם רמת הגנה זהה או גבוהה יותר לדין הישראלי, או בתנאים חלופיים כמו הסכמה. אותו מקור גם מדגיש שהנמען הזר המקורי לא יכול להעביר הלאה מידע אישי.
מתי לבחור פריסה פרטית או התאמה עמוקה
אם אתם עובדים עם מידע אישי, רפואי, פיננסי, או רגיש תפעולית, מודל פתוח שרץ על סביבת ענן נשלטת או שרת פרטי מתחיל להיות רלוונטי יותר. לא כי הוא "טוב יותר", אלא כי הוא נותן שליטה.
לארגונים עם דרישות ריבונות מידע, יש פתרונות תשתיתיים שכדאי להכיר. Google Cloud Assured Workloads for Israel מציעה לישראל בקרות של data residency ל-regions בישראל בלבד, ובגרסת Preview שפורסמה בנובמבר 2022 הוצהרה גם שליטה קריפטוגרפית באמצעות customer-managed encryption keys.
הבחירה בארכיטקטורה צריכה להתחיל משאלת המידע. רק אחר כך שואלים איזה מודל ירוץ מעליו.
אימון מאפס הוא כבר סיפור אחר. זה מתאים רק כשהדומיין מספיק ייחודי, כשהנתונים באמת בבעלותכם, וכשברור למה מודל גנרי לא יספיק. בהרבה מקרים, Fine-tuning קל או Retrieval טוב ייתנו תוצאה עסקית טובה יותר בפחות סיכון.
תשתיות, MLOps והמעבר מקוד לעולם ה-Orchestration
הטעות הכי נפוצה אצל צוותי פיתוח חזקים היא לחשוב שמערכת AI היא "עוד שירות Backend". היא לא. שירות Web ב-React, Node.js ו-PostgreSQL אפשר לתחזק עם CI/CD סטנדרטי, Observability סביר, ו-DevOps מסודר. מערכת AI חיה מתנהגת אחרת. היא תלויה בנתונים, בגרסאות מודל, ב-Feature pipelines, ובביצועים שמשתנים גם בלי ששיניתם שורת קוד.
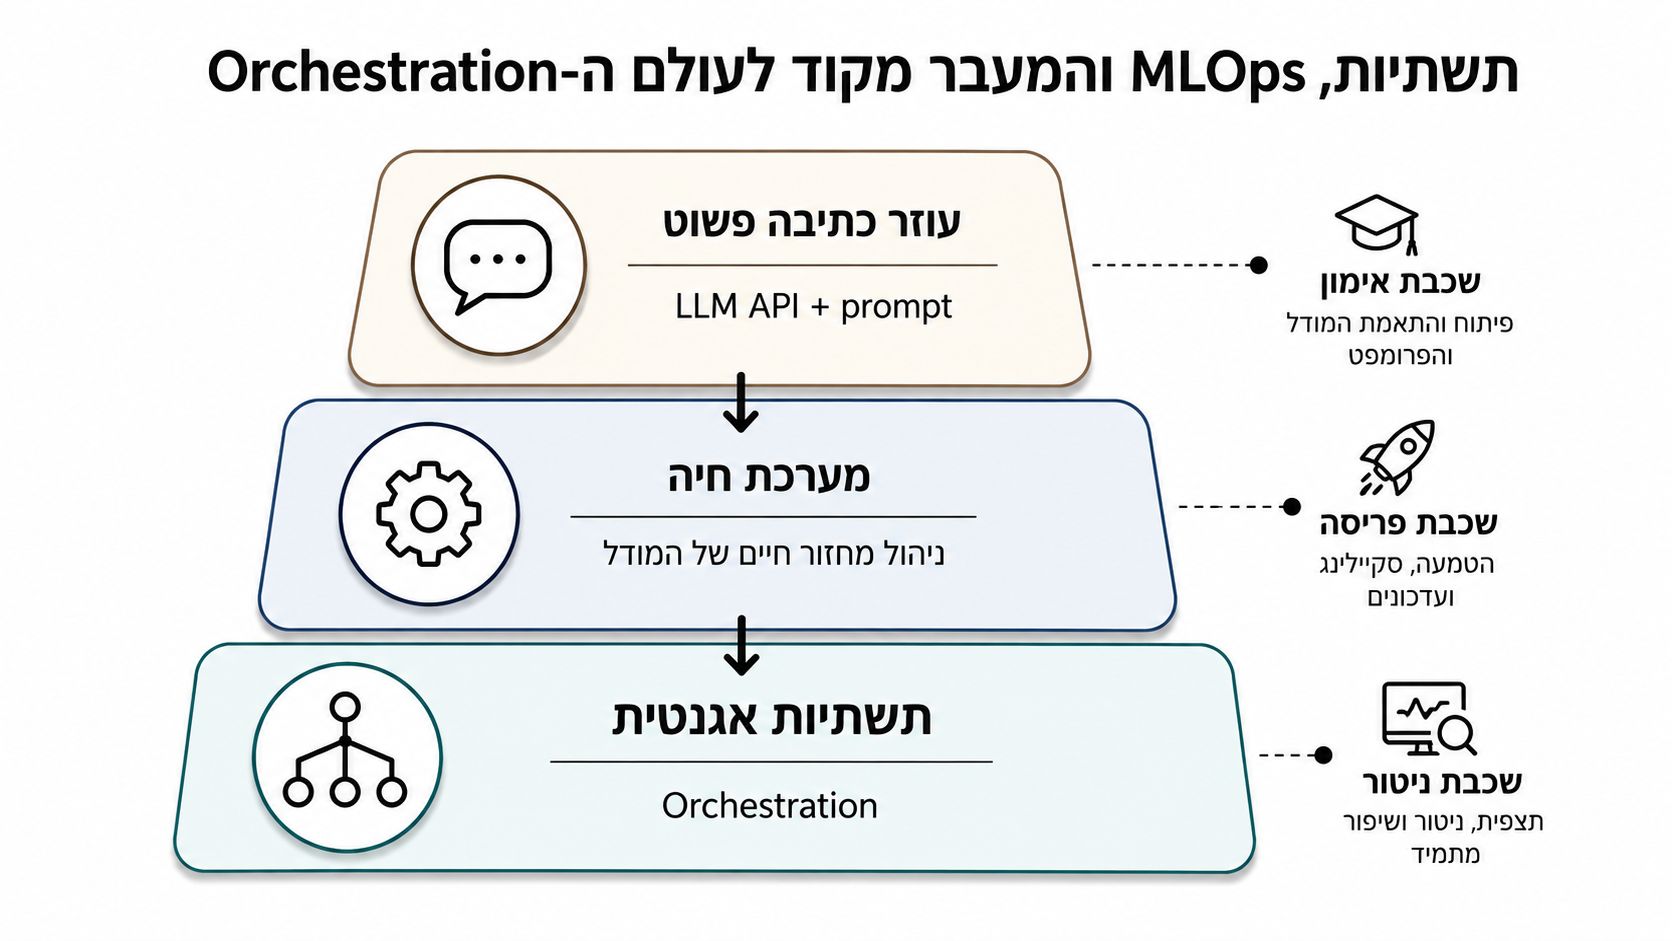
עוזר כתיבה הוא לא מערכת אג'נטית
עוזר כתיבה פשוט יכול לעבוד מצוין עם LLM API, Prompt template, לוגים בסיסיים, ו-Rate limiting. זה מוצר לגיטימי. אל תבנו לו מכונת מלחמה תשתיתית.
מערכת אג'נטית היא חיה אחרת. ברגע שיש כמה שלבים, כלים חיצוניים, החלטות ביניים, גישה למסמכים, ופעולות מול מערכות ארגוניות, אתם כבר בעולם של Orchestration. שם צריך לנהל זרימות, הרשאות, retries, fallbacks, observability, ומדיניות ברורה מתי המערכת פועלת אוטומטית ומתי אדם מאשר.
ארבע שכבות שאסור לדלג עליהן
- שכבת הדאטה והאימון. ניהול datasets, versioning, feature serving, והרצה חוזרת. כלים כמו MLflow ו-Feast נכנסים כאן באופן טבעי.
- שכבת inference. פריסה, latency budgets, תורי משימות, caching, batching, והפרדה בין שימוש אינטראקטיבי לעיבוד אצווה.
- שכבת ניטור. איכות תשובות, drift, hallucinations, עלויות, ושגיאות אינטגרציה. בלי זה, אתם עיוורים.
- שכבת delivery. CI/CD למודלים, פרמטרים ונתונים. לא רק לקוד האפליקטיבי.
מערכת AI שלא נבנתה עם גרסאות לדאטה, לקוד ולמודל תהפוך מהר מאוד ל-monolith שאף אחד לא יודע לתקן בביטחון.
איפה זה פוגש כלים מודרניים
במערכות מורכבות, Kubernetes עם GPU pools עדיין רלוונטי כשצריך שליטה טובה בפריסה ובסקייל. ב-GCP אפשר לנהל חלק מהמחזור הזה עם Vertex AI. עבור זרימות Agentic, כלים כמו LangGraph מתאימים כשצריך להגדיר מסלולי החלטה, זיכרון, וחיבור לכלים. אין צורך לרוץ לכל זה ביום הראשון, אבל כן צריך לתכנן לאן המערכת תתפתח.
אם אתם בוחנים איך צוותים כותבים על תשתיות, ארכיטקטורה והטמעת יכולות חדשות במוצרים, שווה לעיין גם בבלוג הטכנולוגיה של מיסטרביט. לא בשביל לבחור ספק, אלא כדי לראות איך נראית חשיבה מוצרית כשהיא מתחברת לפיתוח בפועל.
בפרויקטים של SaaS, אפליקציות Web, ומערכות פנים ארגוניות, ההבדל בין אבטיפוס למערכת אמינה לא עובר דרך עוד Prompt. הוא עובר דרך MLOps רציני.
דוגמאות מהשוקה מקומי שמראות למה אין מודל אחד שמתאים לכולם
אותה מילה, "AI", מסתירה שלושה עולמות שונים לגמרי. לכן שיחה על פיתוח בינה מלאכותית בלי הקשר עסקי היא כמעט תמיד שיחה שטחית.
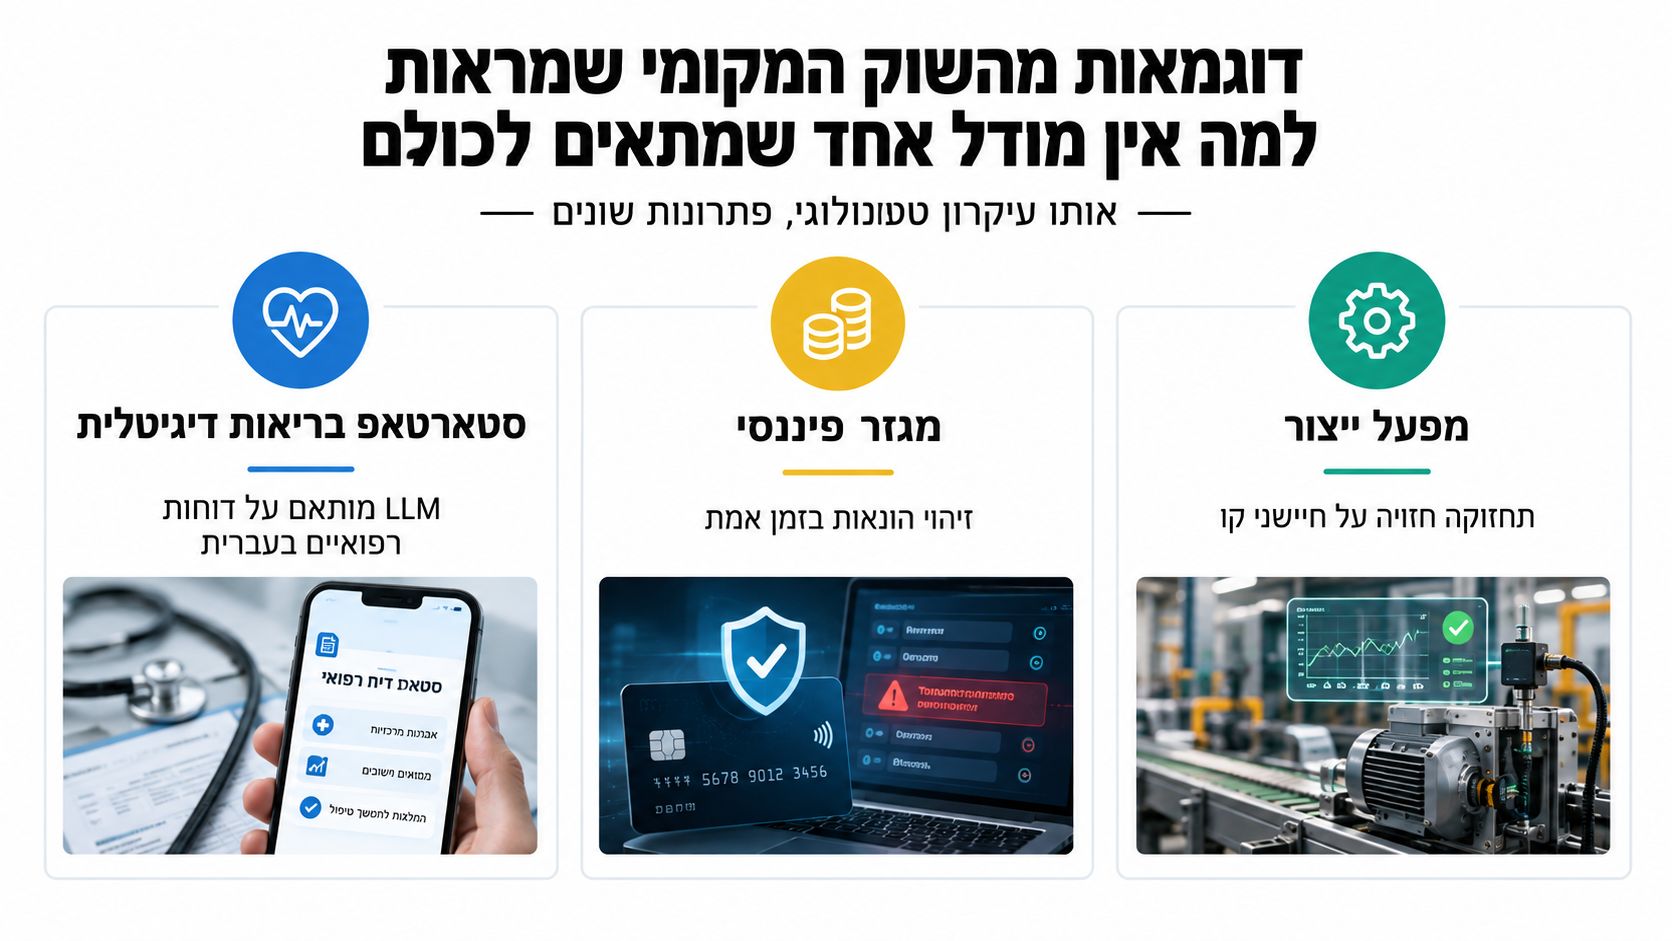
בריאות דיגיטלית
סטארטאפ בריאות שבונה מוצר סביב דוחות רפואיים בעברית לא יכול להסתפק במודל כללי וב-UI נחמד. הוא צריך הבנה של שפה מקצועית, זהירות בהסקת מסקנות, ו-Workflow שבו אדם מאשר תוצרים רגישים.
בתרחיש כזה, Retrieval על מסמכים מאומתים או התאמה ממוקדת לדאטה מתויג יכולים להיות נכונים יותר ממודל ענק "חכם" יותר על הנייר. המלכודת שנחסכת כאן היא אשליית האוטומציה המלאה. במוצרים רפואיים, Human-in-the-loop הוא לא פשרה. הוא חלק מהארכיטקטורה.
ייצור ותעשייה
מפעל ייצור בצפון מחפש בדרך כלל משהו אחר לגמרי. לא צ'אט, לא סיכום מסמכים, ולא עוזר מכירות. הוא צריך זיהוי פגמים, תחזוקה חזויה, או ניתוח חיישנים בתנאים של זמן אמת וקו ייצור.
במקום כזה, מודל ראייה ממוחשבת קל שרץ קרוב למכונה יכול להיות החלטה הרבה יותר טובה ממערכת ענן מסובכת. הפשרה ברורה. פחות גמישות, יותר יציבות תפעולית. זו פשרה נכונה.
פינטק ורגולציה
חברת פינטק צריכה שליטה הדוקה. חיפוש חכם במסמכי רגולציה, סיווג בקשות, או ניתוח התנהגות חריגה דורשים guardrails, auditability, ולפעמים גם data residency קשיח.
שם הארכיטקטורה נראית אחרת. פחות "בואו ננסה", יותר מדיניות. פחות חופש למודל, יותר גבולות. מי שבונה בתחום הזה צריך לחשוב כמו מהנדס תוכנה, כמו איש מוצר, וכמו DPO באותה נשימה.
למי שמחפש שותף לפיתוח תוכנה מותאם, חיזוק צוותי פיתוח, או הקמה של מערכות AI בתוך ארגון, האתר של מיסטרביט מציג את סוגי השירותים הרלוונטיים, כולל פיתוח Web, Mobile, SaaS ו-AI.
הערכה, מדדים ומעבר מ-POC לייצור
רוב ה-POC-ים לא נכשלים כי המודל חלש. הם נכשלים כי אף אחד לא הגדיר מראש מה נחשב הצלחה. "זה נראה טוב" הוא לא מדד. "המשתמשים אהבו" זה פידבק, לא gate לייצור.
ארבע שכבות ההערכה לפני מעבר לייצור
| ארבע שכבות ההערכה לפני מעבר לייצור | ||
|---|---|---|
| שכבת הערכה | מדדים עיקריים | סף מעבר מינימלי |
| דיוק טכני | Recall, Precision, F1, BLEU, Faithfulness, או מדד אחר שמתאים למשימה | הגדרה מראש של מדד מרכזי אחד לפחות, עם baseline ברור מול תהליך קיים |
| הטיות והוגנות | בדיקה על קבוצות מיוצגות חלש, עקביות תוצאות, פערי שגיאה בין סוגי קלט | אין פער קריטי לא מוסבר בין קבוצות או סוגי שימוש עיקריים |
| עלות תפעול | עלות inference, צריכת GPU או API, caching, אחסון, ניטור | המערכת עומדת במסגרת תקציב שהוגדרה לפני העלייה לייצור |
| השפעה עסקית | זמן טיפול, שיעור אישור, עומס על צוות, איכות תוצר, או KPI עסקי אחר | שיפור מדיד מול baseline ידני או מול המערכת הנוכחית |
למה Accuracy לבד מטעה
במשימות אמיתיות, Accuracy הוא לפעמים המדד הכי פחות חשוב. במערכת לזיהוי חריגות, Recall עשוי להיות קריטי יותר. במערכת תשובות מבוססת מסמכים, Faithfulness חשוב יותר משטף ניסוח. בסיווג בקשות לקוח, Precision יכול לחסוך טעויות תפעוליות יקרות.
תבחרו את המדד לפי הנזק של טעות, לא לפי מה שקל להציג במצגת.
פרויקט AI צריך gate לייצור כמו כל מערכת קריטית אחרת. אם אין תנאי מעבר כתובים, אין באמת מעבר. יש הימור.
צ'ק ליסט מעבר אמיתי לייצור
לפני עלייה לייצור אני מחפש תשובות קצרות וברורות לשאלות הבאות:
- עומסים צפויים. האם בדקתם מה קורה כשיש הרבה בקשות במקביל.
- SLA וסבילות לכשל. מה זמן התגובה הסביר, ומה קורה אם השירות החיצוני נופל.
- Rollback. איך חוזרים לגרסה קודמת של מודל, פרומפט או pipeline.
- תיעוד תפעולי. האם אנליסט, Support, ו-DevOps מבינים מה המערכת עושה.
- תקציב Drift. מי בודק הידרדרות ביצועים, באיזו תדירות, ומה עושים כשזה קורה.
המעבר מ-POC לייצור הוא לא תאריך בלוח שנה. הוא שער. מי שעובר אותו בלי תהליך מסודר, משלם אחר כך בריביות.
סיכונים רגולטוריים ואתיים שצריך להכיר לפני שמתחילים
הסיכון הגדול ביותר בפיתוח בינה מלאכותית בישראל הוא לא שהמודל יטעה. הסיכון הגדול הוא שתבנו משהו שעובד, ואז תגלו שאי אפשר להפעיל אותו כחוק, או שאי אפשר להגן עליו עסקית.
הרגולציה נכנסת הרבה לפני ההשקה
בישראל אין כיום חוק ייעודי כללי שמסדיר בינה מלאכותית, והגישה הרגולטורית היא סקטוריאלית. במאי 2025 פרסמה רשות הגנת הפרטיות טיוטת הנחיות ליישום חוק הגנת הפרטיות על מערכות AI, כולל דרישות לשקיפות, הסכמה מדעת, הערכות השפעה על פרטיות, והגבלות על web scraping לאימון מודלים לפי הסקירה של White & Case על הרגולציה בישראל.
בנוסף, תיקון 13 לחוק הגנת הפרטיות אושר באוגוסט 2024 ונכנס לתוקף ב-14 באוגוסט 2025. לפי סקירת דיני הגנת הפרטיות בישראל ב-ICLG, התיקון מחזק משמעותית את סמכויות האכיפה של רשות הגנת הפרטיות, כולל חקירה, פיקוח וקנסות. כל מערכת AI שמעבדת מידע אישי צריכה לקחת את זה בחשבון כבר באפיון.
מה חייב להיכנס למסמך האפיון
- הסכמת שימוש ושקיפות. המשתמש צריך להבין מה המערכת עושה עם הנתונים שלו.
- Human-in-the-loop. במערכות רגישות צריך להגדיר מתי אדם מאשר, מבטל, או מתקן.
- יומן החלטות מודל. לא רק לוגים טכניים, גם עקבות החלטה שאפשר לבדוק בדיעבד.
- מדיניות דאטה. מה נאסף, איפה נשמר, מי ניגש, ומה יוצא מחוץ לישראל.
הדיון ב-EU AI Act משפיע גם על חברות ישראליות שמוכרות לאירופה, כי לקוחות אירופיים מצפים לסיווג סיכונים, בקרה, ותיעוד. גם אם אתם לא מחויבים ישירות בכל סעיף, השוק כבר דורש בשלות.
הצד האתי הוא לא קישוט
הטיות פוגעות קודם כל באוכלוסיות שכבר מיוצגות פחות. בישראל זה מתבטא גם בפערי שפה, גם בפערים גיאוגרפיים, וגם בהבדלים בין מגזרים וענפים. אם אתם מאמנים או בודקים מערכת רק על דאטה "נקי" מתל אביב, אל תתפלאו כשהיא לא מתפקדת טוב בארגון בפריפריה.
ציות הוא לא בלם. בשוק האירופי ובשווקים רגישים, הוא נכס מכירתי. לקוח שמבין שבניתם מוצר עם פרטיות, בקרה והוגנות מראש, סומך יותר מהר.
רשימת החלטות מעשית לפני שמתחילים לפתח
מי שרוצה להתחיל נכון צריך להפסיק לחשוב על פרויקט AI כעל "יוזמת חדשנות" ולהתחיל לנהל אותו כמו מוצר. עם החלטות, בעלי תפקידים, מגבלות, ויעדים.
בשבוע הראשון
תעשו שלושה דברים בלבד:
- תבחרו בעיה אחת. לא "AI לארגון", אלא צוואר בקבוק אחד עם משמעות עסקית.
- תמפו מקורות נתונים קיימים. מה קיים, מה נגיש, מה חסר, ומה רגיש.
- תבצעו בדיקת התאמה רגולטורית ראשונית. לפני שכותבים Prompt ראשון.
אם אתם לא מסוגלים לנסח את הבעיה במשפט אחד, אל תעברו הלאה.
בחודש הראשון
כאן מתחילים לעבוד ברצינות. מקימים צוות מינימלי עם בעל מוצר, יכולת Data Engineering, ויכולת מודלים או אינטגרציה. בוחרים סביבת ניסוי בענן, מגדירים גבולות אבטחה, ומשווים שני כיווני פתרון לפחות.
ההשוואה הזו חשובה. למשל API מול פריסה פרטית. Retrieval מול Fine-tuning. Web App פנימי מול שילוב בתוך מערכת קיימת. אל תתאהבו בפתרון הראשון. תנו לו להתחרות.
עדיף POC צר עם שני פתרונות מתחרים מאשר חזון רחב עם אפס תנאי החלטה.
ברבעון הראשון
המטרה היא לא "להוכיח שאפשר". המטרה היא להחליט אם כדאי. לכן ברבעון הראשון צריך להגיע ל-POC עם:
- מדדי הצלחה מוגדרים מראש
- בדיקות בסיסיות להטיות ולשגיאות
- תכנון MLOps ראשוני
- תיק רגולטורי מסודר
- החלטה אם ממשיכים לייצור, משנים כיוון, או עוצרים
במונחים הנדסיים, זה השלב שבו בוחנים אם לבנות מערכת מותאמת ב-Python ו-Node.js, ממשק ב-React או Vue, שכבת API מסודרת, ותהליך DevOps שמתאים למודל חי. במונחים עסקיים, זה השלב שבו מפסיקים לדבר על AI כמילת באזז ומתחילים לנהל אותו כמו השקעה.
ההמלצה שלי פשוטה. תבחרו בעיה אחת, תגבילו תקציב, ותתחילו בתוך 30 יום. לא עם פרויקט ענק, אלא עם מסלול החלטה ברור. זו הדרך היחידה להגיע לפיתוח בינה מלאכותית שבאמת מחזיק בייצור.
מיסטרביט מלווה ארגונים וסטארטאפים בפיתוח תוכנה מותאם, הקמת מוצרי AI, חיזוק צוותי פיתוח, וליווי טכנולוגי משלב האפיון ועד ייצור. אם אתם צריכים לבחון ארכיטקטורה, להקים MVP, להטמיע יכולות AI במערכת קיימת, או להרחיב צוות עם מומחים רלוונטיים, אפשר להתחיל משיחה עניינית דרך מיסטרביט.