Multi Tenant Architecture: מדריך מלא לפיתוח SaaS מודרני
המערכת שלכם כנראה עובדת מצוין כרגע. יש לקוח ראשון, אולי כמה עשרות משתמשים, והצוות מתקדם מהר עם React בצד הלקוח, Node.js או Python בצד השרת, ודיפלוימנט אחד בענן. ואז מגיעים עוד לקוחות, עוד אינטגרציות, עוד הרשאות, ופתאום כל שינוי קטן מרגיש מסוכן. בקשה פשוטה ללקוח אחד גוררת branching, feature flags, טבלאות חריגות, ולפעמים אפילו סביבה נפרדת.
זה השלב שבו הרבה מוצרי SaaS מגלים שהבעיה שלהם אינה רק סקייל של תעבורה. הבעיה היא מודל ההפעלה. אם כל לקוח דוחף את המערכת לכיוון אחר, ואם כל בקשה צריכה "לזכור" למי הנתון שייך, אתם כבר לא מתמודדים רק עם פיתוח תוכנה בהתאמה אישית. אתם בונים פלטפורמה שצריכה לשרת כמה ארגונים במקביל בלי לבלבל ביניהם, בלי להדליף מידע, ובלי להפוך כל deploy לאירוע.
בישראל השאלה הזאת חדה במיוחד. ברגע שמערכת SaaS שומרת מידע אישי, נכנסים לתמונה לא רק ביצועים ו־DX אלא גם פרטיות, audit, מיקום נתונים, ותיעוד של גישות חריגות. לכן multi tenant architecture הוא לא רק דפוס תכנון של CTOs. זו החלטה עסקית, מוצרית ורגולטורית.
תוכן עניינים
- למה רוב הסטארטאפים נכשלים בשלב הצמיחה
- מהי ארכיטקטורת מולטי טננט
- מודלי בידוד מרכזיים – השוואה ועד כמה הם שונים
- אתגרי אבטחה ומגבלות רגולטוריות
- שיקולי ביצועים וניטור במערכת מרוכזת
- מתי לשקול מעבר ל־Enterprise Private Cloud
- סיכום והמלצות ליזמים ומוצרי SaaS
למה רוב הסטארטאפים נכשלים בשלב הצמיחה
הכשל לא מתחיל כשיש "הרבה מדי משתמשים". הוא מתחיל הרבה קודם, כשבוחרים פתרון שעובד ללקוח הראשון אבל לא למוצר. צוותים רבים מתחילים עם מונולית אחד ועם הנחה סמויה: אם לקוח גדול יגיע, נפתח לו סביבת Enterprise נפרדת בהמשך. בינתיים, כולם חולקים את אותו backend, את אותן טבלאות, ואת אותו קוד הרשאות.
זה נשמע סביר. גם בפועל זה עובד בשלבים מוקדמים. הבעיה היא שהחוב הארכיטקטוני מצטבר דווקא באזורים שלא רואים בדמו. query אחד בלי סינון נכון, job שרץ בלי tenant context, cache key כללי מדי, export שנכתב מהר מדי. כל אלה לא שוברים MVP, אבל הם שוברים אמון כשמתחילים למכור לארגונים.
מה קורה אחרי החודש הראשון של צמיחה
בשלב הראשון הצוות מתמקד במהירות. זה הגיוני. רוצים לסגור design partners, לבנות flow, להוכיח ערך. אבל כשמגיע הלקוח השני עם דרישות SSO, הלקוח השלישי עם role model אחר, והלקוח הרביעי עם צורך ב־audit trail, הארכיטקטורה מתחילה לחשוף פערים.
בדרך כלל רואים אחד משלושה סימנים:
- התאמות פר לקוח בקוד. תנאים כמו
if customer === ...מתחילים להופיע ב־frontend וב־backend. - העתקת תשתיות. במקום לבנות בידוד נכון, מקימים עוד instance ועוד database כדי "לקנות זמן".
- אובדן ודאות. הצוות כבר לא בטוח אם endpoint חדש באמת מבודד בין לקוחות.
מערכת שלא הופכת את גבולות הדייר לחלק מהמודל שלה, תאלץ את המפתחים לזכור את הגבולות האלה בכל שורה. זו שיטה שלא מחזיקה זמן.
למה זו לא רק בעיית עלות
רבים מציגים multi-tenant architecture כחיסכון. זה נכון, אבל חלקי. הבעיה המרכזית היא ניהול מורכבות. כשכל לקוח מקבל וריאציה אחרת של המערכת, ה־CI/CD מסתבך, הבדיקות מתפצלות, ותחזוקה של Web, mobile ו־APIs נהיית יקרה מנטלית גם אם חשבון הענן עדיין סביר.
במוצרים שגדלים מהר, נכון יותר לשאול שאלה אחרת: האם הוספת לקוח חדש היא פעולה מוצרית פשוטה, או פרויקט תשתיתי? אם onboarding של ארגון חדש דורש שיבוט environment, שינויי secrets, ושכפול pipeline, אתם כבר בכיוון בעייתי.
מי שמפתח מוצר SaaS, MVP או פלטפורמה עסקית בענן צריך לחשוב מוקדם על tenant model, הרשאות, וגבולות בידוד. זו בדיוק העבודה הארכיטקטונית שצוותים עושים כשניגשים לפרויקט מורכב דרך מיסטרביט, לצד פיתוח, ליווי CTO as a Service או חיזוק צוותי פיתוח.
מהי ארכיטקטורת מולטי טננט
ארכיטקטורת מולטי טננט היא מודל שבו כמה לקוחות משתמשים באותה מערכת יישומים ובאותה תשתית לוגית, אבל כל לקוח רואה רק את הנתונים, ההרשאות וההגדרות שלו. זה הבסיס של הרבה מערכות SaaS מודרניות, בין אם הן נבנו ב־Node.js, Python, Java או סביב שירותי AWS, Azure ו־GCP.
הדרך הפשוטה להבין את זה היא בניין משרדים. כולם משתמשים באותו מבנה, באותן מעליות ובאותה תשתית חשמל, אבל לכל חברה יש משרד משלה, מפתחות משלה, והרשאות גישה שונות. בעולם התוכנה, "המשרד" הזה יכול להיות schema, database, namespace, או context לוגי שעובר בכל בקשה.
לפי פרסום הלשכה המרכזית לסטטיסטיקה על רכישת שירותי מחשוב ענן בישראל, 44.6% מהעסקים בישראל רכשו שירותי מחשוב ענן, מה שמאפשר אומדן של אימוץ טכנולוגיות מודרניות כמו Multi-Tenancy.
איפה הארכיטקטורה הזאת פוגשת את הקוד
Multi tenant architecture לא מתחילה ב־database. היא מתחילה בהחלטה שכל אובייקט עסקי שייך לדייר מסוים. אם יש לכם users, projects, invoices, tickets או documents, כל אחד מהם צריך להיות משויך ללקוח, לארגון או ל־workspace ברור.
בפועל זה אומר:
- זהות דייר בכל בקשה. ה־tenant חייב להגיע מ־token מאומת, subdomain או mapping אחר שנשלט בשרת.
- אכיפה בשכבת ההרשאות. לא מספיק להסתיר מידע ב־React, Angular או Vue. השרת חייב לאשר כל read, write, export ו־delete.
- גישה עקבית לנתונים. repositories, services ו־ORM queries צריכים לעבוד עם tenant scope כחלק מה־API הפנימי שלהם.
למה ההגדרה התאורטית לא מספיקה
מבחוץ, הרבה מערכות נראות multi-tenant כי יש להן עמודת tenant_id. בפועל, זה רק רמז. מערכת באמת רב דיירית היא מערכת שבה קשה לכתוב קוד שעוקף את הגבול הזה בטעות.
כלל מעשי: אם אפשר לכתוב endpoint חדש בלי tenant context חובה, המערכת שלכם עדיין לא בנויה נכון למולטי טננט.
המשמעות רחבה יותר מפיתוח backend. היא משפיעה על caching, queues, observability, mobile APIs, BI exports, ואפילו על שכבות AI. אם הוספתם Agentic AI או מנוע embeddings למוצר, גם שם כל מסמך, שיחה או action צריכים לרוץ תחת הקשר דייר ברור.
מודלי בידוד מרכזיים – השוואה ועד כמה הם שונים
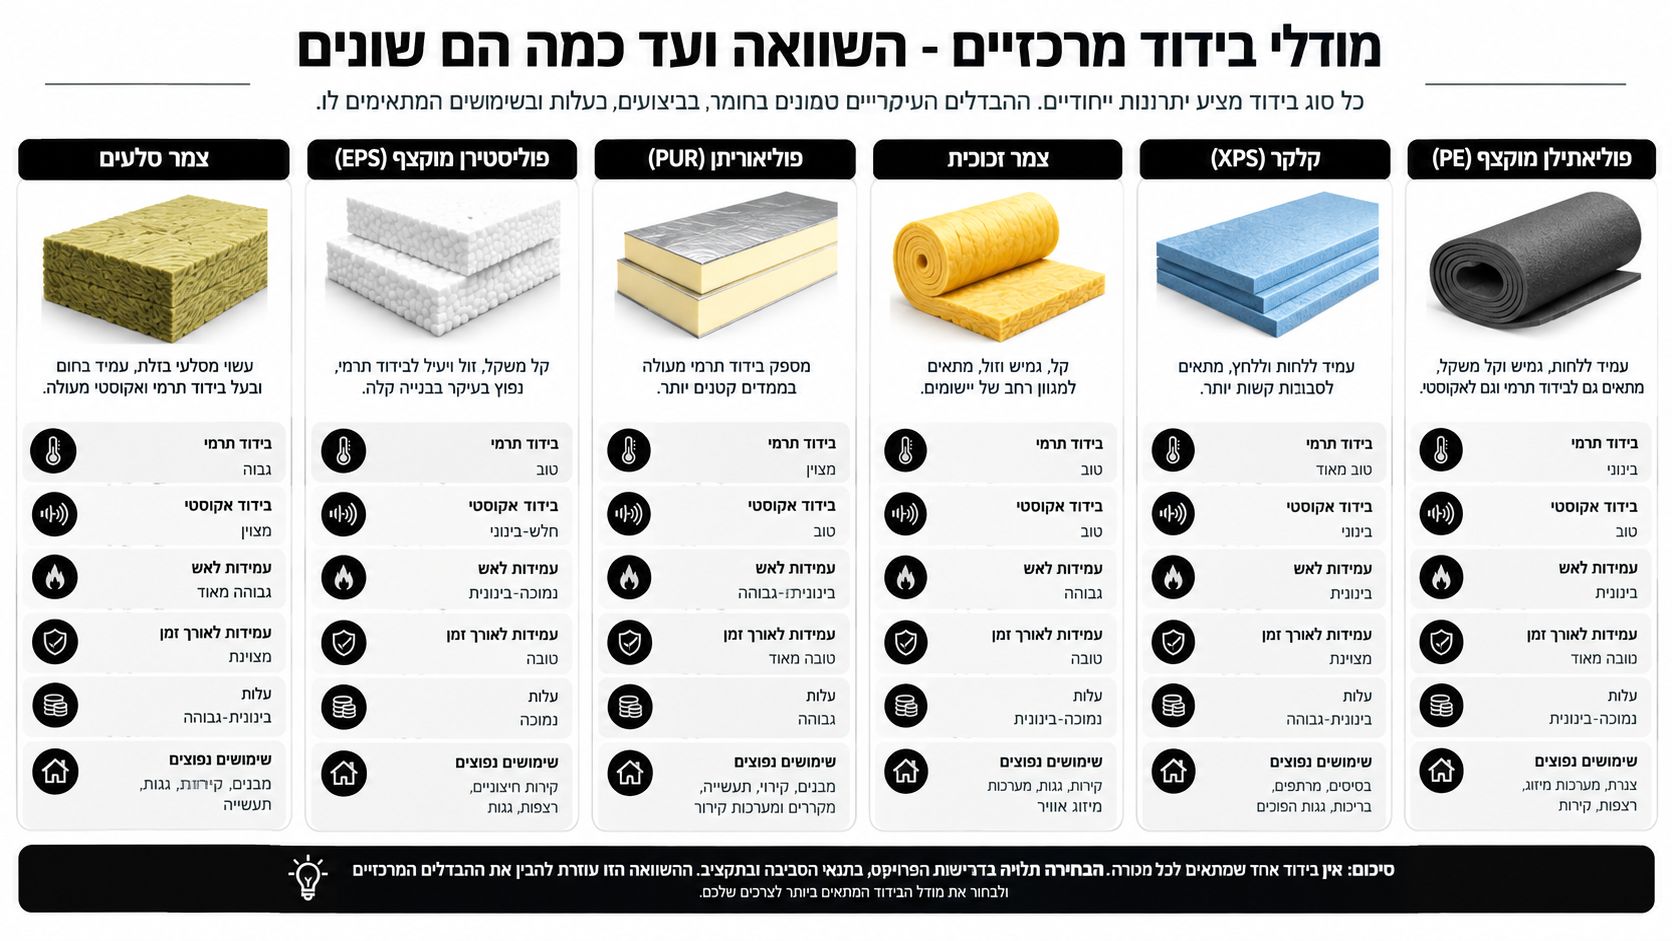
יש שלושה מודלים נפוצים לבידוד דיירים. אף אחד מהם לא "הנכון" תמיד. הבחירה תלויה במוצר, ברגישות המידע, במורכבות התפעולית ובשאלה אם אתם בונים MVP מהיר או פלטפורמה שכבר מוכרת ל־Enterprise.
שלושת המודלים בפועל
Database per Tenant הוא המודל המבודד ביותר. לכל לקוח יש מסד נתונים נפרד, ולעיתים גם instance או cluster נפרד. זה נוח כשיש דרישות קשות של פרטיות, שחזור נפרד, או התאמות עומק ללקוח מסוים. המחיר הוא תפעול: migrations, ניטור, backups, analytics ו־onboarding הופכים מורכבים יותר.
Shared Schema הוא הקצה השני. כל הלקוחות יושבים באותן טבלאות, וההפרדה נעשית לוגית דרך tenant_id, הרשאות, query scoping ו־controls נוספים. זה המודל הכי יעיל תפעולית, והוא גם הנפוץ ביותר בתחילת הדרך. מצד שני, כאן טעות קטנה בקוד יכולה להפוך לדליפת מידע בין דיירים.
Shared Database with Isolated Schema יושב באמצע. כל הלקוחות באותו database, אבל כל אחד בסכמה נפרדת. זה מספק בידוד חזק יותר ממודל shared schema, בלי עלות מלאה של database נפרד לכל לקוח. המחיר הוא שכבת migrations וניהול metadata מורכבת יותר.
השוואת מודלי בידוד דיירים
| מודל | רמת בידוד | עלות תפעול | רגולציה |
|---|---|---|---|
| Database per Tenant | גבוהה מאוד | גבוהה | מתאים יותר לדרישות מחמירות |
| Shared Schema | נמוכה עד בינונית, תלויה באכיפה | נמוכה | דורש הוכחת בידוד חזקה |
| Shared Database with Isolated Schema | בינונית | בינונית | איזון טוב בחלק מהתרחישים |
איפה רוב הצוותים טועים בבחירה
הטעות הנפוצה היא לבחור לפי גודל לקוח במקום לפי רגישות מידע ודפוסי שימוש. לקוח קטן בתחום רפואי או פיננסי עשוי לדרוש בידוד חזק יותר מלקוח גדול עם מידע פחות רגיש. גם noisy neighbour משנה את התמונה. לקוח אחד עם batch jobs כבדים, חיפוש מסמכים, או מנוע AI שעובד על הרבה מסמכים יכול להזיק לכולם גם אם הוא לא הלקוח הכי גדול.
עוד טעות היא לחשוב שהבחירה חייבת להיות קבועה. בפועל, הרבה מוצרים בריאים בנויים כהיברידיים. לקוחות רגילים יושבים במודל משותף. לקוחות רגישים או עמוסים עוברים לסכמה או למסד נפרד. זה מודל סביר, כל עוד הארכיטקטורה מאפשרת "להעביר דייר" בלי לשכתב את המוצר.
מי שרוצה להעמיק בשיקולי ארכיטקטורה דומים ימצא עוד דוגמאות וניתוחים בבלוג של מיסטרביט.
אתגרי אבטחה ומגבלות רגולטוריות
הפחד האמיתי במערכת רב דיירית אינו downtime. הוא tenant leakage. כלומר, מצב שבו משתמש של ארגון אחד רואה, מייצא, משנה או מסיק מידע של ארגון אחר. לא תמיד מדובר בפריצה מתוחכמת. לעיתים זו שאילתה אחת בלי filter נכון, קובץ export לא מבודד, cache key שגוי, או שירות AI שקיבל מסמך מההקשר הלא נכון.
לפי מדריך הרשות להגנת הפרטיות ליישום תקנות אבטחת מידע, הרשות להגנת הפרטיות מחייבת אבטחת מידע בהתאם לרמת הסיכון, ודורשת תיעוד אירועי חדירה, מיקום נתונים ובידוד מידע אישי בסביבות מרובות דיירים. מבחינה מעשית, זה משנה את השאלה מ"מה הכי נוח לפיתוח" ל"מה ניתן להוכיח, לנטר ולחקור".
tenant_id הוא לא מנגנון אבטחה
עמודת tenant_id היא רק חלק מהפתרון. אם האפליקציה סומכת על input מהלקוח, אם יש מסלול קריאה ישיר לרשומות, או אם שירות פנימי מריץ query בלי scope נכון, הבידוד נשבר. לכן נדרש סט של שכבות מצטברות:
- אימות והעברת הקשר דייר. הזהות של הדייר צריכה להגיע מ־token מאומת או מנגנון שרת מהימן.
- Authorization מרכזי. בדיקות הרשאה צריכות להתבצע בצד השרת וברמת המשאב.
- Row-Level Security או query scoping עקבי. לא כהרגל פיתוח, אלא כחלק מהתשתית.
- לוגים בלתי ניתנים לשינוי ככל שניתן. כדי שאפשר יהיה להבין מי ניגש למה ומתי.
- בדיקות שליליות. ניסיון מכוון לקרוא רשומה של דייר אחר, לייצא נתון לא מורשה, או לעקוף tenant context.
אם QA בודק רק "האם המשתמש רואה את הנתונים שלו", חסר חצי מהסיפור. צריך לבדוק גם "איך המערכת מתנהגת כשהוא מנסה לראות נתונים של מישהו אחר".
מה המשמעות בישראל עבור SaaS
בישראל, תכנון נכון מתחיל בסיווג המאגר ולא רק בבחירת AWS, Azure או GCP. אם המערכת מחזיקה מידע אישי, צריך להחליט מה רמת הסיכון, מי בעל המאגר, מי מחזיק או מעבד, אילו תתי מעבדים מעורבים, ואיך מגיבים לאירוע חריג. זו לא רק עבודה משפטית. זו ארכיטקטורה.
יש לזה גם השלכה על AI Transformation ועל Agentic AI. אם צ'אט ארגוני משתמש ב־LLM כדי לענות על שאלות מתוך מסמכים, אסור לשכבת ה־AI לעקוף את מדיניות הבידוד שקיימת ב־API. embeddings, שיחות, קבצים וכלי פעולה של agent צריכים להיות מופרדים בין דיירים בדיוק כמו טבלאות עסקיות.
בקרות שכדאי להטמיע מוקדם
- Audit trail עצמאי. לא רק application logs, אלא רישום שמאפשר חקירה.
- הפרדת מפתחות הצפנה כשנדרש. במיוחד עבור דיירים רגישים יותר.
- מדיניות גיבוי ומחיקה לפי דייר. כולל logs, אינדקסים ועותקים זמניים.
- Threat modelling לפני מכירה לארגון מפוקח. אחרת מגלים חורים מאוחר מדי.
שיקולי ביצועים וניטור במערכת מרוכזת
גם אם פתרתם בידוד מידע, נשארה בעיה אחרת: משאבים משותפים. במערכת רב דיירית לקוח אחד יכול לצרוך יותר מדי CPU, חיבורים למסד, workers, תורים או מכסות API. זו תופעת ה־noisy neighbour, והיא אחת הסיבות שמערכות נראות "לא יציבות" אף שהקוד תקין.
הביטוי שלה בשטח לא תמיד דרמטי. לפעמים זו עלייה ב־latency רק ללקוחות מסוימים. לפעמים queue של jobs שמתארך כי דייר אחד שלח הרבה מסמכים לעיבוד. לפעמים feature חדש של AI, כמו summarisation או enrichment, עובד טוב בסביבת בדיקות אבל חונק worker pool בפרודקשן.
איך בונים הוגנות תפעולית
מערכת מרוכזת צריכה להכיר כל דייר גם דרך observability. אם metrics, traces ו־logs לא מתויגים לפי tenant, אי אפשר לדעת אם יש תקלה כללית או בעיה של לקוח אחד.
כדאי ליישם כמה צעדים פשוטים יחסית:
- Rate limits לפי דייר. לא רק לפי משתמש או IP.
- תורים נפרדים או משוקללים. במיוחד ל־background jobs כבדים.
- Quota למשאבים יקרים. חיפוש, exports, OCR, עיבודי AI, webhooks.
- Composite indexes לפי tenant. כדי ששאילתות חמות לא יהפכו לסריקות רחבות.
- Dashboards פר דייר. latency, errors, עומס jobs וצריכת API.
טכניקות פיתוח שעוזרות בפועל
בצד השרת, חשוב לעצב repositories ו־services כך ש־tenant context הוא פרמטר חובה. ב־Node.js וב־Python אני מעדיף שהשכבה שמדברת עם ה־database לא תדע להריץ פעולה עסקית בלי הקשר דייר מפורש. זה לא רק עניין של סדר. זו הגנה מפני טעויות.
ב־frontend, בין אם עובדים עם React, Angular או Vue, לא כדאי לבלבל בין state של משתמש ל־state של דייר. משתמש יכול להשתייך ליותר מארגון אחד, ולכן "active tenant" צריך להיות state ברור שמשפיע על כל קריאה ל־API, על caching ועל routing.
מדידה טובה במערכת רב דיירית אינה "האם השרת בריא". המדידה היא "איזה דייר נפגע, מאיזה רכיב, ובגלל מי".
מה לא עובד לאורך זמן
מה שלא מחזיק הוא monitoring כללי מדי. CPU של cluster שלם, error rate גלובלי, ומבט על ממוצעים. ממוצעים מסתירים חריגות. דייר אחד יכול לחוות תקלה קשה בזמן שכל שאר המערכת נראית ירוקה.
גם patch נקודתי ללקוח רועש לא באמת פותר את הבעיה. אם אין isolation ברמת jobs, quotas ו־database access patterns, הבעיה תחזור עם הלקוח הבא.
מתי לשקול מעבר ל־Enterprise Private Cloud
לא כל לקוח צריך סביבה נפרדת. אבל יש נקודה שבה בידוד לוגי בלבד מפסיק להספיק. זה קורה בדרך כלל כשנכנסים לקוחות Enterprise, גופים ציבוריים, ארגונים עם רגולציה כבדה, או פרויקטים שבהם מיקום הנתונים, תתי המעבדים ותהליכי המחיקה חייבים להיות מתועדים מראש.
לפי מדיניות הממשלה לשימוש בשירותי ענן, יש מצבים שבהם מידע מסוים עשוי להיות מוגבל או אסור להעברה לענן בהתאם לסיווג, לרגישות העסקית, לדרישות פרטיות או לרגולציה החלה עליו. ההנחיה גם מחדדת ששמירת נתוני הלקוח לתקופה מוגדרת לאחר ההעברה, ושינויים מסוימים בשימוש בשירות הענן, אינם רק סעיפים חוזיים. הם אילוץ ארכיטקטוני.
מתי בידוד חזק יותר הוא החלטה נכונה
יש כמה טריגרים שחוזרים על עצמם:
- לקוח עם דרישות Data Residency. לא מספיק להגיד "אנחנו על ספק ענן מוכר".
- עומסי עבודה חריגים. למשל מנועי עיבוד מסמכים, אינטגרציות או אוטומציות עסקיות שמייצרות עומס לא צפוי.
- דרישות audit ושחזור נפרדות. לקוח שרוצה לדעת בדיוק מה נמחק, מתי, ואיך משחזרים.
- התאמות עומק. לפעמים Enterprise צריך policy engine, networking או lifecycle קצת אחר.
למה Hybrid הוא לעיתים הבחירה הבריאה
הרבה צוותים חושבים במונחים של או־או. או שכולם חולקים הכול, או שכל לקוח מקבל stack משלו. בפועל, מודל היברידי הוא לעיתים הבחירה הנבונה ביותר. דיירים קטנים ובינוניים נשארים על פלטפורמה משותפת. דיירים רגישים או כבדים עוברים ל־database נפרד, schema נפרדת, cluster נפרד, או אפילו Private Cloud.
החוכמה היא לא רק לבצע את ההפרדה, אלא להכין לה נתיב. אם tenancy הוא חלק מהדומיין, אפשר להעביר דייר בלי לשכתב את המוצר. אם tenancy "מרוח" בקוד, המעבר ל־Enterprise יהפוך לפרויקט חילוץ.
סיכום והמלצות ליזמים ומוצרי SaaS
ארכיטקטורת מולטי טננט טובה לא נמדדת בזה שהיא חסכונית. היא נמדדת בזה שהמערכת יכולה לגדול בלי לאבד שליטה. לקוח חדש לא אמור לייצר פיצול בקוד. פיצ'ר חדש לא אמור לסכן נתונים של דייר אחר. וצוות הפיתוח לא אמור לנחש בכל deploy אם הרשאות עדיין מוחלות נכון.
למי שבונה מוצר SaaS, Web platform, אפליקציית mobile מחוברת backend, או מוצר AI ארגוני, ההמלצה הפרקטית היא כזאת:
סדר עבודה נכון
- התחילו במודל פשוט אבל ממושמע. Shared model יכול להתאים ל־MVP, כל עוד tenant context נאכף מקצה לקצה.
- הכניסו בידוד לוגי חזק מהיום הראשון. authorization בצד השרת, query scoping, בדיקות cross-tenant, ו־audit אמיתי.
- בנו escape hatch ללקוחות רגישים. גם אם רוב הלקוחות ישבו יחד, ארכיטקטורה צריכה לאפשר בידוד חזק יותר בהמשך.
- מדדו לפי דייר, לא רק לפי מערכת. ניטור, rate limits ו־queues חייבים להיות tenant-aware.
- אל תתנו לשכבת AI לעקוף את החוקים. אם יש Agentic AI, embeddings, מסמכים או actions, כולם חייבים לעבור את אותו מודל הרשאות.
מערכת רב דיירית מוצלחת היא כזו שבה הדרך הבטוחה היא גם הדרך הקלה ביותר למפתחים.
יזמים, CTOs ומנהלי מוצר שלא יטפלו בזה מוקדם יגלו שהמחיר האמיתי מגיע בשלב המכירה ללקוחות גדולים. מי שמטפל בזה בזמן יכול לשמר מהירות פיתוח, לעבור AI Transformation בצורה אחראית, ולהימנע מכתיבת מוצר מחדש בדיוק כשהחברה אמורה לצמוח.
מיסטרביט מסייעת לחברות לתכנן ולבנות מערכות SaaS, ארכיטקטורות ענן, מוצרי AI ותהליכי פיתוח שמוכנים לצמיחה אמיתית, כולל חיזוק צוותים, ייעוץ ארכיטקטוני ופיתוח מקצה לקצה. אם אתם בונים מוצר חדש, משדרגים MVP קיים או צריכים לחשב מחדש את גבולות הבידוד והסקייל במערכת שלכם, אפשר לדבר עם מיסטרביט ולקבל כיוון מעשי שמחובר גם לקוד וגם לדרישות העסקיות.