מה זה big data: הסבר, כלים ושימושים עסקיים
Big Data הוא נתונים בנפח, במהירות ובמגוון שמערכות מסורתיות מתקשות לאסוף, לאחסן ולעבד בצורה יעילה. הצורך בתשתית כזאת נובע מדרישות העבודה עם הנתונים, ולא מעצם העובדה שלארגון יש הרבה מידע.
נניח שאתם מנהלים רשת קמעונאית עם קופות בסניפים, אתר מכירות, אפליקציה וחיישנים במחסנים. מנהלת התפעול רוצה לדעת איפה צפוי מחסור, מנהל המוצר מנסה להבין למה לקוחות נוטשים, וצוות הפיתוח עסוק בחיבור דוחות שלא מסכימים זה עם זה. לפני שמחליטים להקים פלטפורמת נתונים, צריך לברר אם הבעיה היא באמת קנה המידה, או דווקא הגדרות לא אחידות ותהליכי עבודה מפוצלים.
כדי להבין מה זה Big Data, כדאי להפריד בין המאפיינים של הנתונים, הכלים שמטפלים בהם והערך העסקי שמצדיק את ההשקעה. אלה החלטות קשורות, אבל הן אינן אותה החלטה.
תוכן עניינים
- מה מגדיר נתונים כ-Big Data
- מהאיסוף ועד התובנה דרך צינור Big Data
- Hadoop, Spark והכלים שמאחורי המונח
- מתי Big Data הוא הפתרון הנכון ומתי לא
- שימושים עסקיים שכדאי להכיר בישראל ובעולם
- אתגרי איכות, אבטחה וממשל בעיבוד נתונים גדולים
- בדקו את הצורך לפני שבונים את התשתית
מה מגדיר נתונים כ-Big Data
ברשת הקמעונאית שבתרחיש, כל מקור מתאר חלק אחר מהמציאות. הקופה מתעדת עסקה שהושלמה, האתר מתעד גם צפיות שלא הסתיימו ברכישה, והחיישן מתעד תנאי אחסון בלי לדעת מי הלקוח. האתגר מתחיל כשצריך לחבר ביניהם כדי לקבל החלטה תפעולית אמינה.
נתוני עתק אינם מוגדרים לפי גודל קובץ בלבד. כמות גדולה של רשומות אחידות, שנבדקות לעיתים רחוקות, עשויה להיות פשוטה יותר לעיבוד מאוסף קטן יותר של אירועים סותרים שמגיעים ברציפות. ההגדרה תלויה בשילוב בין מאפייני המידע לבין יכולת המערכת לעמוד בדרישות.
חמשת מאפייני Big Data
הטבלה מציגה מאפיינים שימושיים לבדיקת הצורך. הדוגמאות הן תרחישים להמחשה, לא ספי כניסה מחייבים.
| מאפיין | מה זה אומר | דוגמה |
|---|---|---|
| נפח (Volume) | כמות נתונים שגוזלת אחסון ועיבוד מעבר ליכולת הכלים הקיימים | רשת שמייצרת מיליוני רשומות עסקאות ולוגים בשבוע |
| מהירות (Velocity) | קצב יצירת הנתונים ודרישת העדכון | אירועי צפייה באתר שמזינים המלצות בזמן אמת |
| מגוון (Variety) | פורמטים שונים, כמו טבלאות, טקסט חופשי, תמונות ולוגים | שילוב קריאות שירות, נתוני חיישנים ומסמכים |
| אמינות (Veracity) | רמת הדיוק, העקביות והשלמות של המידע | כפילויות, ערכים חסרים או שדות ששינו את משמעותם |
| ערך (Value) | התועלת העסקית שמפיקים מהנתונים | תחזית ביקוש שמשנה את כמות ההזמנה מספק |
נפח, מהירות ומגוון מתארים את הקושי ההנדסי. אמינות וערך עוזרים לבדוק אם אפשר לסמוך על התוצאה ואם בכלל כדאי לייצר אותה. מערכת יכולה לעבד נתונים בהצלחה מבחינה טכנית, ועדיין להפיק מדד שאף מנהל אינו יכול להשתמש בו.
לפי הלשכה המרכזית לסטטיסטיקה, מידע מטלפונים ניידים, רשתות חברתיות, פעילות מקוונת וחיישנים נכלל במקורות מידע שניוניים, כלומר מידע שלא בהכרח נאסף מלכתחילה לצורך סטטיסטיקה. שימוש במקורות כאלה מאפשר לבחון תופעות בתדירות ובפירוט שאינם נשענים רק על סקרים ומפקדים.
גדול לאדם אינו בהכרח גדול למערכת
גיליון אקסל עם כמה מאות אלפי שורות עשוי להיות מסורבל לעבודה ידנית, בלי להצדיק ארכיטקטורה מבוזרת. מסד נתונים מתאים, אינדקסים ומודל נתונים מסודר עשויים להספיק.
גם מאגר קטן ומלוכלך ממקורות רבים אינו הופך אוטומטית ל-Big Data. הוא דורש טיפול באיכות ובאינטגרציה, אבל לא בהכרח מנוע עיבוד מבוזר.
כלל אבחנה: בדקו איזו דרישה המערכת אינה מצליחה לספק, במקום לשאול אם המאגר נראה גדול.
מהאיסוף ועד התובנה דרך צינור Big Data
צינור נתונים, או pipeline, הוא רצף הפעולות שבין יצירת המידע לבין השימוש בו. כל פעולה צריכה להיות ניתנת לבדיקה ולהפעלה חוזרת, אחרת תקלה במקור מידע עלולה להפוך לדוח שגוי בלי שאיש יבחין בכך.
המסגרת של הלמ״ס למקורות מידע דיגיטליים מדגישה שמידע מגיע מפלטפורמות ומכשירים שונים. מבחינה הנדסית, צריך להתמודד לא רק עם כמות הרשומות, אלא גם עם מבנים, תדירויות עדכון והרשאות שימוש שונות.
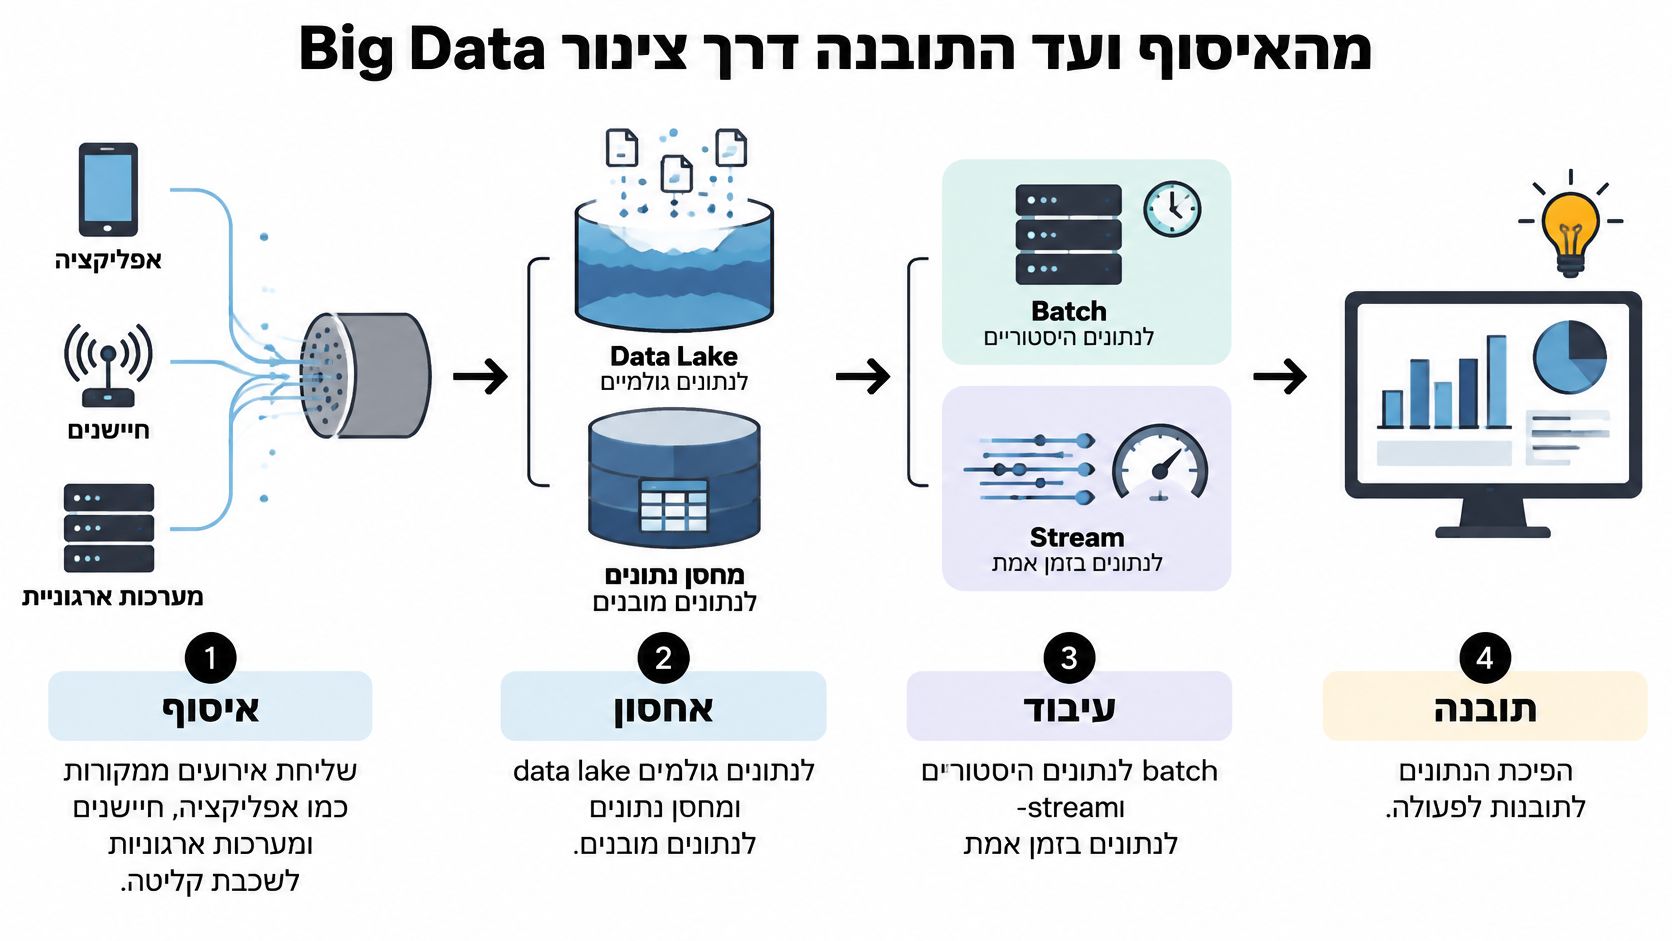
השלבים והטעות שכדאי למנוע בכל אחד מהם
איסוף. אפליקציות, חיישנים ומערכות ארגוניות שולחים אירועים לשכבת קליטה עם מבנה מוסכם. השכבה נחוצה כדי לקבל מידע באופן מבוקר; טעות נפוצה היא לשנות את מבנה האירוע במוצר בלי לוודא שהמערכות שקוראות אותו עדיין מבינות אותו.
אחסון. אפשר לשמור נתונים גולמיים ב-data lake ונתונים שעברו התאמה לדיווח במחסן נתונים. המטרה היא להפריד בין חומר המקור לבין הייצוג העסקי, ולא להניח שכל מה שנשמר כבר מתאים לשאילתה של מנהל.
עיבוד. עיבוד אצווה, batch, מתאים לחישובים תקופתיים על מידע שהצטבר; עיבוד זרם, stream, מתאים לתגובה לאירועים כשהם מגיעים. הטעות היא לבחור בזמן אמת לכל משימה, גם כשאין למשתמש צורך בתוצאה מיידית.
ניקוי ואיכות. מסירים כפילויות, בודקים ערכים חסרים ומתעדים את מסלול הנתון, המכונה lineage. לא משלימים כל חוסר באופן אוטומטי, ולא מניחים שמודל בינה מלאכותית יבחין בעצמו בין רעש לבין התנהגות אמיתית.
ניתוח והגשה. מגישים את התוצאה בדוח BI, במודל AI או דרך API שהמוצר צורך. הטעות בשלב הזה היא לפרסם מדד בלי הגדרה עסקית, כך שכל צוות מפרש אותו אחרת.
מה קורה ללחיצה באפליקציה
נניח שמשתמש לוחץ על כפתור הרשמה. האירוע נשמר עם זמן ההתרחשות, גרסת האפליקציה ומזהה אירוע; לאחר מכן תהליך בדיקה מזהה אם אותה לחיצה נשלחה שוב בגלל ניסיון חוזר של הרשת.
רק האירוע התקין נכנס לחישוב שיעור ההתקדמות בתהליך ההרשמה. מנהלת המוצר רואה בדוח התקופתי את התוצאה, ויכולה לברר מאילו אירועים היא חושבה. אם משתמשים באותה תשתית גם לאוטומציות עסקיות, אפשר להפעיל פעולה על בסיס אירוע מוגדר, בלי לתת לכל רכיב גישה לכל המידע.
הפרדת השכבות מצמצמת תלות בין חלקי המערכת. ממשקים יציבים מאפשרים להחליף מנוע עיבוד או אחסון בלי לכתוב מחדש את אפליקציית ה-Web והמובייל. הערך אינו מספר הקבצים שנשמרו, אלא היכולת לקשור מידע הטרוגני לתוצאה שאפשר למדוד ולהסביר.
Hadoop, Spark והכלים שמאחורי המונח
אין כלי יחיד ששמו Big Data. יש רכיבים לאחסון, להעברת אירועים, לעיבוד ולהגשת מידע, וכל אחד פותר בעיה אחרת. בחירת טכנולוגיה מתחילה בדפוס העבודה, לא ברשימת הכלים של צוות אחר.
Hadoop מזוהה עם מערכת הקבצים המבוזרת HDFS ועם מודל עיבוד האצווה MapReduce. Apache Spark הוא מנוע עיבוד מבוזר שיכול לנצל זיכרון לעבודות חוזרות ולתמוך בעיבוד אצווה ובזרמים. ההבחנה החשובה היא בין המקום שבו שומרים מידע לבין המנוע שקורא ומעבד אותו.
הכלים המרכזיים ב-Big Data ומה כל אחד פותר
| טכנולוגיה | תפקיד עיקרי | מתאימה כאשר | מגבלה עיקרית |
|---|---|---|---|
| Hadoop (HDFS ו-MapReduce) | אחסון מבוזר ועיבוד אצווה על חומרה סטנדרטית | יש ארכיון גדול ועיבוד שאינו דחוף, במיוחד בתשתית קיימת | עיבוד מבוסס דיסק וניהול תשתית מורכב |
| Apache Spark | עיבוד מבוזר עם שימוש בזיכרון ל-batch, streaming ולמידת מכונה | נדרשים ניתוחים איטרטיביים ועבודות ML על נפחים גדולים | דורש התאמת זיכרון, חלוקת נתונים ומשאבים |
| Apache Kafka | העברת זרמי אירועים בין מערכות | צריך לקלוט אירועי מוצר, לוגים וחיישנים | אינו מיועד לשאילתות אנליטיות ישירות |
| מחסן נתונים (Data warehouse) | אחסון ומודל מובנה לדוחות BI | נדרשים מדדים עסקיים עקביים ממקורות מסודרים | נתונים לא מובנים דורשים התאמה לפני דיווח |
| Data lake | אחסון נתונים גולמיים בפורמטים מגוונים | צריך לשמר מקורות לפני ניקוי והחלטה על שימוש | בלי קטלוג וממשל קשה למצוא מידע ולסמוך עליו |
הפשרות שמאחורי בחירת הכלי
Spark עשוי להתאים לחישובים שחוזרים על אותם נתונים, אבל עיבוד בזיכרון אינו הבטחה לביצועים טובים בכל מצב. חלוקה לא מאוזנת של הנתונים, העברות רבות בין מכונות או טעינה מיותרת עלולות ליצור צווארי בקבוק. צריך לבדוק את העבודה המייצגת, ולא רק הדגמה על מאגר נוח.
עיבוד MapReduce נוטה להתאים פחות לשאילתות חוזרות ואינטראקטיביות. עם זאת, אין להסיק ש-Hadoop תמיד זול יותר או ש-Spark תמיד עדיף: חומרה קיימת, מיומנות הצוות, נפח העברת הנתונים ודפוסי הקריאה משפיעים על העלות בפועל.
שירותים מנוהלים ב-AWS, ב-Azure או ב-GCP יכולים להפחית את הטיפול בשרתים ובפריסת רכיבים. הם אינם מבטלים צורך בניטור, בתכנון קיבולת ובשליטה בעלויות, ועלולים להוסיף תלות בשירותים ייחודיים של ספק הענן.
בחרו כלי שאפשר להסביר את תפקידו במשפט עסקי ברור. אם אין לו תפקיד כזה, ייתכן שהוא עדיין לא נחוץ.
ממשק שנבנה ב-React, ב-Angular או ב-Vue אינו צריך להכיר את Spark. שירות ב-Node.js או ב-Python יכול לחשוף תוצאות דרך API מבוקר, בזמן שמערכת הנתונים פועלת בנפרד. בפיתוח תוכנה בהתאמה אישית, הגבול הזה עוזר לשמור על תחזוקת המוצר גם כשהתשתית משתנה.
מתי Big Data הוא הפתרון הנכון ומתי לא
מתי ארגון באמת צריך Big Data? כשהדרישות המשולבות לנפח, לקצב, למגוון ולזמן תגובה אינן נענות היטב במערכת פשוטה יותר, ויש תועלת עסקית שמצדיקה שינוי. דוח איטי לבדו אינו הוכחה לכך: תחילה צריך לבדוק שאילתות, אינדקסים, נעילות ומבנה נתונים.
לפי פרסום הלמ״ס על שימוש בבינה מלאכותית בעסקים, במרץ 2026 כ־39% מהעסקים בישראל השתמשו בבינה מלאכותית, לעומת כ־28% ביוני 2025. זהו נתון על שימוש ב-AI, לא על צורך בתשתית Big Data; שימוש במודל קיים או בעוזר ארגוני אינו מוכיח שיש צורך בעיבוד מבוזר.
מצבים שמכריעים בין מסד רגיל ל-Big Data
המצבים הבאים הם כללי החלטה, לא ספי ביצועים מחייבים.
| מצב | נפח וקצב | גישה מומלצת | מתי היא מתאימה |
|---|---|---|---|
| דוחות תקופתיים ממערכת אחת | נפח קטן עד בינוני, עדכון יומי או שבועי | מסד נתונים רלציוני עם כלי דיווח | שאילתות צפויות ונתונים מובנים |
| מקורות מרובים, אנליטיקה יומית | נפח בינוני, מקורות מגוונים | מחסן נתונים בענן עם ETL או ELT | ריכוז מקורות ושמירה על מודל נתונים אחיד |
| אירועים בזמן אמת ממוצר או מחיישנים | קצב גבוה, צורך בתגובה תוך שניות או דקות | Kafka ועיבוד stream | כשהערך של הנתון דועך עם הזמן |
| מודלי ML על היסטוריה גדולה ומגוונת | נפח גדול, נתונים מובנים ולא מובנים | Data lake עם Spark | כשהעבודה אינה מסתיימת במכונה יחידה בזמן הנדרש |
| מוצר בשלב MVP | נפח קטן, קצב שעדיין אינו ידוע | מסד נתונים רגיל וכלי אנליטיקה פשוט | כשצריך ללמוד מה נחוץ לפני השקעה בתשתית |
מסד רלציוני מציע פשטות יחסית, עסקאות וכלי תפעול מוכרים. ארכיטקטורה מבוזרת מוסיפה אפשרויות להרחבת קיבולת, אבל גם תיאום בין רכיבים, טיפול בכשלים ומיומנויות תפעול נוספות. סקיילביליות אינה חינמית, גם כשהשרתים מנוהלים בענן.
אילו ראיות מצדיקות מעבר
- צוואר בקבוק מתועד. בדיקת עומס מראה שהמערכת אינה עומדת בדרישה, אחרי טיפול בבעיות התכנון המקומיות.
- צורך עסקי ברעננות. החלטה תפעולית מאבדת מערכה אם המידע מגיע רק בדוח תקופתי.
- עלות סבירה לתועלת. ההשקעה כוללת עיבוד, ניטור, אבטחה וניקוי, ולא רק מחיר אחסון.
- אחריות ברורה. יש צוות שיפעיל את הפתרון וגורם עסקי שיוודא שמשתמשים בתוצאה.
גם בתהליך AI Transformation כדאי להפריד בין שיפור תהליך עסקי לבין הרחבת תשתיות. לעיתים חיבור מבוקר למידע קיים נותן מענה טוב יותר מהקמת פלטפורמה חדשה.
שימושים עסקיים שכדאי להכיר בישראל ובעולם
בנק מזהה עסקה חריגה לפי סכומה, המכשיר שממנו בוצעה ודפוסי הפעילות של החשבון. כשמערכות מחברות את האותות בזמן, אפשר לבקש מהלקוח אימות נוסף לפני שהעסקה מושלמת. ההתראה אינה הוכחה להונאה, אלא דרך לתעדף בדיקה.
גם למחיר של טעות יש משקל. חסימה מיותרת פוגעת בלקוח תקין, ולכן צוות המוצר צריך לקבוע מתי להתריע, מתי לבקש אישור ומתי להעביר את המקרה לטיפול אנושי.
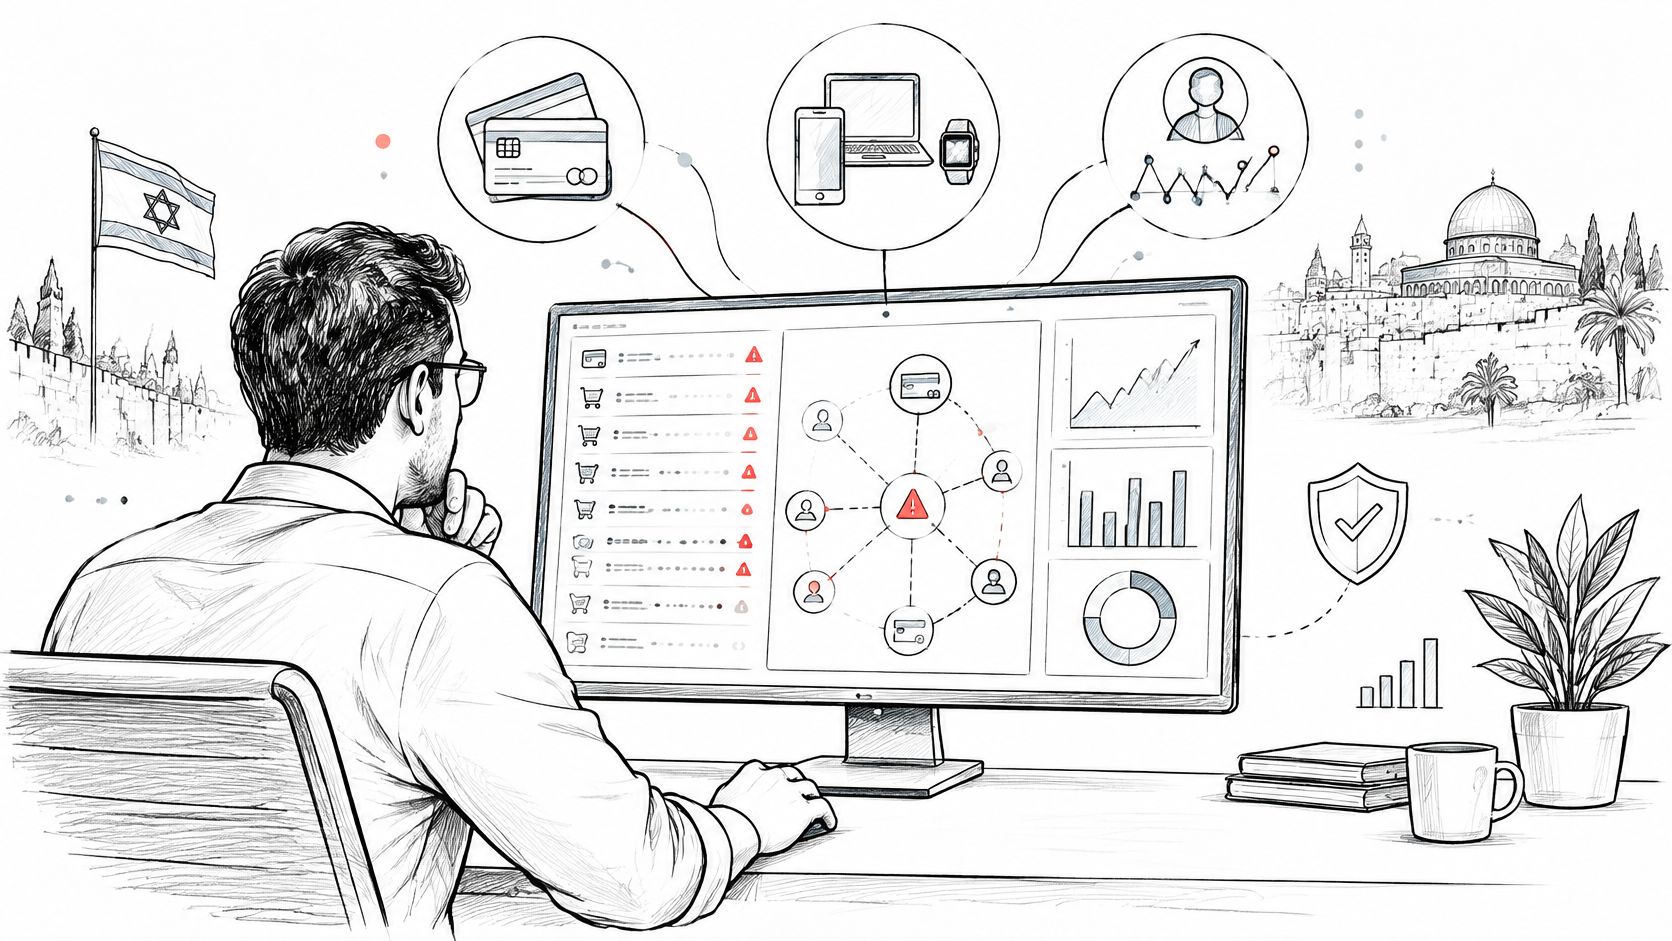
משאלה עסקית לפעולה
- המלצות בקמעונאות ובמדיה. שילוב צפיות ורכישות יכול לסייע בבחירת התוכן או המוצרים שיוצגו. כדאי לבדוק אם ההמלצות עזרו למשתמשים למצוא משהו רלוונטי, ולא להסתפק במדידת הקלקות.
- תחזית ביקוש וניהול מלאי. חיבור היסטוריית מכירות, זמינות ומבצעים תומך בהחלטות הזמנה. כדי לפרש את הנתונים נכון, יש להבחין בין ביקוש נמוך לבין מצב שבו המוצר אזל מהמלאי.
- שימור לקוחות במערכות SaaS. דפוסי שימוש עשויים לסמן חשבון שזקוק לסיוע. ירידה בשימוש יכולה לנבוע מעונתיות או משינויים בתפקידים, ולא בהכרח מכוונת נטישה.
- תמיכה בהחלטות בתחום הבריאות. פלטפורמות Big Data יכולות לסייע ברפואה מותאמת אישית ובמודלים חיזויים. כדי להשתמש בהן, נדרשים חיבור זהיר בין נתונים קליניים, הרשאות גישה ותהליכי קבלת החלטות.
איך לקרוא את נתוני האימוץ בישראל
לפי סקר הלמ״ס על שימוש בטכנולוגיות מידע בעסקים, בשנת 2020 ביצעו ניתוח ביג דאטה 5% מהעסקים באוכלוסיית הסקר בישראל, לעומת 14% בממוצע באיחוד האירופי באותה מדידה. הלמ״ס ייחסה את הפער בעיקר לשימוש נמוך בענפי השירותים והמסחר.
מדדים דיגיטליים שנאספו בתקופות אחרות הציגו שיעורי אימוץ שונים. בלי התאמה של שנת המדידה ושל אוכלוסיית הסקר, אי אפשר להסיק מהם מגמת צמיחה אחידה. עבור מנהלים, נתון ארצי הוא הקשר בלבד, ולא תחליף לבדיקה אם המוצר או התהליך הארגוני זקוקים לתשתית Big Data.
בכל אחד מהיישומים, השאלה המעשית היא איזו החלטה הנתונים אמורים לשפר. גם מאגר גדול אינו מועיל בפני עצמו: צריך להגדיר את משמעות הנתונים, לאפשר שימוש בהם דרך ממשקי API ולחבר את התוצאה לפעולה ברורה. לפעמים דוח מובן עונה על הצורך טוב יותר ממודל מורכב.
אתגרי איכות, אבטחה וממשל בעיבוד נתונים גדולים
בשנת 2024 אומתו בישראל 17,078 אירועי סייבר, לעומת 13,040 בשנת 2023, לפי מסמך הערכת ההשפעה בתחום הגנת הסייבר. הנתונים אינם מודדים תקיפות על מערכות Big Data דווקא, אבל הם ממחישים מדוע אי אפשר לדחות אבטחה עד אחרי הקמת פלטפורמת הנתונים.
ריכוז מקורות מקל על ניתוח, אך מרכז גם מידע רגיש במקום שאפשר להגיע ממנו לחלקים רבים של הפעילות. לכן תכנון גישה, תיעוד ושחזור צריך להיות חלק מארכיטקטורת התוכנה, ולא תוספת מאוחרת.
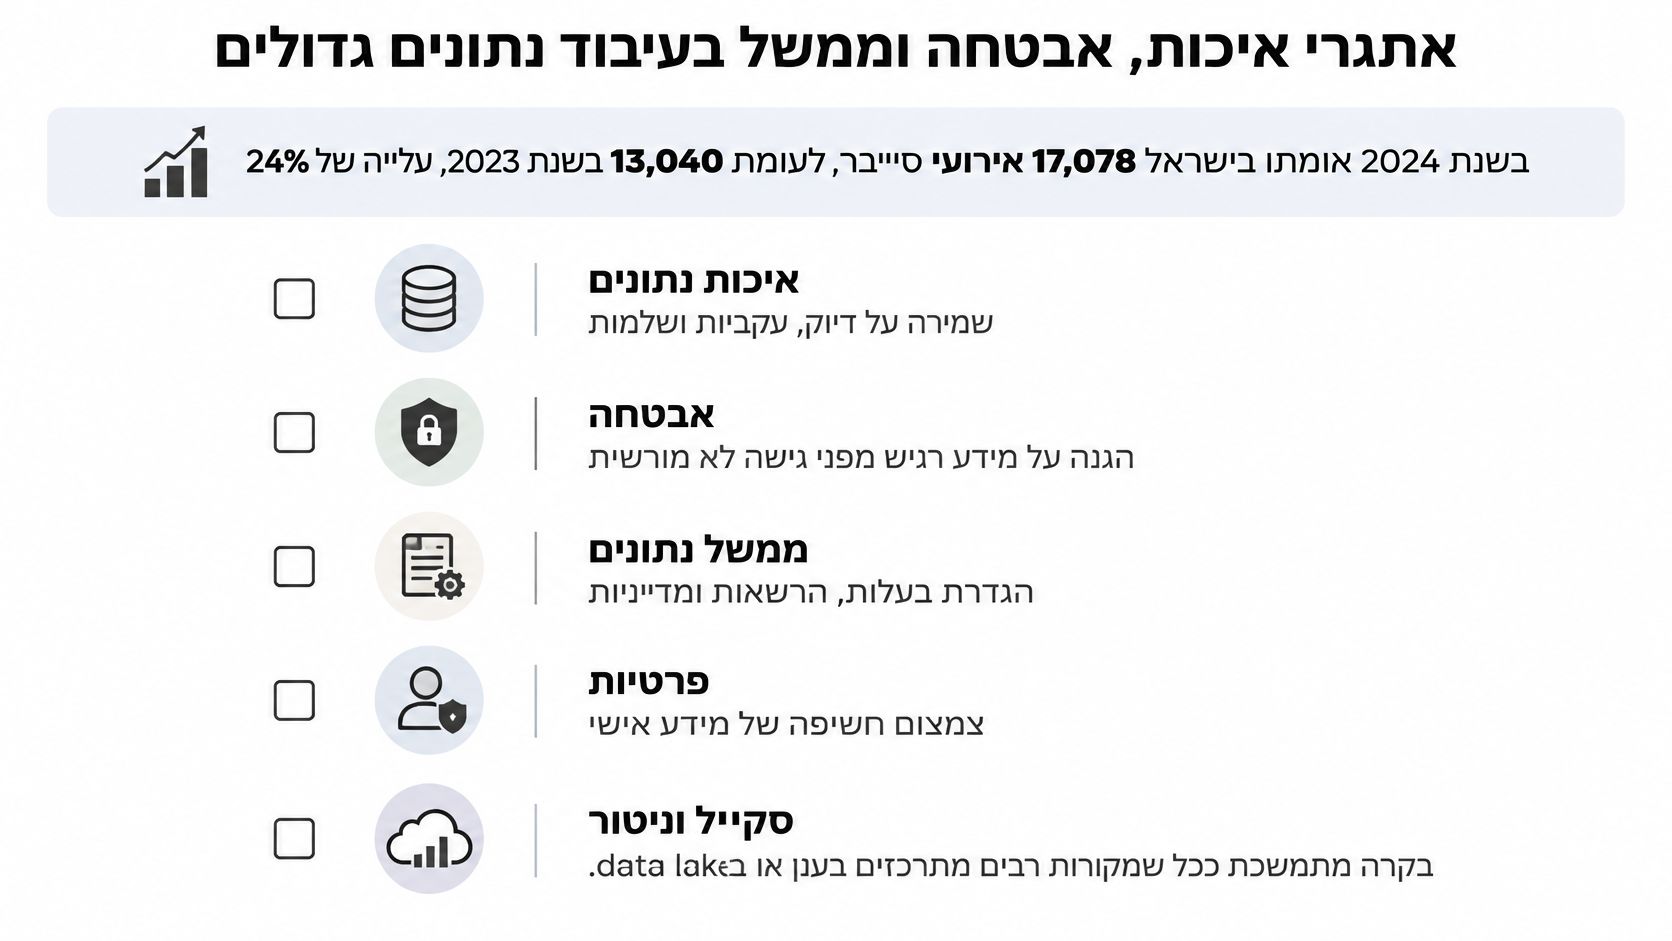
הבעיה בשטח והבקרה המתאימה
| אתגר | איך הוא מופיע בפועל | בקרה מעשית |
|---|---|---|
| איכות נתונים | אירועים כפולים, ערכים חסרים ושינוי משמעות של שדה | בדיקות סכימה, בדיקות שלמות והתרעה על שינוי בהתפלגות |
| פיצול ואי־אחידות | לכל מערכת מזהה לקוח והגדרת סטטוס אחרת | מילון נתונים, קטלוג, כללי התאמה ובעלים לכל מקור |
| אבטחה והרשאות | משתמש או שירות יכולים לקרוא מידע שאינו נחוץ להם | הרשאות לפי תפקיד, הפרדת סביבות והצפנה |
| עלות כוללת | עבודות חוזרות סורקות מידע ללא צורך | שיוך עלויות, ניטור משימות ומדיניות מחזור חיים |
| מדידת ערך | תחזית נראית מדויקת אך אינה משנה החלטה | מדד תפעולי ובדיקת התוצאה אצל המשתמש העסקי |
מקרה של פיצול מידע מתואר אצל ראמ״ה, הרשות הארצית למדידה והערכה בחינוך: לפי תיאור הקמת מאגר הנתונים הענני של ראמ״ה, המידע נוהל בכ־1,000 קבצים נפרדים ובסוגי קבצים שונים, ללא מאגר מרכזי סדור. היעדים כללו אינטגרציה של מידע היסטורי ועתידי, הנגשה דרך ממשקי API ותמיכה במחקר ובניתוח.
הלקח אינו שכל אוסף קבצים מחייב data lake. צריך להסדיר מזהים, אחריות ומבנה מידע כדי שגם אחרי הריכוז יהיה אפשר להבין מה נמצא במאגר.
אבטחה שאפשר לתפעל
הצפנה לבדה אינה מספיקה. נדרשים ניהול מפתחות, Audit Logs, ניטור גישה חריגה וגיבויים שנבדקו בשחזור. במידע אישי כדאי להפריד נתוני זיהוי מהמאפיינים המשמשים לניתוח, ולהימנע מהעתקת מידע רגיש לסביבות פיתוח.
איזון תפעולי: התאימו את מסלול האישור לרגישות המידע. בקשה למדד מצרפי אינה צריכה לקבל אותו טיפול כמו גישה לרשומות מזוהות.
בקרות מחמירות מדי עלולות לעכב צוותים ולעודד מעקפים. מסלולי גישה מתועדים, עם הרשאות מוגבלות ותוקף מוגדר, מאפשרים לעבוד בלי לפתוח את כל המאגר.
Agentic AI מוסיף סיכון כאשר סוכן יכול גם לקרוא מידע וגם לבצע פעולות. יש להגביל את הכלים וההרשאות שלו, לבדוק קלטים זדוניים ולדרוש אישור אנושי לפעולות רגישות, במקום להניח שהמודל יפעיל שיקול דעת ארגוני.
בדקו את הצורך לפני שבונים את התשתית
לפני שמתחייבים לאשכול Spark, הגדירו מי צריך לקבל איזו החלטה, איזה מידע חסר לו ומה ייחשב שיפור. אם אין תשובות ברורות, עוד לא ברור איזו בעיה התשתית אמורה לפתור.
ערבו בתכנון מנהל מוצר, איש פיתוח ונציג של המשתמש העסקי. כך אפשר לבדוק יחד אם הפתרון רלוונטי למוצר, אפשרי מבחינה הנדסית וישמש בפועל.
שאלות שצריך לסגור לפני אישור התקציב
- מהו מקרה השימוש? החליפו יעד כללי כמו שיפור האנליטיקה בפעולה מסוימת, למשל בחירת הזמנות לבדיקה או תעדוף פנייה לחשבונות שזקוקים לסיוע.
- איך תמדדו הצלחה? הגדירו תוצאה תפעולית לצד מדד טכני. דיוק של מודל לבדו אינו מספיק אם צוות השירות אינו יכול לטפל בהתרעות.
- מי אחראי על הנתונים? מנו גורם שמפרש שדות, מטפל בשינויים ומכריע כשמקורות מידע סותרים זה את זה.
הבחירה בין מסד נתונים רגיל, מחסן נתונים ועיבוד מבוזר צריכה להישען על דרישות השימוש. תעדו מדוע בחרתם בפתרון מסוים, מדוע חלופה מורכבת יותר אינה נחוצה כרגע, ואילו שינויים בדרישות יצדיקו בחינה מחודשת. כך אפשר להרחיב את המערכת בלי להפוך את ההחלטה הראשונה לקבועה.
איך לבחון פתרון בלי לבנות הכול
בחרו כמה מקורות מידע מוגדרים והריצו תהליך מלא על דוגמה מייצגת. כללו נתונים חסרים, אירועים שמגיעים באיחור וניסיונות חוזרים. בקשו מהמשתמש העסקי לעבוד עם התוצאה ולהסביר איזו פעולה הוא משנה בעקבותיה. הדגמה על נתונים נקיים בלבד אינה בודקת את הקשיים שעלולים להופיע בסביבת הייצור.
גם ב-MVP הגדירו סיווג מידע, מדיניות שמירה ותוכנית תגובה לאירועים. קבעו מי רשאי לגשת למידע, מתי מוחקים אותו ומי מטפל בחשד לחשיפה. ההחלטות האלה אינן מחייבות פלטפורמה גדולה.
חשבו את העלות הכוללת: אחסון, עיבוד, העברת מידע, ניטור, תחזוקה וזמן צוות. בדקו גם מה קורה אם מקור מידע נכשל או אם צריך לחשב נתונים מחדש. כך תדעו מה נדרש להפעלה תקינה, וגם להתאוששות מתקלה.
פתרון בשל הוא כזה שהצוות יודע להפעיל, להסביר ולתקן, ולא רק להציג בהדגמה.
אם אין בארגון בעלות טכנולוגית מתאימה, הגדירו מי ימלא את התפקיד, בתוך הארגון או באמצעות CTO as a Service. אם נדרש חיזוק של יכולת הפיתוח, שלבו את המפתחים בתהליכי הקוד, האבטחה והתפעול הקיימים. מתכנתים של מיסטרביט משתלבים בחברות כדי להשלים צוותי פיתוח ולעיתים גם להוביל אותם.
בחרו בתשתית הפשוטה ביותר שעומדת בדרישות שנבדקו. תיעוד וממשקים ברורים יכולים לתמוך בצמיחה, אך כדאי להוסיף מורכבות רק כשיש צורך מוגדר שהיא פותרת.
מיסטרביט מציעה ייעוץ ארכיטקטוני, פיתוח תוכנה ופתרונות מבוססי AI, לצד חיזוק צוותי פיתוח במודל Team Extension. אם אתם בוחנים איזו תשתית מתאימה למוצר, קבעו שיחת ייעוץ כדי לעבור על מקורות המידע, דרישות הביצועים והיכולת של הצוות לתחזק את הפתרון.