מיגרציה לענן: מדריך מעשי לתכנון וביצוע
בחברת פינטק ישראלית, ה-CTO מקבל מהדירקטוריון יעד שנשמע פשוט: להעביר את כל התשתית לענן בתוך תשעה חודשים. באותו שבוע מתברר שמתחרה יצא למיגרציה דומה, אך סבל מהשבתות, חריגות תקציב ותלות בספק חיצוני שאיש בארגון לא ידע להחליף. הלחץ גדל, והתגובה האינסטינקטיבית היא להתחיל להקים חשבונות AWS, Azure או GCP.
זו בדרך כלל התחלה שגויה. מיגרציה לענן היא שינוי ארכיטקטוני, תפעולי ועסקי, לא העתקה של שרתים ממקום למקום. בישראל, ההחלטה מושפעת גם ממיקום הנתונים, מדרישות רגולטוריות, מזמינות אזורי הענן המקומיים ומפער בין הנחיות רשמיות לבין מדידת ROI בפועל. מדריך זה מתמקד במה שקורה לפני המעבר, בבחירת אסטרטגיה, בשליטה בעלויות ובביצוע מדורג שאפשר למדוד ולתקן.
תוכן עניינים
- למה רוב פרויקטי מיגרציה לענן נכשלים לפני שהתחילו
- שלב התגלית, מיפוי תשתית, תלות וסיווג מערכות
- אסטרטגיות מעבר, ההבדל האמיתי בין Rehost, Replatform, Refactor ו-Repurchase
- הערכת עלויות אמיתית, מ-TCO ל-FinOps
- אבטחה, רגולציה ותאימות בעידן הענן הישראלי
- תשתית CI/CD, IaC ו-Observability למיגרציה בטוחה
- תוכנית ביצוע מדורגת והפחתת סיכונים
למה רוב פרויקטי מיגרציה לענן נכשלים לפני שהתחילו
הכישלון הראשון מתרחש לעיתים בחדר הישיבות, עוד לפני שמישהו פתח קונסולה. הנהלה מגדירה תאריך יעד, אך לא מגדירה בעלות עסקית: מי אחראי להמשכיות השירות, מי מאשר חריגת עלות, מי קובע אילו מערכות יישארו זמנית בשרתים מקומיים, ומי מחליט שמערכת מסוימת לא מצדיקה מעבר.
במצב כזה, צוות התשתיות מקבל משימה טכנית במקום יעד עסקי. הוא עשוי להעביר מכונות וירטואליות כפי שהן, לדווח שהמערכת "בענן", ואז לגלות שהעלות גבוהה, שהביצועים לא יציבים ושאף אחד לא יודע אם המהלך הצליח.
בישראל, הלחץ הציבורי והממשלתי סביב הענן התחזק לאורך השנים. החלטת ממשלה 2097 משנת 2014 קבעה שיש להעביר את תשתיות המחשוב של משרדי הממשלה למודל ענן עם גישה מקוונת ותשלום לפי שימוש. לפי מסמך ועדת הכנסת על מערך התקשוב הממשלתי, ההנחיה נכנסה לתוקף בנובמבר 2016, גרסה שנייה פורסמה במאי 2018, ובשנת 2019 פחות מאחוז אחד מההשקעה הכוללת של הממשלה הוקצה לענן, לעומת כ-8% בממוצע עולמי. באותו מסמך הוערך שב-2020 כ-70% מפעילות הממשלה יופעלו בענן ציבורי. הנתונים ממחישים שהכיוון האסטרטגי היה ברור, אך היישום דרש זמן, תשתית ומשילות.
ארבע נורות אדומות שכדאי לזהות
- אין owner עסקי: צוות ה-IT מוביל את המהלך, אך מנהלי המוצר, הכספים והסיכון לא משתתפים בהחלטות.
- הערכת עלות חלקית: המודל כולל compute ואחסון, אך מתעלם מתעבורת egress, רישוי, גיבויים, ניטור, תמיכה ועלות הכשרות.
- Lift and Shift מוצג כאסטרטגיה: העברה ללא שינוי יכולה להיות שלב מעבר, אך היא לא פותרת coupling, ביצועים, תהליכי פריסה או חוב טכני.
- הצוות המבצע מנותק מ-DevOps: ספק חיצוני מעביר את המערכת, והצוות הפנימי מקבל אחריות על הפעלה בלי תיעוד, הרשאות או ידע מספיקים.
Project Nimbus, שנחתם במאי 2021 בהיקף של יותר מ-1 מיליארד דולר בין ממשלת ישראל, AWS ו-Google, סימן שינוי משמעותי בתשתית הענן הציבורית והביטחונית. לפי הדיווח על השקת אזור הענן המקומי של Google בישראל, משרד האוצר העריך שאזור הענן המקומי של Google יתרום כ-7.6 מיליארד דולר לתמ"ג עד 2030 ויותר מ-21,000 משרות. אלה נתוני תחזית, לא הבטחה לכל ארגון פרטי, והם לא מחליפים business case ספציפי.
כלל עבודה: אם אי אפשר להסביר מי מרוויח מהמעבר, מה עלול להיפגע ואיך מודדים הצלחה, עדיין לא מוכנים למיגרציה.
שלב התגלית, מיפוי תשתית, תלות וסיווג מערכות
שלב התגלית הוא העבודה החשובה ביותר לפני כל שורת קוד או קליק בקונסולה. המטרה אינה לייצר רשימת שרתים יפה, אלא להבין מה הארגון מפעיל, במה המערכות תלויות, איזה מידע הן מחזיקות ומה יקרה אם הן יושבתו.
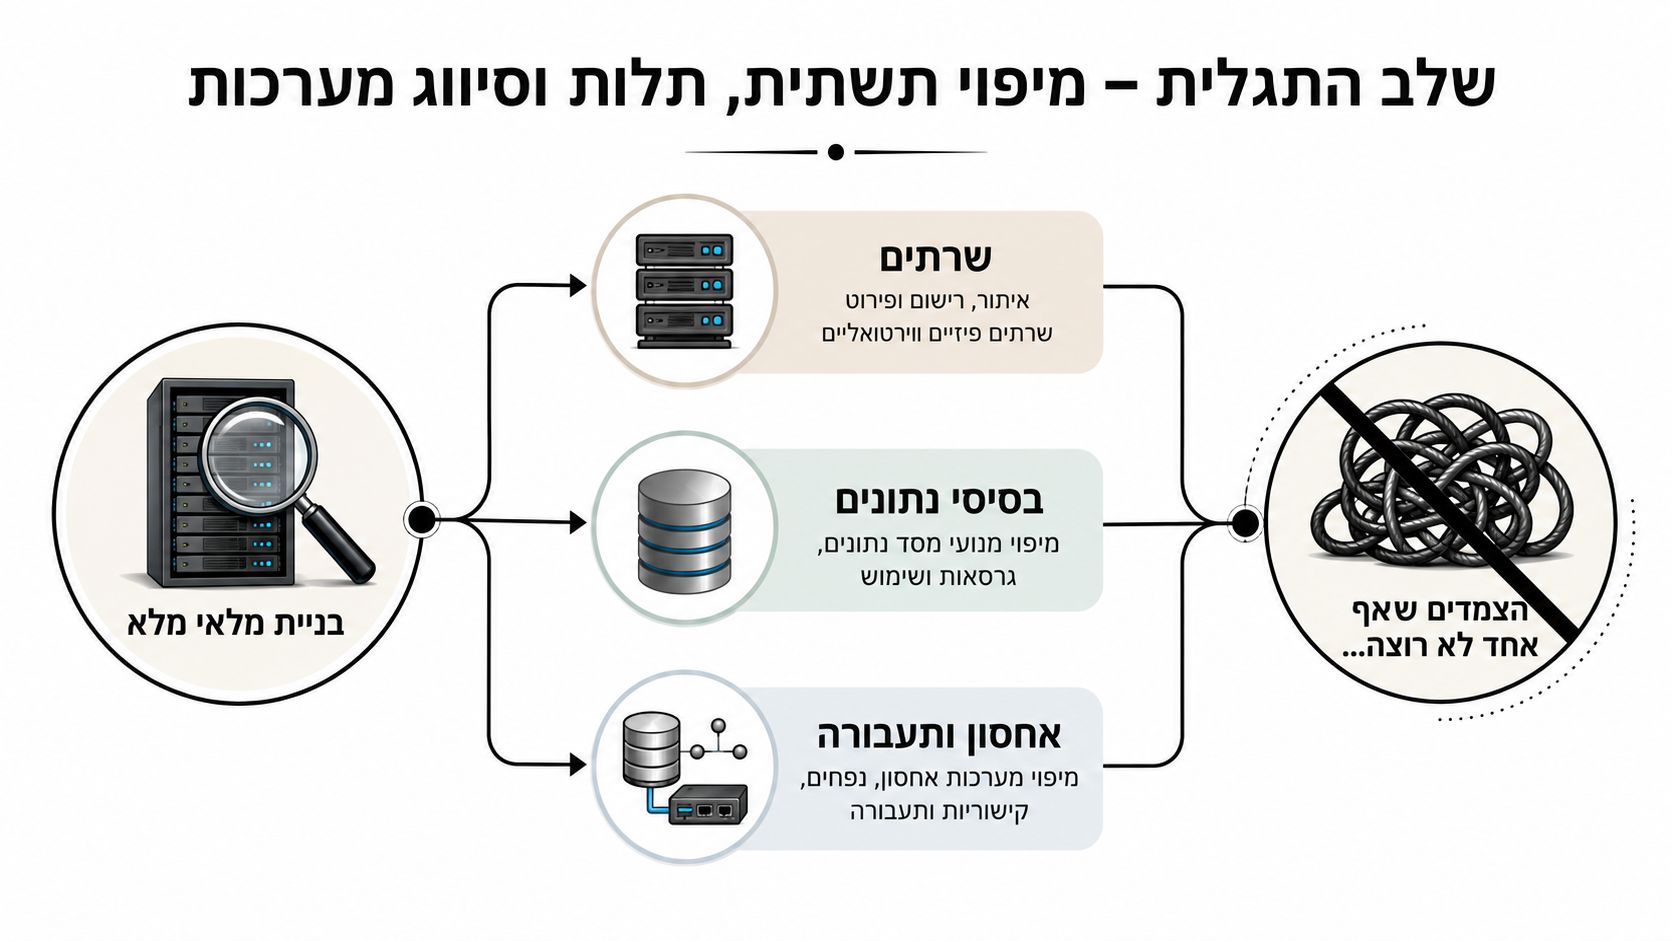
מתחילים במלאי, לא בהנחות
בנו מאגר מרכזי של נכסים. הוא צריך לכלול שרתים פיזיים ווירטואליים, בסיסי נתונים, אחסון, תורים, רכיבי רשת, תעבורה, שירותים מנוהלים, תהליכי batch ואינטגרציות חיצוניות. אל תסתפקו במה שמופיע ב-CMDB, אם קיים. בצעו הצלבה עם ניטור, חיובי ספקים, קוד פריסה ושיחות עם בעלי המערכות.
חפשו גם את הדברים שאף אחד לא רוצה להודות שהם קיימים:
- VM יתום: שרת שאינו משויך לבעלים, אך עדיין צורך משאבים.
- API חיצוני: חיבור לספק שחוזהו לא חודש או שהתיעוד שלו לא מעודכן.
- Job לא מתועד: תהליך לילה שמייצר קובץ או מעדכן טבלה שמערכת אחרת צורכת.
- עותק מידע: snapshot או גיבוי שנשמר בלי מדיניות מחיקה ברורה.
לאחר מכן מפו את התלויות. כלים כמו AWS Application Discovery Service, Azure Migrate ו-Cloudamize יכולים לסייע באיסוף נתונים, אך הם לא מחליפים שיחה עם מפתח, איש תפעול ובעל מוצר. כלי אוטומטי מזהה תעבורה, לא תמיד את המשמעות העסקית שלה.
מזהים coupling לפני שבוחרים יעד
כאשר שירותים משתפים בסיס נתונים, קבצים, תורים או מנגנוני אימות באופן הדוק, העברה נפרדת עלולה ליצור תקלות. סמנו תלות קריטית, תלות שניתנת להחלפה ותלות שדורשת refactor. כך תדעו אם להעביר מערכת כיחידה אחת, לבודד רכיב, או לדחות את המעבר.
השלב האחרון הוא סיווג. אפשר להשתמש בארבע קבוצות עבודה:
- Mission critical: פגיעה ישירה בהכנסות, בשירות או בציות.
- Business operational: מערכות חשובות, אך עם חלופות או חלון תחזוקה.
- מועמד לכיבוי: שירותים שאין להם שימוש מאומת או בעלים פעיל.
- מועמד לארכיון: מידע או מערכת שצריך לשמר, אך לא להפעיל באופן שוטף.
הסיווג הזה מכתיב את אסטרטגיית המעבר. לא מתחילים ב-Refactor משום שהוא אופנתי, ולא ב-Rehost משום שהוא מהיר. קודם מחליטים מה הערך של המערכת, ורק אחר כך איך להעביר אותה.
תגלית טובה חוסכת עבודה: כל מערכת שלא מיפיתם היא הפתעה שמחכה להופיע בזמן cutover.
אסטרטגיות מעבר, ההבדל האמיתי בין Rehost, Replatform, Refactor ו-Repurchase
אין אסטרטגיית מיגרציה אחת שמתאימה לכל עומס עבודה. ההחלטה הנכונה תלויה בגיל המערכת, באופק החיים שלה, ברגישות המידע, בכישורי הצוות ובערך העסקי שצריך לקבל מהענן.
| אסטרטגיה | זמן ביצוע | עלות מוערכת | התאמה לענן | סיכון |
|---|---|---|---|---|
| Rehost | קצר יחסית | נמוכה בתחילת הדרך | נמוכה עד בינונית | חוב טכני, עלויות תפעול ותלות בארכיטקטורה ישנה |
| Replatform | בינוני | בינונית | בינונית עד גבוהה | שינויי נתונים, רישוי ותלות בשירות מנוהל |
| Refactor | ארוך | גבוהה | גבוהה | חריגה בלוחות זמנים, מורכבות וחוסר במיומנויות |
| Repurchase | בינוני, בהתאם לספק | עלות מעבר ורישוי שוטף | גבוהה מבחינת תפעול | נעילת ספק, התאמות תהליך ואובדן שליטה |
Rehost מתאים כאשר המטרה היא להפסיק להפעיל תשתית מקומית
Lift and Shift יכול להיות פתרון הגיוני למערכת יציבה, זמנית או כזו שנמצאת בדרך להחלפה. הוא מאפשר לצמצם שינוי בזמן המעבר, אך לא הופך מערכת ישנה ל-cloud-native. אפליקציה שתוכננה להסתמך על דיסק מקומי, כתובת קבועה או בסיס נתונים יחיד עדיין תישא את המגבלות האלה בענן.
הטעות היא להציג Rehost כיעד סופי. במקרים רבים הוא רק שלב ייצוב, שאחריו צריך לתכנן אופטימיזציה.
Replatform הוא לרוב נקודת האיזון
כאן מבצעים שדרוג ממוקד בלי לכתוב מחדש את כל המוצר. דוגמאות נפוצות הן מעבר מ-MySQL לשירות מנוהל כמו Aurora, העברת אחסון ל-S3 עם lifecycle policies, או שימוש בשירות בסיס נתונים מנוהל במקום הפעלת שרת עצמאי.
היתרון הוא שיפור בתפעול וביכולת הגדילה בלי להיכנס לפרויקט פיתוח ארוך. החיסרון הוא תלות בספק, שינויי תאימות ועלויות רישוי או העברת מידע. בשוק הישראלי צריך לבדוק גם זמינות שירותים באזור מקומי, תמיכה של ספקים והיכרות הצוות עם הטכנולוגיה.
Refactor דורש סיבה עסקית חזקה
Refactor מתאים לאפליקציה שצפויה לחיות זמן רב, להתרחב משמעותית או להפיק ערך מיכולות ענן כמו serverless, Kubernetes מנוהל וארכיטקטורה מבוססת אירועים. הוא אינו מתאים למערכת שעומדת להיסגר לאחר תקופה קצרה, גם אם הארכיטקטורה הנוכחית אינה מושלמת.
צוותים בוחרים לעיתים ב-Refactor מתוך שאיפה ל"פתרון נקי", ואז מגלים שהמיגרציה הפכה לפרויקט מוצר חדש. בדקו מראש זמינות מפתחי Python, Node.js או טכנולוגיות הענן הנדרשות, ואל תניחו שאפשר להשלים את הפער באמצעות קורס קצר.
Repurchase מוציא מערכות שאינן ליבת העסק
CRM, ERP, כלי שירות, ניהול משימות ומערכות משרדיות הם מועמדים טבעיים למעבר ל-SaaS, במיוחד כאשר אין לארגון יתרון תחרותי בקוד עצמו. ההחלטה מפחיתה תחזוקה, אך מחייבת בדיקת פרטיות, ייצוא נתונים, אינטגרציות, SLA ומנגנון יציאה מהספק.
הערכת עלויות אמיתית, מ-TCO ל-FinOps
מודל TCO טוב מתחיל הרבה לפני הצעת המחיר של ספק הענן. הוא צריך לתאר את דפוס השימוש, את תנועת המידע ואת הדרך שבה הצוותים מפעילים את המערכת. עלות compute לפי שעה היא רק רכיב אחד. צריך להפריד בין עומסי עבודה קבועים, עומסים משתנים, סביבות פיתוח, גיבויים, snapshots, ניטור ותעבורה.
העלות שמפתיעה ארגונים היא לעיתים קרובות egress. מידע שעובר בין אזורים, בין שירותים או לכיוון on-premises עשוי לשנות את המודל הכלכלי, בעיקר כאשר המערכת מעבירה קבצים גדולים או מריצה עיבוד מבוזר. גם NAT gateways, לוגים שלא נמחקים וסביבות dev שרצות ללא צורך מצטברים לאורך זמן.
| קטגוריית עלות | דוגמה טיפוסית | השפעה על TCO | פעולת הפחתה |
|---|---|---|---|
| Compute | מכונה שפועלת ללא התאמה לעומס | תשלום על קיבולת שאינה מנוצלת | Rightsizing, autoscaling ושימוש מושכל ב-reserved או spot |
| אחסון | snapshots ולוגים ללא retention | גידול שקט בנפח ובעלות | lifecycle policies, סיווג שכבות ומחיקה מאושרת |
| רשת | egress בין אזורים או ל-on-premises | חשבון לא צפוי בתעבורה גבוהה | תכנון טופולוגיה, caching וצמצום העברות |
| סביבות לא פעילות | dev ו-staging שפועלות ללא הפסקה | צריכה רציפה ללא ערך עסקי | כיבוי מתוזמן ומדיניות חריגה |
| שירותים מנוהלים | רכיבים שנוספו ללא owner | עלות פלטפורמה שקשה לייחס | tagging, קטלוג שירותים ואישור ארכיטקטוני |
FinOps הוא מנגנון ניהולי
הצעד הראשון הוא tagging עקבי לפי מוצר, צוות, סביבה ו-cost centre. לאחר מכן הגדירו dashboards יומיים, anomaly detection ותהליך showback שמציג לכל צוות את העלות של השירותים שהוא מפעיל. אין צורך להעניש צוותים על צריכה לגיטימית, אבל כן צריך להפוך את העלות למידע שנמצא ליד מדדי ביצועים ואמינות.
הגדירו גבולות תקציב והתראות אוטומטיות. במערכות מסוימות אפשר גם לעצור משאבים זמניים, אך לא כדאי לבנות מנגנון שעלול להשבית שירות לקוחות בלי אישור ובקרת חריגים.
לרכש רב-שנתי, בנו מודל לשלוש שנים שמפריד בין baseline מחויב לבין צריכה משתנה. השוו בין התחייבות לספק לבין גמישות, בדקו עלויות יציאה, והכניסו להסכם תנאים לגבי תמיכה, אזורים, שירותים קריטיים וגישה לנתונים. אל תתחייבו לנפח שאינו מגובה בתחזית שימוש אמינה.
אבטחה, רגולציה ותאימות בעידן הענן הישראלי
אבטחת ענן אינה שלב שמוסיפים אחרי שהמערכת כבר רצה. היא מתחילה בהחלטה היכן יישמר המידע, מי יוכל לגשת אליו, אילו רכיבים חייבים להישאר פרטיים ומה הארגון צריך להוכיח בביקורת.
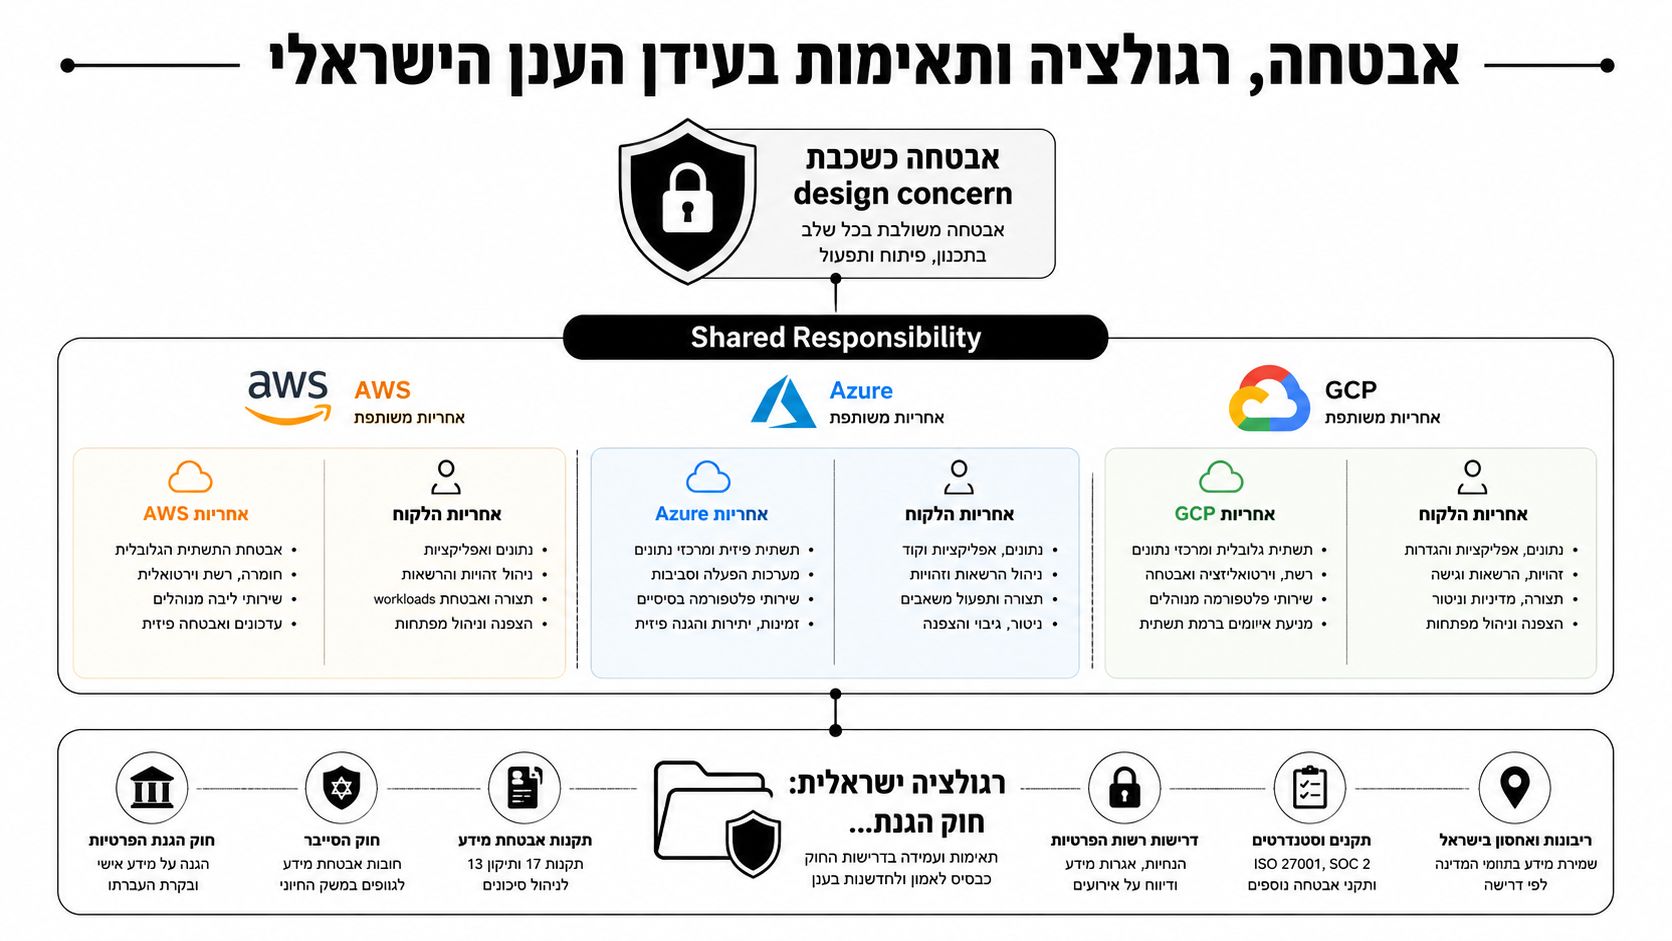
Shared Responsibility מחלק אחריות, לא מבטל אותה
AWS, Azure ו-GCP אחראיות לאבטחת התשתית שהן מפעילות, אך הארגון נשאר אחראי להגדרות, לזהויות, לנתונים, להרשאות, לקוד ולדרך שבה השירותים מחוברים. הבחירה בספק אינה מחליפה ארכיטקטורת אבטחה.
הבסיס המעשי כולל:
- Identity: SSO, MFA, חשבונות מופרדים והרשאות IAM לפי least privilege.
- Data: הצפנה במנוחה ובתנועה, ניהול מפתחות ותיעוד של בעלי גישה.
- Secrets: אחסון סיסמאות, tokens ומפתחות ב-Vault או בשירות ייעודי, לא בקוד או בקבצי pipeline.
- Network: רשת פרטית, Private Link או peering, והפרדה בין שכבות ציבוריות, אפליקטיביות ונתונים.
- Audit: לוגים מרוכזים, אחסון בלתי ניתן לשינוי לפי הצורך, retention מוגדר ויכולת להפיק ראיות.
בישראל, מיקום המידע הוא החלטה משפטית ותפעולית. לפי מסמך AWS בנושא רגולציית משרד הבריאות בישראל, מידע ממאגר בישראל לא יועבר למדינה אחרת אלא אם הדין באותה מדינה מבטיח רמת הגנה שאינה פחותה מזו של הדין הישראלי. אותו מסמך מציין שעמדת רשות הגנת הפרטיות משנת 2020 הכירה ב-EEA ובבריטניה כמדינות שמספקות רמה כזו, בתנאים מסוימים.
אזורים מקומיים אינם פוטרים מתכנון
Project Nimbus, בשווי של כ-1.2 מיליארד דולר, מחייב פריסת מרכזי נתונים בתוך ישראל במרחק של לפחות 25 ק"מ זה מזה, לפי המחקר האקדמי על פרויקט Nimbus ותשתית הענן בישראל. GCP השיקה את אזור הענן בישראל באוקטובר 2022, ו-AWS הפעילה אזור מקומי באוגוסט 2023. התשתית הזו מאפשרת לבחון DR וריבוי אזורים מקומי, אך עדיין צריך לבדוק פיזור עומסים, תלות בספק יחיד והתאוששות במקרה של כשל אזורי.
ב-2025 פורסמו בישראל תקנות שמחייבות ספקי ענן ושירותים דיגיטליים לדווח על מתקפות סייבר משמעותיות. לפי הדיווח על דרישות הדיווח והסמכויות במקרה של מתקפה, הדיווח כולל את מועד תחילת התקיפה, מועד גילויה, אופייה, השפעתה והאם נפגעו ארגונים קשורים. לכן playbook של incident response צריך להגדיר מראש מי מדווח, איזה מידע נאסף ואיך נשמרת שרשרת הראיות.
במגזר הבנקאי קיימות מגבלות נוספות. לפי תקציר הנחיות בנק ישראל בנושא מחשוב ענן, בנקים אינם אמורים להשתמש בענן לפעילויות או מערכות ליבה, ולאחסן, להעביר או לעבד מידע רגיש מחוץ לישראל אלא בתנאים שנקבעו, וכל מימוש ענן מהותי מחייב מיפוי וסקר סיכונים ייעודיים.
תשתית CI/CD, IaC ו-Observability למיגרציה בטוחה
מיגרציה בטוחה נראית כמו תהליך הנדסי חוזר, לא כמו מבצע חד-פעמי. שלושת הרכיבים המרכזיים הם Infrastructure as Code, pipeline מבוקר ויכולת observability שמאפשרת להבין מה קורה בזמן אמת.
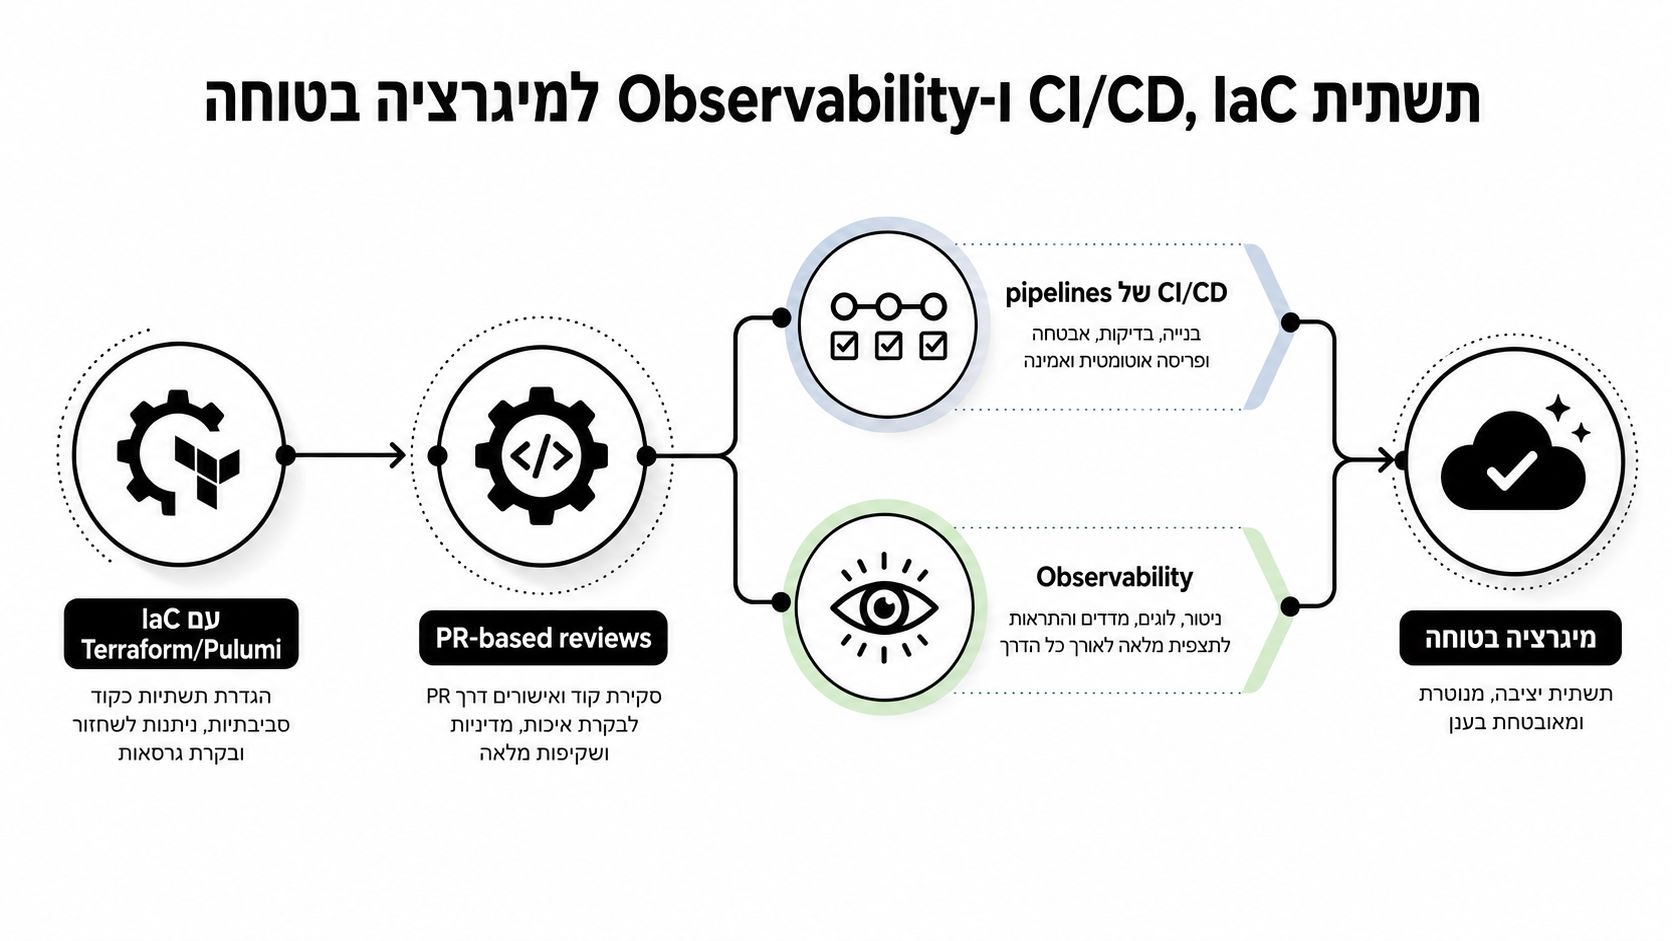
IaC הופך שינוי תשתית לשינוי שאפשר לבדוק
השתמשו ב-Terraform או Pulumi, שמרו state באופן מאובטח ומנוהל גרסאות, וחייבו PR-based reviews לכל שינוי. מודולים חוזרים מצמצמים drift בין dev, staging ו-prod, ומאפשרים ליצור סביבת בדיקה דומה לזו שתשרת את המערכת לאחר המעבר.
ה-pipeline צריך להפריד בין build, test, plan ו-apply. שינוי תשתית לא אמור להגיע לייצור רק משום שמישהו לחץ על כפתור. הוסיפו SAST, SCA ו-policy-as-code כדי לזהות קוד לא בטוח, תלות פגיעה והפרה של כללי הארגון לפני הפריסה.
Observability מגדיר אם המעבר הצליח
מדדו את ה-golden signals, latency, traffic, errors ו-saturation. הוסיפו tracing באמצעות OpenTelemetry, לוגים מובנים ו-retention מוגדר. למערכות קריטיות בחרו canary או blue-green, כדי שהחשיפה לנתיב החדש תתרחב בהדרגה ולא תיצור מעבר בלתי הפיך.
SLOs צריכים להכתיב החלטות rollback. אם זמני תגובה, שיעור שגיאות או צריכת משאבים חורגים מהסף שהוגדר, הצוות צריך לדעת מראש אם עוצרים, מחזירים גרסה או ממשיכים בחקירה.
דוגמאות לארכיטקטורה, פיתוח ואוטומציה אפשר למצוא בבלוג הטכנולוגי של מיסטרביט, אך בכל ארגון יש להתאים את הכלים לדפוסי הפריסה, לרמת הבשלות ולדרישות הציות שלו.
תוכנית ביצוע מדורגת והפחתת סיכונים
אל תנהלו מיגרציה כקפיצה אחת. ניהול נכון מחלק את הסיכון לגלים, כך שכל גל מספק מידע לפני שמגדילים את החשיפה.
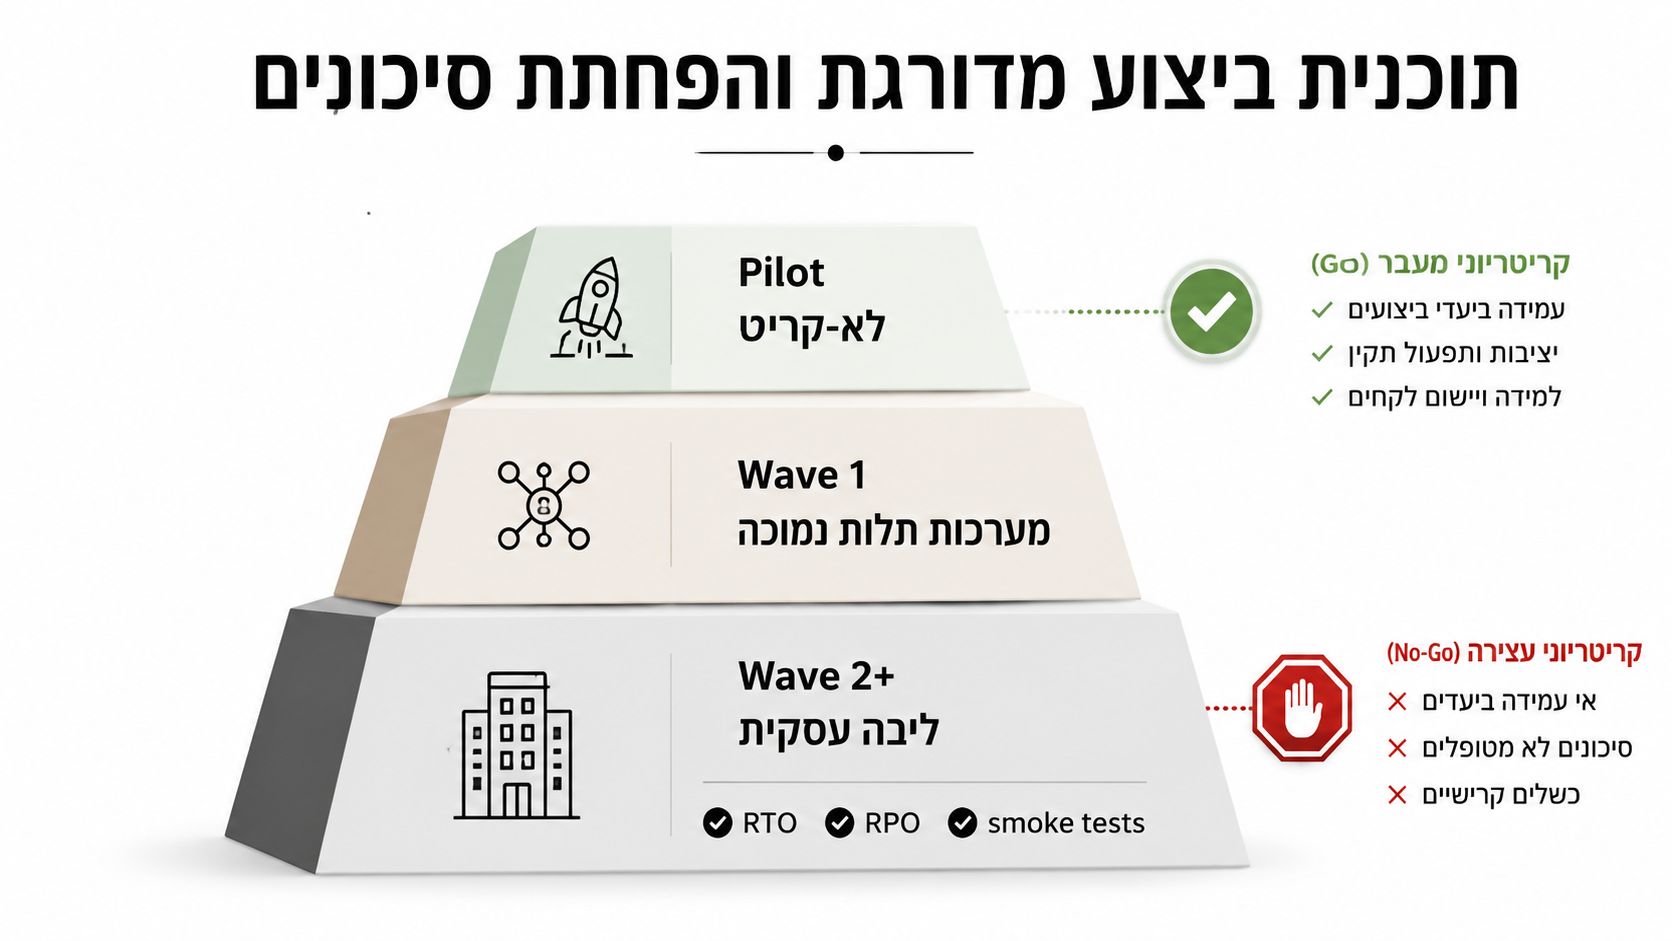
בונים את הגלים לפי ערך הלמידה
התחילו ב-Pilot על workload לא קריטי, אך לא במערכת חסרת משמעות. בחרו שירות שמייצג את האתגרים האמיתיים, אך אפשר להחזירו לאחור בלי לפגוע בלקוחות. אחריו מגיע Wave 1 עם מערכות בעלות תלות נמוכה, ורק לאחר שהצוות הוכיח את התהליך עוברים ל-Wave 2 ולליבת העסק.
היחס החשוב הוא בין גודל הצעד לבין ערך הלמידה. צעד גדול מעביר הרבה מערכות, אך מקשה לדעת מה גרם לתקלה. צעד קטן מאט את התוכנית, אך מייצר ביטחון, תיעוד ודפוסי עבודה שאפשר לשכפל.
Cutover מלא מתאים למערכת שאפשר להקפיא, לסנכרן ולבדוק בזמן חלון תחזוקה. Strangler Fig Pattern מתאים למוצר פעיל, שבו מעבירים capability אחר capability ומשאירים את המערכת הישנה זמינה עד שהרכיבים החדשים מוכנים.
קריטריוני Go או No-Go
לפני כל גל, הגדירו RTO, RPO, smoke tests, תקציב חריגה ומדדי איכות. הכינו rollback אוטומטי כאשר אפשר, ואל תסתפקו בתוכנית חזרה תיאורטית. בצעו Game Day, בדקו שחזור, הרשאות, תעבורה, התראות ויכולת להזעיק את הבעלים הנכונים.
No-Go הוא תוצאה תקינה: עצירה לפני פגיעה בלקוחות זולה יותר מהמשך מעבר רק כדי לעמוד בתאריך.
צ'קליסט ליום שני בבוקר:
- Artifacts: מפת תלויות, runbook, תכנית rollback, תוצאות בדיקות ותיעוד הרשאות.
- Owners: בעלים עסקי, בעלים טכני, אחראי אבטחה ואחראי תקשורת לכל גל.
- מדדים: RTO, RPO, זמני תגובה, שיעור שגיאות, עלות בפועל ותוצאות smoke tests.
- תקשורת: dashboard סטטוס יומי, רשימת סיכונים פתוחה והחלטות Go או No-Go מתועדות.
- בקרה: תהליך אישור לחריגות, מעקב אחרי תקלות וסקירת עלות לאחר כל גל.
לפי מסגרת הענן הממשלתית בישראל, מעבר ענן צריך לכלול הנחיות ענן ומפת דרכים למעבר. בפועל, המשמעות היא להגדיר משילות, סיווגי מידע ודרך מעבר מדורגת לפני ההעברה הטכנית. ההנחיות הרשמיות מדגישות התאמת מערכות לענן, אך שאלת ה-ROI לאחר המעבר דורשת עבודה פנימית: למדוד חיסכון, עלות תפעול, ביצועים, סיכון וערך עסקי לאורך זמן.
ההחלטה החשובה אינה רק איך לעבור, אלא מתי לא להעביר. מערכת עם רישוי בלתי גמיש, תלות חומרה, מידע רגיש או אופק חיים קצר עשויה להצדיק הישארות זמנית, ארכוב או החלפה. ארגון שמודד רק את מספר המערכות שהועברו יוצר מדד פעילות. ארגון שמודד עלות, זמינות, מהירות שינוי ותוצאות עסקיות יודע אם המיגרציה באמת הצליחה.
מיסטרביט מסייעת לארגונים לתכנן ולבצע מיגרציה לענן, לבנות ארכיטקטורה מאובטחת, להטמיע אוטומציות ופתרונות AI ולחזק צוותי פיתוח באמצעות Team Extension וייעוץ CTO. אם אתם עומדים לפני מעבר מורכב או צריכים לחבר בין תשתית, מוצר ופיתוח, מיסטרביט מזמינה אתכם ליצור קשר לייעוץ מעשי ולבניית תוכנית פעולה מותאמת.