Business Intelligence: המדריך המעשי להטמעה חכמה בארגון
מנכ"ל חברת SaaS בינונית נכנס לישיבת הנהלה עם החלטה שנראית פשוטה: להשיק מוצר חדש לקהל הלקוחות הקיים. המייסדים משוכנעים שיש ביקוש, צוות המכירות מציג שיחות חיוביות, וה-CRM מלא בהזדמנויות שנראות מבטיחות. שלושה חודשים לאחר ההשקה מתברר שהסיפור במערכת ה-Billing שונה, ונתוני השימוש במוצר מצביעים על עניין מוגבל דווקא בקרב הלקוחות שאמורים להיות קהל היעד.
הבעיה לא הייתה מחסור במודיעין. הנתונים פשוט ישבו במערכות שלא דיברו זו עם זו, בלי הגדרה אחידה למונחים כמו לקוח פעיל, הכנסה חוזרת או נטישה, ובלי בעל תפקיד שמתרגם מידע גולמי לכללי עסק. זו בדיוק הנקודה שבה Business Intelligence מפסיק להיות דשבורד ומתחיל להיות תשתית ניהולית.
בישראל, השוק הזה אינו חדש. כבר ב-2004 פעלו בישראל יותר מעשר חברות BI שהתחרו על הכנסות שנתיות של כ-110 מיליון שקל, כ-25 מיליון דולר, והערכת השוק הכולל, כולל תשתיות וכוח אדם, עברה את רף 100 מיליון הדולר בשנה, כפי שדווח בכתבת גלובס על שוק ה-BI בישראל. ההיסטוריה הזאת חשובה, אבל השאלה המעשית כיום אחרת: איך בונים BI שמייצר החלטות, ולא רק מסכים שאנשים פותחים פעם אחת?
תוכן עניינים
- ההחלטה שלקחה לכם שנה ולמה זה לגיטימי
- מה זה Business Intelligence בעצם
- ארכיטקטורת הנתונים שמחזיקה ארגון
- ETL מול ELT והבחירה שמשנה הכל
- כלי דשבורדים איך בוחרים בלי להתאהב בהדמיה
- מקרי שימוש אמיתיים ב-SaaS ובארגונים
- למה פרויקטי BI נכשלים גם עם הכלי הנכון
- צ'קליסט להטמעה מוצלחת והצעד הבא
ההחלטה שלקחה לכם שנה ולמה זה לגיטימי
בישיבת ההנהלה הראשונה כולם מדברים על השקה. מנהל המוצר מציג פידבק מלקוחות, סמנכ"ל המכירות מצביע על עסקאות פוטנציאליות, והמייסדים מזהים הזדמנות אסטרטגית. רק לאחר מכן מישהו מבקש לבדוק אם הלקוחות המתאימים באמת משתמשים בפיצ'רים שעליהם המוצר החדש נשען.
הבדיקה נתקעת. נתוני הלקוחות נמצאים ב-Salesforce או במערכת CRM אחרת, החיובים מגיעים ממערכת Billing נפרדת, אירועי המוצר נאספים בכלי Product Analytics, ומידע על תמיכה נשמר במערכת שירות. לכל מערכת יש מזהה לקוח אחר, מחזור עדכון שונה והגדרה שונה ל"פעילות". צוות אחד מחשב הכנסה לפי חשבוניות, צוות אחר לפי עסקאות חתומות, ושלישי לפי תשלום בפועל.
במצב כזה, מנהלים מקבלים החלטות על סמך תחושת בטן לא מפני שהם מתעלמים מדאטה, אלא מפני שאין להם גרסה מוסכמת של המציאות. הם יודעים שהמספרים קיימים, אבל לא יכולים להסביר במהירות איזה מקור אמין, מה השתנה, ומה המשמעות העסקית של השינוי.
כלל מעשי: אם שני מנהלים מגיעים לאותה ישיבה עם מספרים שונים לאותו KPI, עדיין אין לכם שכבת BI. יש לכם אוסף דוחות.
למה העיכוב נמשך
ההחלטה על ההשקה יכולה להידחות חודשים ארוכים, ולעיתים אפילו שנה, משום שצריך קודם לאחד מקורות, לנקות נתונים, להגדיר מודל עסקי, לקבוע הרשאות ולבנות תהליך רענון שאפשר לסמוך עליו. זה לא כשל של מוטיבציה. זו השקעה תשתיתית שמונעת החלטה יקרה על בסיס מידע חלקי.
הארגון נדרש לבחור בין פיתוח תוכנה בהתאמה אישית לבין שימוש בפלטפורמת BI קיימת, בין data warehouse מסודר לבין פתרון זמני, ובין צוות פנימי לבין Team Extension או CTO as a Service. אין פתרון קסם. כלי מהיר וזול עשוי להוכיח ערך, אבל ייצור חוב טכנולוגי. ארכיטקטורה מסודרת תחזיק זמן רב יותר, אך תדרוש בעלות, תקציב וסבלנות.
הדבר החשוב הוא להכיר בפער מוקדם. מפת נתונים בסיסית, הגדרות KPI כתובות ובעלות ברורה על כל מקור יחסכו דיונים חוזרים, גם אם הם לא פותרים את כל בעיות האינטגרציה מיד.
מה זה Business Intelligence בעצם
Business Intelligence הוא תהליך ארגוני וטכנולוגי שממיר נתונים גולמיים למידע שאפשר להשתמש בו בקבלת החלטות. הוא כולל איסוף ממערכות מקור, אחסון, עיבוד, איחוד הגדרות, ניתוח והצגה בדוחות או בדשבורדים.
לכן BI אינו שם נרדף ל-Power BI, Tableau או לכל מוצר אחר. הכלי הוא שכבת צריכה. הערך נוצר כאשר הנתונים מגיעים בזמן, ההגדרות עקביות, המשתמשים מבינים את המדדים, והמערכת מחוברת לפעולה עסקית ממשית. דשבורד נאה שמציג נתונים לא מעודכנים הוא מוצר תצוגה, לא מערכת מודיעין עסקי.
BI לעומת אנליטיקה מתקדמת
BI קלאסי עונה בעיקר על שתי שאלות:
- מה קרה: כמה נמכר, כמה לקוחות פעילים, מה הייתה העלות ומה השתנה בתקופה מסוימת.
- למה זה קרה: באיזה פלח נרשמה ירידה, איזה ערוץ הביא לקוחות איכותיים יותר, ואיזה שלב בתהליך יצר עיכוב.
אנליטיקה מתקדמת ממשיכה משם לשאלות של חיזוי והמלצה. מודל חיזוי יכול להעריך מי נמצא בסיכון לנטוש, ואוטומציה עסקית יכולה להציע פעולה. כאשר משלבים AI, Python או מודלים סטטיסטיים, אפשר לעבור מניתוח תיאורי לניתוח חזוי ואף ל-Agentic AI שמפעיל workflow. עם זאת, מודל מתקדם לא יתקן הגדרת הכנסה שגויה או נתוני לקוח כפולים.
שרשרת הערך של BI
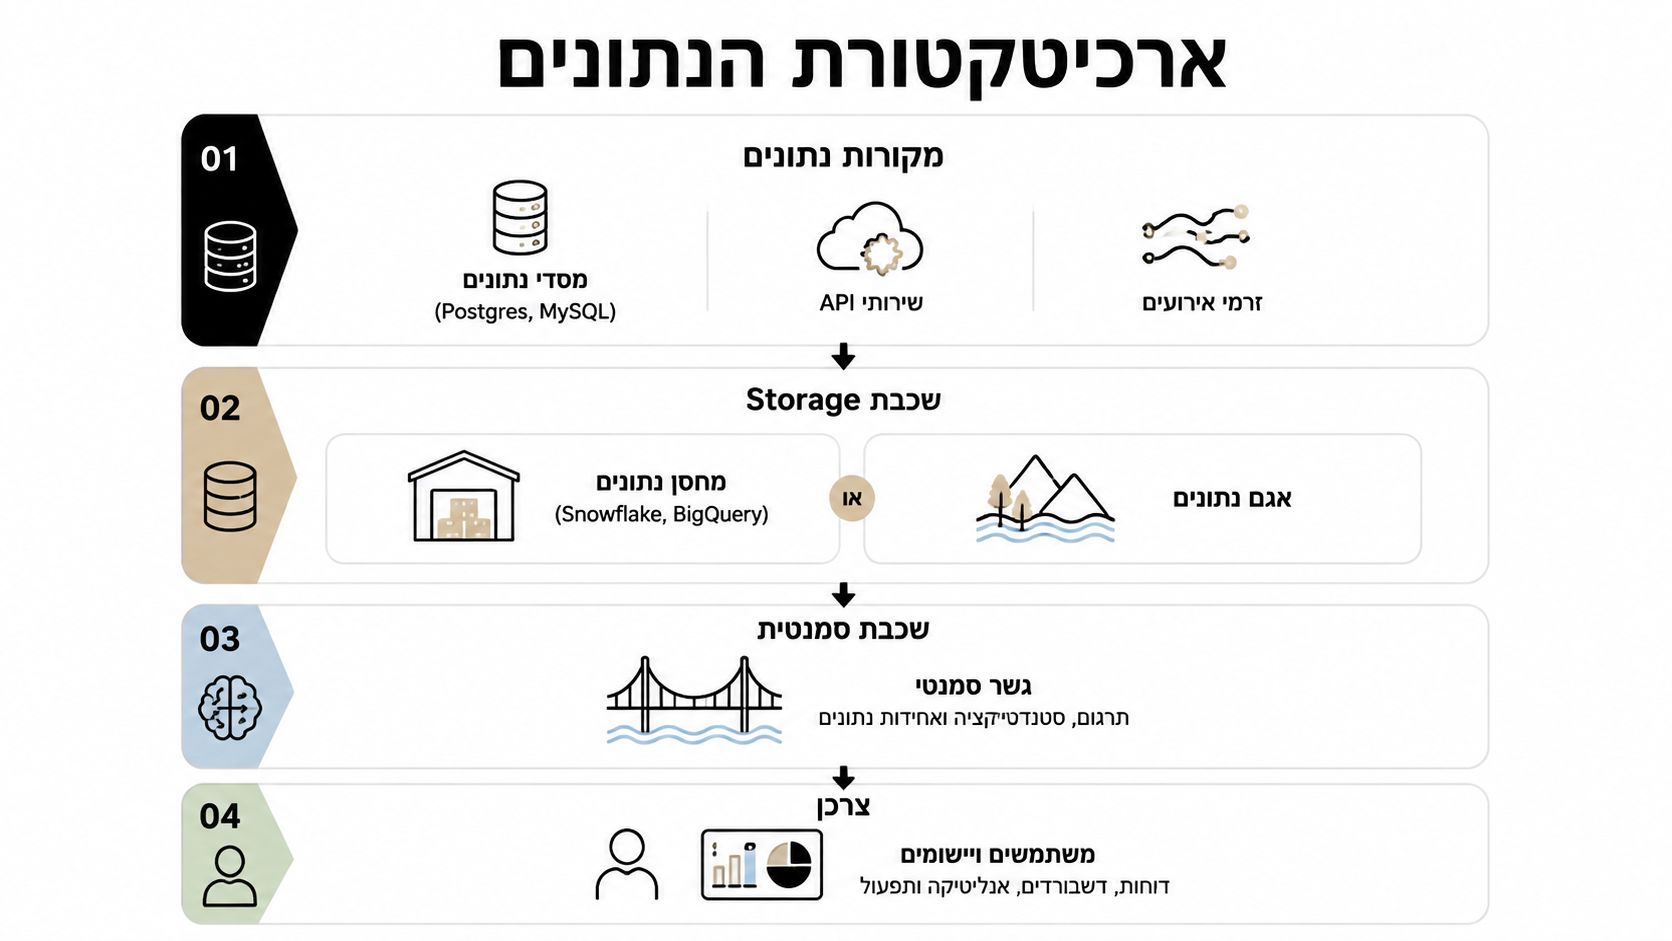
בפועל, רוב הארגונים עוברים את השרשרת הבאה, גם אם הם משתמשים רק ב-Excel:
- מערכות מקור, למשל CRM, ERP, Billing, Postgres, MySQL, APIs חיצוניים ו-event streams.
- אינטגרציה, הכוללת חילוץ, העברה, ניקוי ותזמון.
- אחסון מרכזי, לרוב data warehouse, data lake או lakehouse.
- שכבה סמנטית, שמתרגמת טבלאות ושדות למונחים עסקיים.
- דוחות, דשבורדים וניתוח עצמי, לפי הרשאות ותפקידי משתמש.
- החלטה ופעולה, למשל שינוי תמחור, הקצאת משאבים או פנייה ללקוח בסיכון.
ארגונים שמבקשים להעמיק בנושא יכולים למצוא דוגמאות נוספות ליישום טכנולוגי במאמרים מקצועיים על פיתוח תוכנה ונתונים, אך העיקרון נשאר זהה: BI טוב מחבר בין מקור הנתונים לבין החלטה ספציפית.
ארכיטקטורת הנתונים שמחזיקה ארגון
ארכיטקטורת BI יציבה בנויה משכבות. אפשר להתחיל ב-MVP קטן, אבל לא כדאי לדלג על ההיגיון של השכבות, משום שכל קיצור דרך הופך בהמשך לתלות שקשה להסיר.
שכבת מקורות הנתונים
כאן נמצאות המערכות שמייצרות את המידע: בסיסי נתונים כמו Postgres ו-MySQL, מערכות CRM ו-ERP, APIs של ספקים חיצוניים, מערכות Billing, כלי Product Analytics ו-event streams. לפני שמחברים מקור, צריך להבין מי הבעלים שלו, מה תדירות העדכון שלו ומה המשמעות של כל שדה.
גישה ישירה לכל מקור עשויה להיראות מהירה, אך היא יוצרת דוחות שתלויים במבנה פנימי של מערכת תפעולית. שינוי שם טבלה או שדה יכול לשבור דשבורד בלי שמנהל עסקי יבין למה.
שכבת Storage
Data warehouse כמו Snowflake או BigQuery מתאים בדרך כלל לנתונים מובנים, שאילתות עסקיות ומודלים מוסכמים. Data lake מתאים יותר לשמירת נתונים גולמיים ומגוונים, כולל מידע חצי מובנה, קבצים וזרמים. Lakehouse מנסה לשלב בין הגמישות של lake לבין יכולות ניהול ושאילתות של warehouse.
הבחירה תלויה בנפח, בסוג הנתונים, בדרישות אבטחת מידע ובמיומנויות הצוות. צוות קטן עשוי להעדיף warehouse מנוהל ופשוט יחסית. ארגון Enterprise עם צרכים רחבים של AI, רגולציה וניתוח חופשי עשוי להפיק ערך מתשתית מורכבת יותר, אך רק אם יש לו יכולת לתחזק אותה.
השכבה הסמנטית
זו השכבה שמגדירה מה העסק מתכוון כשהוא אומר "לקוח", "הכנסה חוזרת", "עסקה פעילה" או "זמן אספקה". בלעדיה, כל אנליסט בונה חישוב משלו, והנהלה מקבלת דיון על נוסחאות במקום על החלטות.
בישראל, הפער הזה משמעותי במיוחד. בדוח ממשלתי-מחקרי על הדיגיטציה של המגזר העסקי נמצא שעסקים בעלי intensity טכנולוגית גבוהה הם רק שליש מהשיעור הממוצע במדינות ההשוואה המפותחות, ובכמה טכנולוגיות ייצור מתקדמות האימוץ נמוך לפחות ב-50% מהממוצע, לפי הדוח הממשלתי על הפער הדיגיטלי בעסקים בישראל. לכן, בארגונים רבים Excel עדיין משמש שכבת BI בפועל. הבעיה אינה הגיליון עצמו, אלא היעדר תשתית מוסכמת מתחתיו.
שכבת ההצגה
Power BI, Tableau, Qlik, Metabase או ממשק שנבנה ב-React הם רק נקודת המפגש עם המשתמש. כאן חשוב לתכנן הרשאות, זמני טעינה, mobile access, embedded analytics ונגישות. דשבורד שמציג הכול לכולם בדרך כלל לא משרת אף אחד. מנהל כספים צריך תמונת cash flow, מנהל מוצר צריך שימוש וקוהורטים, ומנהל תפעול צריך חריגות ופעולות.
ETL מול ELT והבחירה שמשנה הכל
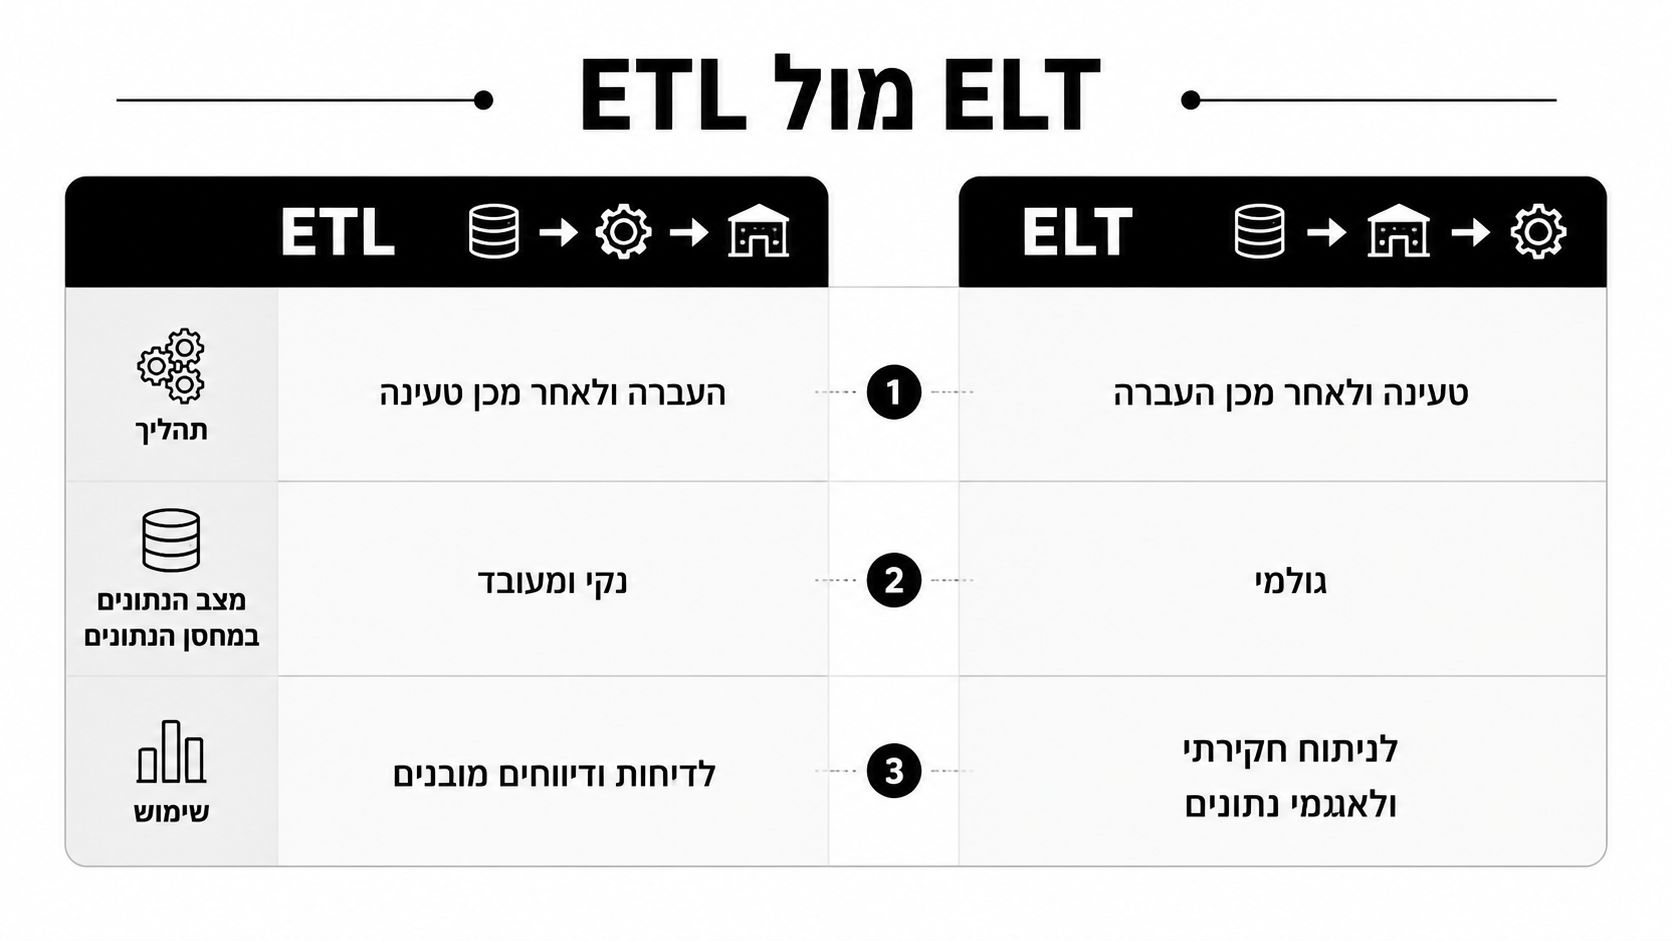
ב-ETL, הנתונים עוברים Extract, Transform, Load. המערכת מחלצת אותם, מעבדת ומנקה אותם לפני הטעינה למחסן. ב-ELT, הנתונים נטענים תחילה בצורה גולמית אל ה-warehouse, והטרנספורמציה מתבצעת בתוכו.
ההבדל משפיע על אבטחה, גמישות, עלויות תפעול ומהירות שינוי. ETL מאפשר לשלוט מוקדם בנתונים רגישים, להסיר PII לפני אחסון מרכזי ולייצר תוצר מובנה לצוותים שצריכים דוחות יציבים. המחיר הוא צינור קשיח יותר, ולעיתים קושי לחזור לנתונים הגולמיים כאשר עולה שאלה חדשה.
ELT מתאים במיוחד כאשר הארגון משתמש ב-Snowflake, BigQuery או Redshift, ויש לו תהליכי modelling עם dbt. הוא מאפשר לשמור מקור גולמי, לשנות מודלים בלי לבנות מחדש את כל הצינור, ולתמוך באנליזה חקרנית. מנגד, הוא דורש governance, הרשאות, ניטור עלויות ויכולת להגן על מידע רגיש בתוך סביבת האחסון.
מתי ETL הוא הבחירה הנכונה
חברת פינטק ישראלית עשויה לבחור ETL עם Airflow ו-PII masking כאשר הנתונים מגיעים ממקורות מבולגנים, קיימות דרישות פרטיות, והצוות צריך לוודא שמידע אישי לא מתקדם לשכבות שאינן מורשות. במקרה כזה, שליטה מוקדמת עדיפה על גמישות אנליטית.
הגישה מתאימה גם לצוות קטן שאין לו זמן לתחזק שכבות רבות, או לארגון שהדוחות שלו יציבים והגדרות המדדים כמעט אינן משתנות. זו לא בחירה מיושנת. זו בחירה שמעדיפה חיזוי תפעולי ושליטה על פני חופש חקירה.
מתי ELT משתלם יותר
חברת SaaS שמוסיפה מקורות נתונים במהירות עשויה להעדיף ELT. טעינת הנתונים הגולמיים, לצד מודלים מנוהלים ב-dbt, מאפשרת לצוות האנליטיקה לבדוק שאלה חדשה בלי להמתין לשינוי בצינור הקליטה. בתרחיש כזה, onboarding של מקור חדש יכול להתקצר מימים לשעות, אך אין להציג זאת כתוצאה מובטחת. הכול תלוי באיכות המיפוי, בבדיקות ובבעלות על המודלים.
החלטת CTO: אל תשאלו איזו גישה מתקדמת יותר. שאלו איזה סוג נתונים, רגולציה, צוות וקצב שינוי יש לכם.
כלי דשבורדים איך בוחרים בלי להתאהב בהדמיה
כל כלי BI נראה משכנע בדמו. הצבעים חלקים, הפילטרים מגיבים, והגרף מספר סיפור. במערכת חיה, השאלות הקשות יותר הן מי מתחזק את המודל, מי מאשר שינוי KPI, כמה מהר מגיע עדכון, ואיך מונעים ממשתמש ליצור מדד פרטי שאינו תואם לדוח ההנהלה.
| קטגוריה | כלים מייצגים | מתאים ל | חיסרון מרכזי |
|---|---|---|---|
| BI מסורתי | Power BI, Tableau, Qlik | ארגונים עם דיווח מובנה, הרשאות ו-semantic model | דורש צוות BI או תמיכה טכנית קבועה |
| Self-service BI | Looker, Sigma, Metabase | צוותי מוצר, שיווק ותפעול שחוקרים נתונים בעצמם | עלול ליצור ריבוי הגדרות ודוחות לא מבוקרים |
| Embedded BI | רכיבי analytics בתוך מוצר SaaS | חברות שרוצות להציג נתונים ללקוחות בתוך המוצר | מחייב תכנון הרשאות, ביצועים וחוויית משתמש כחלק מהמוצר |
| AI-augmented BI | Tableau Pulse, Power BI Copilot | צוותים שרוצים סיכומים, זיהוי חריגות ותובנות אוטומטיות | דורש בקרה אנושית, נתונים אמינים והגדרות מדויקות |
התאמה לארגון ולא לדמו
לארגון ישראלי קטן או בינוני, Looker Studio עם BigQuery עשוי להספיק אם מספר מקורות הנתונים מוגבל, אין דרישות הרשאה מורכבות, והצוות יכול לשמור על מודל נתונים מסודר. Enterprise רגולטורי עשוי להעדיף Tableau עם semantic model, הרשאות מפורטות ותהליכי אישור, גם אם ההטמעה איטית יותר.
Self-service מעניק עצמאות, אבל חופש ללא governance הופך במהירות לכאוס. BI מסורתי מציע שליטה, אך עלול ליצור צוואר בקבוק שבו כל שאלה מגיעה לצוות הנתונים. Embedded BI הוא מוצר בפני עצמו, ולכן צריך לבדוק tenancy, isolation, ביצועים ושילוב עם design system. AI-augmented BI יכול לסכם מגמות ולזהות חריגות, אך אינו מחליף Data Steward שמוודא שהמסקנה נשענת על נתונים נכונים.
הכלי הוא חלק קטן מהפרויקט. ה-semantic layer, איכות הנתונים וה-governance הם התשתית שמכריעה אם המשתמשים יאמינו לתוצאה.
מקרי שימוש אמיתיים ב-SaaS ובארגונים
BI טוב משנה החלטה מוגדרת. אם אי אפשר לומר איזו החלטה תשתנה כאשר הדשבורד יעלה, כנראה שהדרישה עדיין כללית מדי.
קוהורטים במוצר SaaS
השאלה העסקית היא אילו לקוחות נשארים לאורך זמן, ולא רק מאיזה ערוץ הגיעו. מחברים נתוני הרשמה, מקור ליד, שימוש בפיצ'רים, חבילה, חיובים ופעילות תמיכה. ניתוח קוהורטים עשוי להראות שלקוחות שהגיעו דרך שותף אינטגרציה מסוים שומרים 40% יותר, אך הנתון הזה מופיע בתרחיש שסופק כאן ללא מקור חיצוני מאומת ולכן אין להציגו כעובדה כללית או כמקרה לקוח מתועד.
ההחלטה שניתן לשנות היא הקצאת תקציב שיווק ושותפים. במקום להגדיל ערוץ לפי מספר לידים, בוחנים איכות לקוח לאורך זמן.
חיזוי נטישה בארגון B2B
השאלה אינה "כמה לקוחות נטשו", אלא מי נמצא בסיכון ומה אפשר לעשות לפני שהנטישה מתרחשת. מחברים usage events, פניות תמיכה, זמני תגובה, מסמכי מכירה וחידושי חוזים. מודל חיזוי ב-Python יכול לייצר רשימת לקוחות לבדיקה, אבל מנהל Customer Success צריך לקבל הסבר, לא רק ציון סיכון.
בתרחיש נפוץ, המודל מזהה שינוי בדפוס שימוש כשבועיים לפני עזיבה. זהו תרחיש עבודה, לא הבטחה לדיוק. ההחלטה משתנה כאשר הצוות מתעדף שיחת ערך או הדרכה על פני פנייה אקראית לכל בסיס הלקוחות.
דשבורד תפעולי בלוגיסטיקה
חברת לוגיסטיקה צריכה לדעת מה קורה עכשיו, לא רק מה קרה בסוף החודש. מקורות הנתונים יכולים לכלול הזמנות, מיקומי משלוחים, סטטוס נהגים, זמני איסוף, חריגות SLA ומרכזי הפצה.
הדשבורד מציג חריגות לפי אזור, מסלול וסוג משלוח. מנהל התפעול יכול להזיז משאבים לפני שה-SLA נשבר, במקום לנתח בדיעבד למה נוצר הפיגור. כאן זמן הרענון הוא חלק מדרישת המוצר, לא פרט טכני.
תובנות פיננסיות לדירקטוריון
הנהלה זקוקה לתמונה מאוחדת של הכנסות, התחייבויות, גבייה, הוצאות ויתרות. איחוד נתוני ERP, CRM ובנקאות מאפשר להבחין בין מכירה חתומה לבין כסף שנכנס בפועל.
הדשבורד אינו אמור להחליף את מערכת הכספים. הוא צריך להציג מקור מוסכם, עקבות audit והרשאות מתאימות. ההחלטה שנעשית טובה יותר היא תכנון תזרים, תעדוף השקעות והבנה של מגבלות מזומן, במקום הסתמכות על כמה קבצי Excel שנבנו בנפרד.
למה פרויקטי BI נכשלים גם עם הכלי הנכון
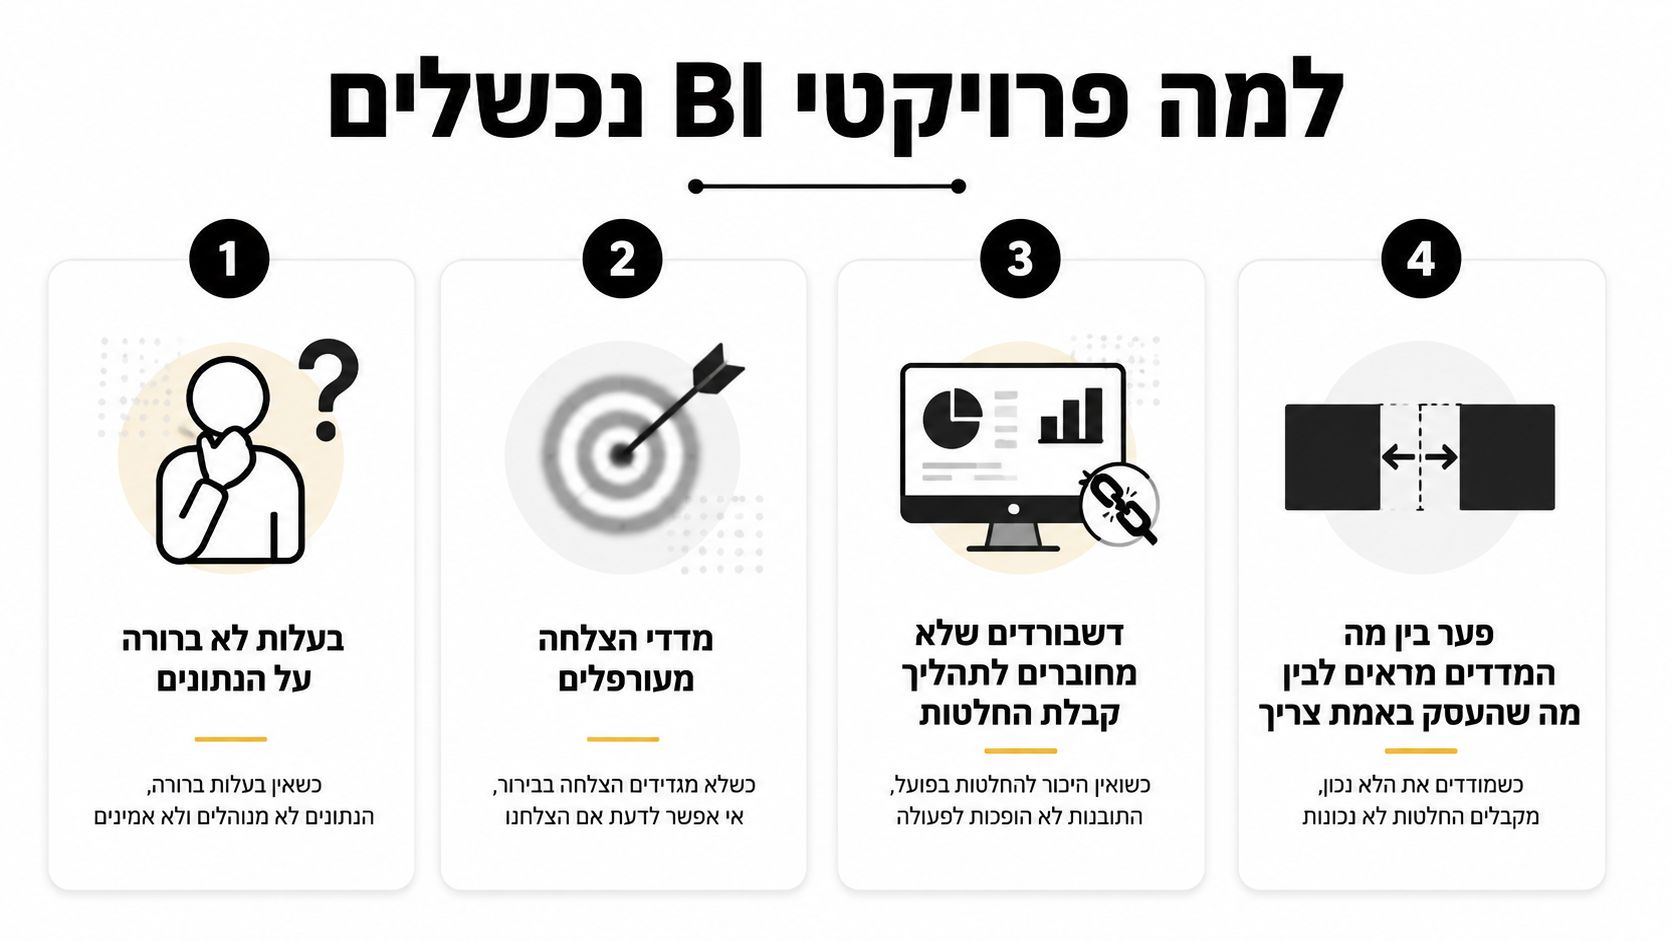
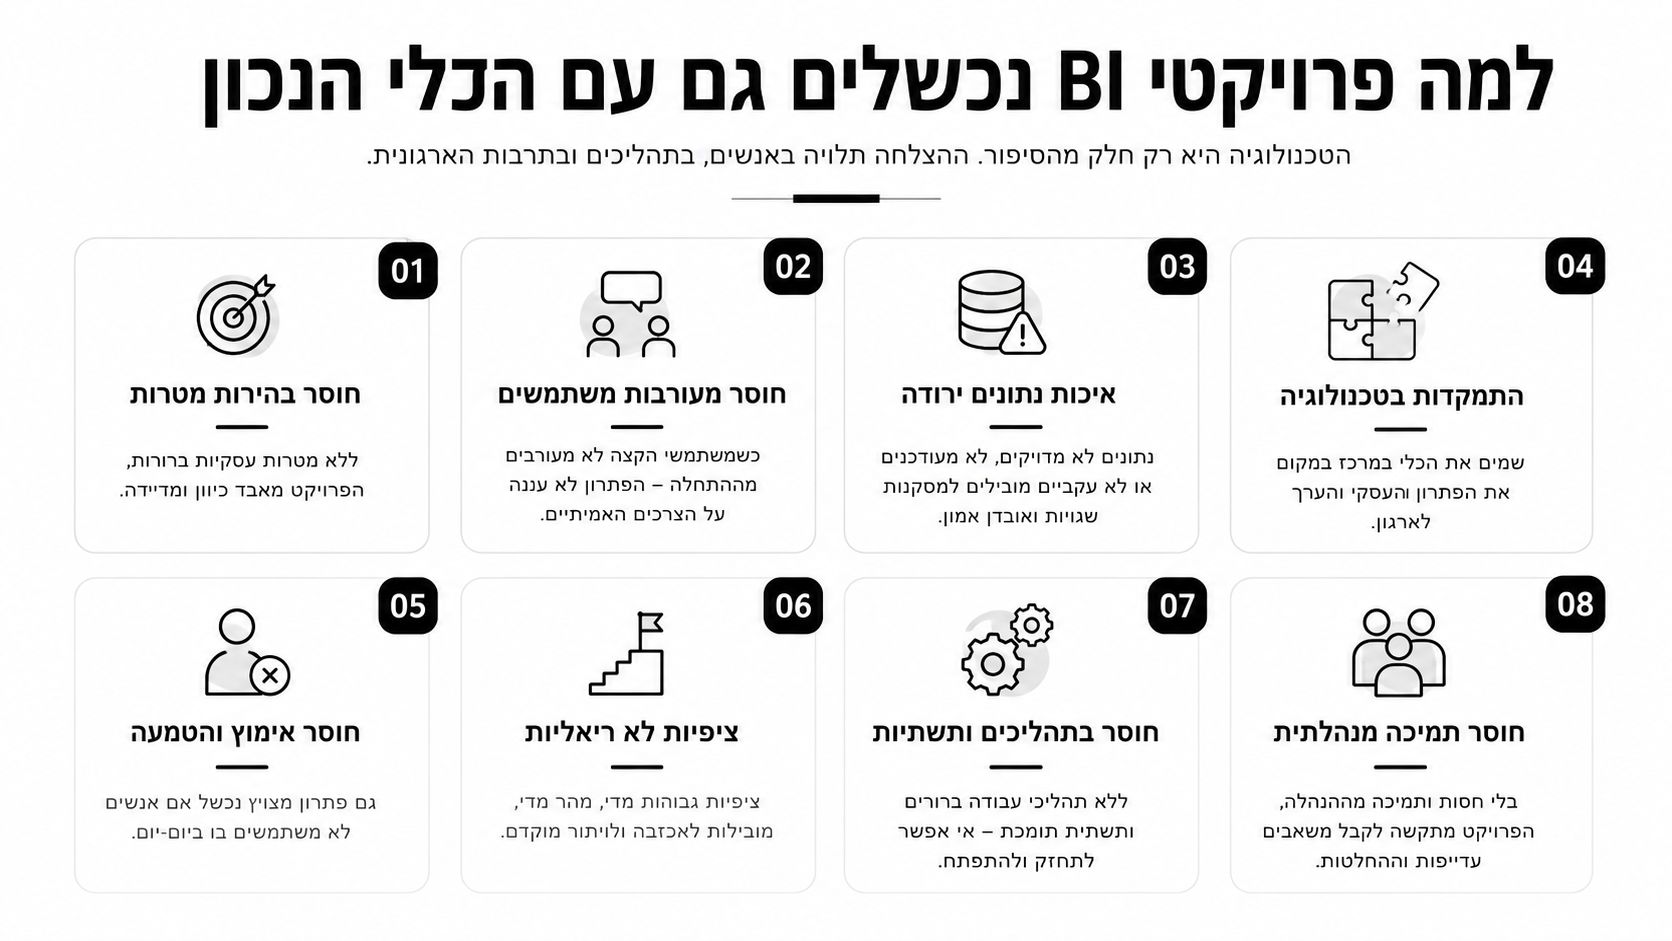
הכישלון בדרך כלל מתחיל לפני בחירת הכלי. ארגון יכול להטמיע Power BI, Tableau או Metabase, להשקיע בעיצוב ולחבר מקורות רבים, ועדיין לא לקבל שימוש אמיתי. הסיבה היא שהמערכת לא קיבלה בעלים, יעד או מקום קבוע בתהליך הניהולי.
בעלות לא ברורה
כאשר ערך מסוים משתנה, כולם יודעים למי לפנות כדי לתקן את התצוגה, אבל אף אחד לא אחראי למשמעות העסקית. צוות הנתונים טוען שהמקור תקין, צוות הכספים טוען שהחישוב שגוי, ומנהל המוצר משתמש במספר שלישי.
מינוי Data Steward לכל תחום פותר חלק מהעמימות. ה-Steward אינו חייב לבנות SQL, אבל הוא צריך לאשר הגדרה, מקור, תדירות עדכון והרשאות.
הצלחה שאי אפשר למדוד
"דשבורד להנהלה" אינו יעד מספיק. צריך להגדיר מראש אילו שאלות הוא עונה, מי משתמש בו, ומה אמור להשתנות בעקבותיו.
- שימוש: כמה משתמשים פעילים חוזרים לדשבורד לפי תפקיד והרשאה.
- מהירות: כמה זמן נדרש כדי לקבל החלטה או להפיק תשובה.
- עבודה ידנית: כמה שעות של איסוף, העתקה ואיחוד קבצים אפשר לצמצם.
- איכות: כמה חריגות, כפילויות או פערי הגדרה מתגלים לפני פרסום.
דשבורד שלא נכנס לשגרה
חברה יכולה להשיק דשבורד מרהיב שאף אחד לא פותח, מפני שהוא אינו מחובר לפגישה, לאחראי או לפעולה. אם מנהל מכירות ממשיך להגיע לישיבה עם קובץ משלו, ה-BI לא החליף את התהליך, הוא רק הוסיף מסך.
הפתרון הוא להכניס את הדשבורד לסדר היום הקבוע. כל KPI צריך להיות משויך לשאלה, לבעלים ולפעולה אפשרית.
פער בין נתונים להרגלים
לפעמים הנתונים מראים ירידה, אבל המנהלים ממשיכים באותה פעולה מפני שהם לא סומכים על המקור או על המודל. לא פותרים זאת באמצעות עוד גרפים. בונים שגרת בדיקה, מתעדים חריגות ומאפשרים לצוותים להשוות את המספר למקור תפעולי מוכר.
צ'קליסט להטמעה מוצלחת והצעד הבא
לפני שמקימים סביבת BI, עוצרים ומוודאים שהארגון מסוגל לענות על שאלות יסוד. לא צריך לפתור את כל הדאטה ביום הראשון, אבל צריך לבחור התחלה שאפשר למדוד ולתחזק.
- מיפוי מקורות: רשמו את מערכות ה-CRM, Billing, ERP, Product Analytics, APIs ובסיסי הנתונים. לצד כל מקור הגדירו בעלים, תדירות רענון, רגישות ואיכות ידועה.
- שלוש שאלות עסקיות: כתבו שלוש שאלות שהמערכת חייבת לענות עליהן. למשל, אילו לקוחות בסיכון, איפה נוצר עיכוב תפעולי, ומה מצב התזרים.
- הגדרת KPI: הסכימו על הנוסחה, מקור הנתונים, חלון הזמן והחריגים לפני שבונים ויזואליזציה.
- בחירת פלטפורמה: התאימו את הכלי לגודל הצוות, ליכולות הפיתוח, לדרישות אבטחת מידע ולמודל ההרשאות, לא לאיכות הדמו.
- Semantic layer מהיום הראשון: גם ב-MVP קטן, הגדירו מודלים עסקיים שמפרידים בין טבלאות גולמיות לבין מושגים שהמשתמשים צורכים.
- Data Steward: מנו אחראי לכל תחום, עם סמכות לאשר שינויי הגדרה ולתעד את מקור הנתונים.
- מדדי הצלחה: מדדו שימוש פעיל, זמן לקבלת החלטה, צמצום עבודה ידנית ואיכות נתונים. מדדים אלה אינם מוכיחים לבדם ROI, אבל הם מאפשרים לקשור אימוץ להשפעה תפעולית ולבדוק אם ההשקעה מתקדמת בכיוון הנכון.
- חיבור ל-AI בזהירות: רק אחרי שיש מקור אמת, הרשאות ונתונים עקביים, בדקו סיכום אוטומטי, חיזוי או Agentic AI שמפעיל אוטומציות עסקיות. AI על גבי נתונים לא מוסדרים מגדיל את מהירות הטעות.
בישראל קיימות עדויות לאימוץ מתקדם של AI, אך הנתונים גם מראים פערים בין ענפים ובין ארגונים. לפי הפרסום על שימוש עסקים ישראליים ב-AI, 39% מהעסקים השתמשו ב-AI בייצור מוצרים ושירותים, לעומת כ-28% ביוני 2025, ובקרב עסקים גדולים מעל 250 עובדים השיעור הגיע לכ-52%, לעומת 34% בגל הקודם. נתונים אלה אינם הופכים כל פרויקט BI למועמד אוטומטי ל-AI. הם כן מחזקים את הצורך לתכנן BI, אוטומציות ויכולות חיזוי כחלק מארכיטקטורת נתונים אחת.
להקשר נוסף, ניתוח המכון הישראלי לדמוקרטיה על אימוץ AI בישראל מציין כי 28% מהעסקים השתמשו ב-AI בחצי השנה האחרונה ו-17% השתמשו בשירותי AI בתשלום, בעוד שבהייטק ובפיננסים האימוץ הגיע לכ-60%. הנתונים מחזקים מסקנה מעשית: בנו תשתית שמתאימה לשלב הנוכחי של הארגון, אך השאירו מקום ל-data refresh תדיר, מודלי חיזוי וממשקי self-service analytics.
אם אתם רוצים לבדוק האם הארגון מוכן ל-BI, התחילו בפגישת אבחון קצרה: מיפוי מערכות, בחירת שאלות עסקיות וזיהוי החסם שמונע החלטות מבוססות נתונים היום. דרך האתר של מיסטרביט אפשר לבחון ייעוץ טכנולוגי, פיתוח תוכנה בהתאמה אישית, פתרונות AI או חיזוק צוות הפיתוח, בהתאם לארכיטקטורה וליעדים שלכם.
מיסטרביט מלווה סטארטאפים וארגונים בבניית תשתיות BI, מערכות SaaS, אוטומציות ופתרונות AI שמחוברים לתהליכים עסקיים אמיתיים. בקרו באתר מיסטרביט כדי לקבוע שיחה ולבדוק מהו הצעד הטכנולוגי הנכון עבור הארגון שלכם.