Load Testing למוצרים דיגיטליים: מדריך מקצועי
ביום ההשקה הכול נראה תקין. הפיצ'ר החדש קיבל חשיפה בקהילה ישראלית, אחר כך הופיע באתר חדשות, והתנועה התחילה לעלות מהר יותר מכל תחזית. בתוך זמן קצר ה־API החזיר 503, מסך הלקוח הלבין, והצוות עבר ללילה של restart ידני, הגדלת מכונות וניחושים לגבי צוואר הבקבוק.
ברוב המקרים, זו לא תקלה שנגרמה מבאג קלאסי. הקוד עבד בתנאי פיתוח, הבדיקות הפונקציונליות עברו, אבל אף אחד לא ידע כיצד המערכת מתנהגת כשמשתמשים רבים מפעילים במקביל חיפוש, התחברות, תשלום או יצירת מסמך. Load testing נועד לענות על השאלה הזאת לפני שהלקוחות עונים עליה במקומכם.
הצורך כבר אינו מוגבל לחברות ענק. במכרז של מינהל הרכש הממשלתי בישראל לשירות מנוהל לבדיקות איכות תוכנה נכללות במפורש בדיקת עומס קיצון לזיהוי נקודת השבירה, בדיקת עומס לווידוא יכולות scale up ו־scale down, וגם בדיקת עומסים לספרינט יחיד במתודולוגיית Agile בשיעור 3%. הדבר מופיע במסגרת השירות לבדיקות תוכנה ואוטומציה, וממחיש שבדיקות עומס הן כבר חלק מתהליך הפיתוח ולא רק שלב חירום לפני עלייה לאוויר.
תוכן עניינים
- למה המוצר שלכם קרס בדיוק כשהוא הצליח
- מה זה Load Testing ואיך הוא שונה מבדיקות אחרות
- שלוש מטריקות שחייבים להכיר לפני שמריצים
- איך לתכנן סדנת עומס שמשקפת מציאות
- השוואת כלי Load Testing מובילים
- בניית תשתית להרצת בדיקות בקנה מידה
- שילוב Load Testing בתוך CI/CD
למה המוצר שלכם קרס בדיוק כשהוא הצליח
השרשרת שמתחילה בחשיפה ומסתיימת בלילה לבן
תרחיש כזה מוכר במיוחד בסטארטאפים בשלבי Seed ו־Scale-up. הצוות משיק יכולת חדשה, מקבל חשיפה לא צפויה, ואז מגלה שהמערכת לא נשברת במקום שבו המפתחים חשבו שתישבר. ייתכן שה־CPU נראה סביר, אך connection pool של מסד הנתונים מתמלא. ייתכן שה־API מגיב מהר לבקשות בודדות, אבל queue פנימי מתארך כאשר משתמשים מבצעים פעולות במקביל.
הבעיה מתעצמת כאשר הניטור מתחיל מאוחר. אם הצוות רואה רק זמינות כללית או זמן תגובה ממוצע, הוא עלול לפספס הידרדרות אצל חלק מהמשתמשים. ממוצע יכול להיראות תקין גם כאשר מסלול קריטי סובל מתורים, נעילות או זמני התאוששות ארוכים.
Scaling תגובתי אינו תחליף לנתונים
הגדלת מספר ה־instances בזמן אירוע יכולה להחזיר את השירות לפעילות, אבל היא לא מוכיחה שהארכיטקטורה יציבה. Scaling תגובתי מטפל בסימפטום, ולעיתים אפילו מחמיר אותו כאשר כל instance חדש מייצר חיבורים נוספים למסד הנתונים או צורך מכסה מוגבלת בענן.
במקום לנחש, צריך למדוד:
- נקודת קיבולת: כמה עומס המערכת מחזיקה לפני שהביצועים מתחילים להידרדר.
- צוואר בקבוק: האם הבעיה נמצאת באפליקציה, במסד הנתונים, בתור, בשירות צד שלישי או ברשת.
- התאוששות: כמה זמן נדרש לשירות לחזור למצב תקין אחרי עומס חריג.
- נכונות התהליך: האם המערכת ממשיכה ליצור הזמנות, מסמכים או תוצאות AI נכונות, ולא רק להחזיר תשובה מהירה.
בשירותים ציבוריים, השאלה מקבלת משמעות נוספת. נתוני הגלישה של gov.il מציגים ניטור של תנועת משתמשים בזמן אמת באתר ממשלתי מרכזי. שירות כזה צריך להתמודד עם שעות שיא, קפיצות תנועה ואירועי עומס נקודתיים, ולא רק עם תרחיש יציב של MVP.
כלל עבודה: אם אינכם יודעים מה קורה למערכת תחת עומס משמעותי, אין לכם עדיין תכנית סקייל. יש לכם תקווה שהסקייל יעבוד.
עבור לקוח Enterprise או במסגרת מכרז ממשלתי, תקווה לא מספיקה. הלקוח עשוי לבקש ראיות ל־SLA, תרחישי עומס, מדדי התאוששות ותיעוד של מגבלות המערכת לפני חתימה. Load testing טוב הופך את השיחה מהבטחה כללית לנתונים שאפשר לקבל על בסיסם החלטה.
מה זה Load Testing ואיך הוא שונה מבדיקות אחרות
Load testing בודק כיצד מערכת מתנהגת תחת עומס צפוי ומוגדר. העומס יכול להיות מספר משתמשים וירטואליים, קצב בקשות, כמות כתיבות או שילוב של מסלולי שימוש. המטרה אינה למצוא כל שורת קוד חלשה, אלא לבדוק אם המערכת עומדת ביעד העסקי והטכנולוגי שהוגדר.
אנלוגיה שימושית היא כביש מהיר:
- Load Test: בדיקת התנועה הצפויה בשעות פעילות רגילות. הכביש צריך לשמור על זרימה וזמני נסיעה מקובלים.
- Stress Test: הוספת כלי רכב מעבר לקיבולת עד שהכביש נסתם. הבדיקה מחפשת את נקודת הקצה ואת אופן הכשל.
- Soak Test: תנועה רציפה לאורך זמן. כאן בודקים דליפות זיכרון, הצטברות תורים או הידרדרות הדרגתית.
- Spike Test: קפיצה חדה בתנועה, כמו אוטובוסים רבים שנכנסים בבת אחת לנתיב.
ההבדל המעשי חשוב. Load Test שואל, “האם השירות עומד ביעד שהעסק הגדיר?” Stress Test שואל, “איך השירות נשבר, ומה הוא עושה אחרי השבירה?” צוות שמריץ רק בדיקת עומס רגילה עלול לא לדעת כיצד המערכת מתאוששת. צוות שמריץ רק Stress Test עלול להשקיע זמן באיתור קצוות בלי להוכיח שהשימוש היומיומי עומד ב־SLO.
למה Unit Test לא חוסך בדיקת עומס
Unit Test בודק יחידת קוד בבידוד. הוא יכול לוודא שפונקציה מחזירה תוצאה נכונה, שטיפול בשגיאה עובד ושחישוב עסקי מסוים מדויק. הוא לא בודק מה קורה כאשר מאות תהליכים מנסים להשתמש באותו משאב, כאשר מסד הנתונים מתחיל להחזיר תשובות באיטיות, או כאשר שירות חיצוני מגביל קצב.
גם בדיקת API יחידה אינה משקפת user journey מלא. התחברות, חיפוש, בחירת פריט ויצירת הזמנה מפעילים שכבות שונות, ולעיתים כל שכבה מתנהגת אחרת תחת עומס. במערכות SaaS, מערכות AI ואוטומציות עסקיות, חשוב לבדוק גם תורים, workers, אחסון ומכסת ספקי מודלים.
למי שמחפש חומר מקצועי נוסף על פיתוח, ארכיטקטורה ותהליכי תוכנה, אפשר לעיין בבלוג של מיסטרביט.
סוגי בדיקות ביצועים והשאלות שהן עונות עליהן
| סוג בדיקה | שאלה עסקית |
|---|---|
| Load Test | האם המערכת עומדת בעומס הצפוי וביעדי ה־SLA? |
| Stress Test | היכן המערכת נשברת, ומהו זמן ההתאוששות? |
| Soak Test | האם הביצועים נשמרים לאורך פעילות ממושכת? |
| Spike Test | האם המערכת שורדת קפיצה חדה בתנועה? |
שלוש מטריקות שחייבים להכיר לפני שמריצים
לפני שבוחרים כלי או כותבים תסריט, מגדירים מה ייחשב הצלחה. שלוש המטריקות המרכזיות הן Latency, Throughput ו־Error Rate. הן מתארות היבטים שונים של המערכת, ולכן אין טעם להסתפק באחת מהן.
Latency מספרת מה המשתמש מרגיש
Latency הוא הזמן שחולף מרגע שליחת הבקשה ועד קבלת התשובה. במקום להסתמך על ממוצע, עדיף לבחון אחוזונים. p50 מתאר את מרכז ההתפלגות, ואילו p95 או p99 חושפים את המשתמשים שחווים את הקצוות האיטיים יותר.
ב־k6, המדד http_req_duration מייצג את משך הבקשה, והדוחות מציגים בין היתר את האחוזונים p50, p90, p95 ו־p99. בדוגמת ה־SLO הרשמית של Grafana מופיע סף p(95)<200 יחד עם rate<0.01 עבור שגיאות HTTP, כלומר פחות מ־1% שגיאות. הפרטים מופיעים בתיעוד בדיקות עומס ל־API ב־k6.
אל תבחרו סף רק משום שהוא נראה טוב בלוח. מסך דשבורד, חיפוש, תשלום ופעולת AI יכולים להצדיק יעדים שונים. לכל מסלול קריטי צריך להיות SLO שמחובר לחוויית המשתמש ולערך העסקי.
Throughput מודדת קיבולת
Throughput מתאר את קצב העבודה שהמערכת מעבדת, למשל בקשות לשנייה, עסקאות לדקה או הודעות שנכתבות לתור. הוא עונה על שאלה שונה מ־Latency. מערכת יכולה לשמור על זמן תגובה סביר לבקשות בודדות, אך לא לעבד קצב יציב כאשר מספר המשתמשים גדל.
המדידה צריכה להתייחס לאופי הפעולה. חיפוש שקורא ממטמון אינו דומה ליצירת הזמנה שמבצעת כתיבה, מפעילה ולידציה ומעדכנת כמה ישויות במסד הנתונים. לכן אין “מספר משתמשים” יחיד שמגדיר קיבולת. צריך לתאר את תמהיל הפעולות.
Error Rate מודדת עמידות
Error Rate מציינת כמה בקשות נכשלו, אך גם כאן ההקשר חשוב. שגיאת 5xx במסלול תשלום שונה משגיאה במסלול שאינו קריטי. כדאי להפריד בין שגיאות אפליקטיביות, timeouts, תשובות של שירותי צד שלישי ושגיאות תשתית.
הגדירו מראש את הסף שמכשיל את הבדיקה. ב־k6 אפשר להגדיר thresholds על מדדי ביצועים, כולל אחוזונים כמו p(99.99). אחוזון חייב להיות בטווח 0 עד 100, אחרת הבדיקה נעצרת בשגיאת parsing לפני הריצה, כפי שמוסבר בתיעוד הרשמי של thresholds ב־k6.
| מטריקה | הגדרה | סף בריא | סף התראה |
|---|---|---|---|
| Latency | זמן תגובה של בקשה | עומד ב־SLO של המסלול | חריגה באחוזונים שהוגדרו |
| Throughput | קצב עיבוד עבודה | קצב יציב תחת פרופיל העומס | ירידה או הצטברות תורים |
| Error Rate | שיעור בקשות שנכשלו | מתחת לסף העסקי | חריגה לפי סוג השגיאה והמסלול |
איך לתכנן סדנת עומס שמשקפת מציאות
סדנת עומס טובה מתחילה ביעד עסקי, לא בכלי. לפני שכותבים תסריט ב־JMeter, k6 או Locust, צריך להחליט איזה אירוע רוצים לדמות ומה ייחשב הצלחה. יעד כמו “המערכת צריכה להיות מהירה” לא מאפשר החלטת Go או No-Go.
מתחילים במסלולים קריטיים
ממפים את ה־user journeys החשובים למוצר:
- כניסה: התחברות, אימות והרשאת גישה.
- גילוי: חיפוש, סינון וטעינת נתונים.
- פעולה עסקית: רכישה, יצירת הזמנה או שליחת טופס.
- תהליך אסינכרוני: העלאת קובץ, הפעלת worker או יצירת תוצר AI.
- מסלול ציבורי: הגשת טופס בשירות ממשלתי או שימוש בשירות ללא חשבון.
לכל מסלול קובעים SLA או SLO, כולל זמן תגובה, שיעור שגיאות ותוצאה עסקית נכונה. המדריך המקצועי לבדיקות עומס מדגיש שבדיקה צריכה להתבצע תחת עומס ממוצע ושיא, לכלול בדיקת גבולות עומס, ניטור פעולות בעייתיות, זמני כשל וזמני התאוששות.
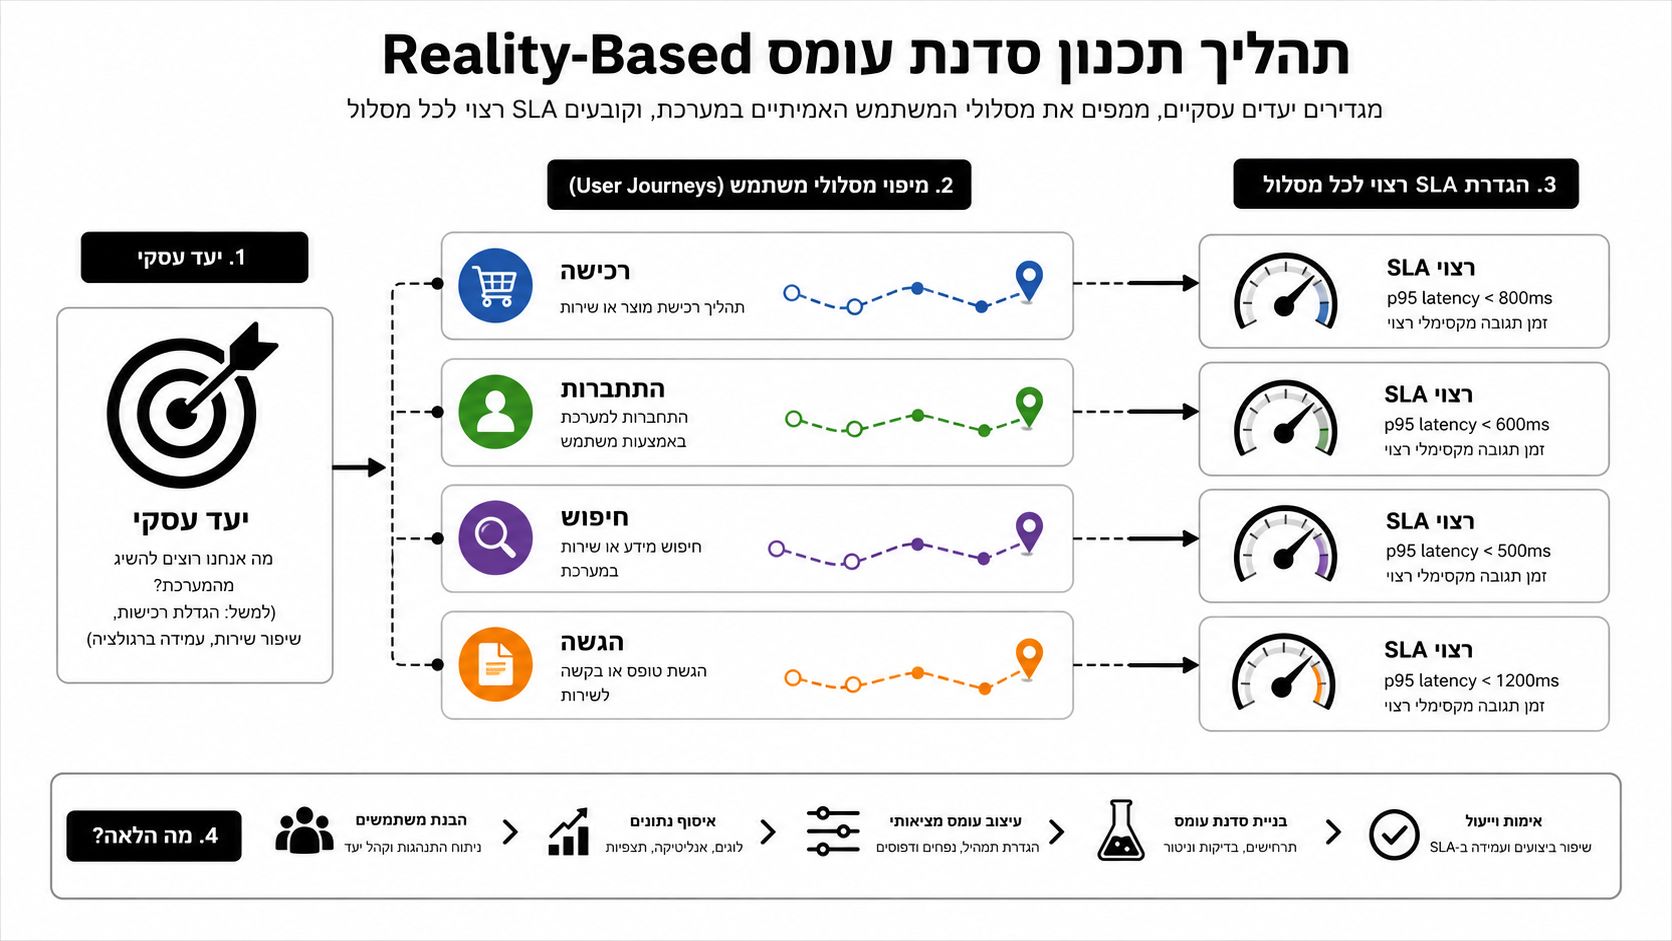
בונים פרופיל שימוש ולא מספר משתמשים מופשט
הפרופיל צריך להבחין בין משתמשים פעילים, זמני think time, אחוזי נטישה ונתונים עסקיים שונים. משתמש שמבצע חיפוש כל כמה שניות אינו דומה למשתמש שמתחבר, טוען דשבורד ומבצע פעולה אחת.
הכניסו לתרחיש גם אירועים שיווקיים ותפעוליים. קמפיין משקיעים, פרסום באתר חדשות, פתיחת מכרז או מועד הגשת בקשות יכולים לייצר Spike Test שונה לחלוטין מעומס יומיומי. במערכת עם multi-tenancy, כדאי לשלב tenants קטנים וגדולים כדי לבדוק אם לקוח אחד יכול לצרוך משאבים של אחרים.
סביבת הבדיקה חייבת להיות החלטה מודעת
AWS ממליצה להגדיר יעדים, לבחור כלי מתאים, לבנות סביבה דומה ל־production, להפעיל ניטור, להגדיר תרחישים ופרמטרים כמו משך הבדיקה ומספר המשתמשים, ולחזור על הבדיקות אחרי שינויי מערכת. העקרונות מופיעים במדריך AWS לתהליך load testing.
Staging מבודדת מקטינה סיכון, אך עלולה שלא לשקף מכסות, נתונים, הרשאות או תצורת production. בדיקה מול production מספקת אמינות גבוהה יותר, אך דורשת חלון מתואם, נתונים בטוחים, מנגנון עצירה וניטור של השפעה על משתמשים אמיתיים. תוצאה יפה בלוח אינה שווה הרבה אם התסריט השתמש בנתונים מלאכותיים, ללא cache, ללא שירותי צד שלישי וללא תהליכי רקע.
השוואת כלי Load Testing מובילים
הבחירה בכלי אינה תחרות פופולריות. שלושת הקריטריונים שמכריעים בפועל הם שפת התסריטים, אופן ההרצה והעומק שבו אפשר לנתח תוצאות. צוות Node.js ו־TypeScript עשוי להעדיף k6, בעוד שצוות Python ירגיש טבעי יותר עם Locust. בארגון שכבר מחזיק תשתית Java ותסריטי בדיקה ותיקים, מעבר לכלי חדש עלול לעלות יותר מהחיסכון התיאורטי.
JMeter מציע ממשק גרפי, קהילה רחבה ותמיכה בפרוטוקולים רבים. הוא מתאים לארגונים, לצוותי QA ולסביבות שבהן יש ידע קיים ותהליכי מכרז מסודרים. מנגד, ניהול עומסים גדולים דרך תהליכים עתירי זיכרון דורש תכנון של תשתית ההרצה, וה־GUI אינו המקום שבו כדאי לבצע את הריצה עצמה.
k6 מציע תסריטים ב־JavaScript, CLI נוח לעבודה אוטומטית וחיבור טבעי לעולם Grafana. הוא מתאים במיוחד לצוותי Web ו־SaaS שרוצים לשמור תסריטים ב־Git, להפעיל thresholds ב־CI ולחבר תוצאות למדדי תפעול. המחיר הוא צורך בבניית הרגלי עבודה חדשים לצוותי QA שמעדיפים ממשק גרפי.
Gatling מתאים לצוותים שמעדיפים תסריטים כקוד ו־DSL המבוסס על Scala. הוא מאפשר version control מלא ומעודד תחזוקה מסודרת, אך עקומת הלמידה פחות נוחה לצוות שלא עובד בשפה או בסגנון הזה. Locust, לעומתו, משתמש ב־Python ולכן מתאים למי שכבר כותב אוטומציות, שירותי backend או כלי בדיקה בשפה זו.
פתרונות ענן כמו BlazeMeter, Loader.io או AWS Distributed Load Testing מפחיתים את הצורך לתחזק מחוללי עומס, אך מוסיפים תלות בספק ועלות שתלויה בשימוש. הם שימושיים כאשר נדרשות נקודות הרצה מרובות או כאשר צוות קטן צריך להגיע לתוצאה במהירות. הם פחות מתאימים לארגון עם דרישות מחמירות על מיקום נתונים, שליטה בתשתית או עלויות צפויות.
| כלי | שפת תסריט | יתרון מרכזי | חיסרון מרכזי | מתאים ל |
|---|---|---|---|---|
| JMeter | Java וממשק גרפי | אקוסיסטם רחב וגמישות | ניהול משאבים מורכב בעומסים גדולים | ארגונים וצוותי QA |
| k6 | JavaScript | CLI, קוד ו־Grafana | פחות מתאים למי שחייב GUI | סטארטאפים וצוותי Web |
| Gatling | Scala DSL | תסריטים ניתנים לניהול ב־Git | עקומת למידה ייעודית | צוותי backend |
| Locust | Python | גמישות וקרבה לאוטומציה | דורש כתיבת קוד | צוותי Python |
| פתרונות ענן | משתנה | סקייל מהיר ללא תחזוקת מחוללים | תלות בספק ועלות לפי שימוש | צוותים קטנים ובדיקות מבוזרות |
בניית תשתית להרצת בדיקות בקנה מידה
הרצת עומס מהמחשב האישי היא מלכודת נפוצה. אם מחולל העומס מגיע למגבלת CPU, זיכרון או רשת, התוצאות משקפות את הלפטופ ולא את האפליקציה. במקרה כזה אפשר להסיק שהשרת איטי, אף שבפועל המחולל לא הצליח לשלוח את הבקשות בקצב הנדרש.
הפרידו בין מערכת הבדיקה למערכת הנבדקת. מחוללי העומס צריכים להיות עצמאיים, ניתנים להרחבה ומנוטרים. במידת הצורך, פזרו אותם גיאוגרפית כדי למדוד latency רלוונטי למשתמשים, אך תעדו את ההשפעה של מרחק, ספק ענן וניתוב רשת.
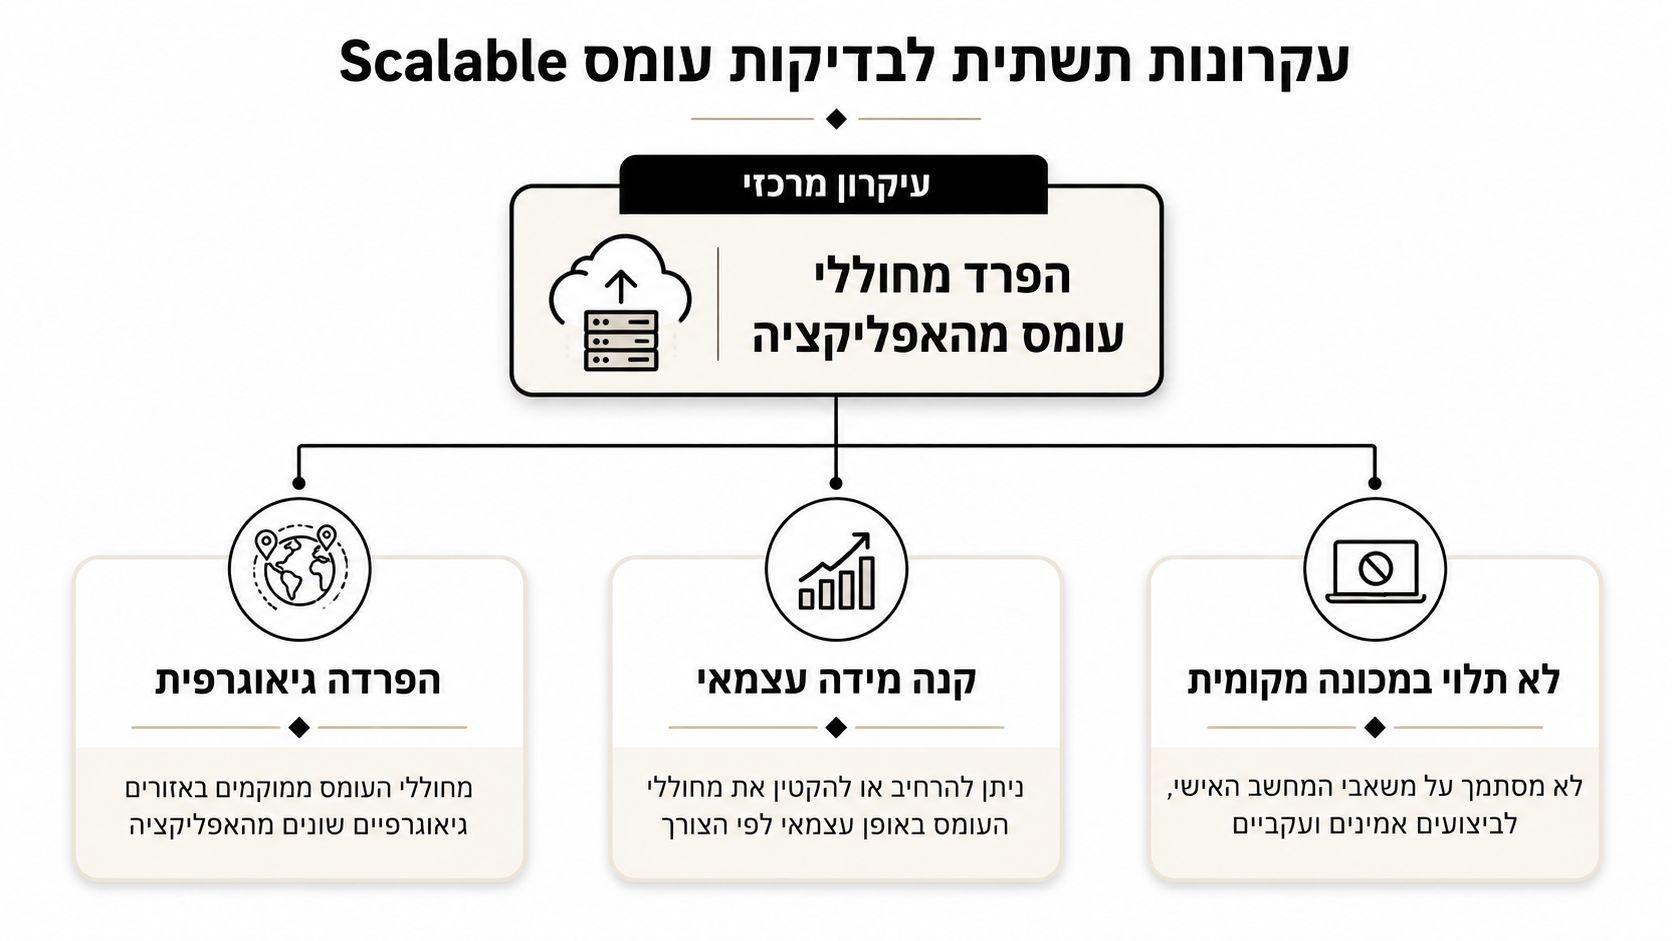
עצמאות המחולל חשובה יותר מגודל המכונה
במקום להסתמך על מכונה יחידה וחזקה, לעיתים עדיף להשתמש בכמה instances קטנים, עם ramp-up מדורג ורשת מבוקרת. כך אפשר להרחיב את כוח ההזרקה בלי ליצור נקודת כשל אחת. k6 Cloud או Grafana Cloud מספקים מחוללי עומס מנוהלים, ואילו בסביבה מקומית אפשר להריץ קונטיינרים של Locust או Gatling על Kubernetes.
לפני כל ריצה משמעותית, בצעו baseline לתשתית עצמה. מדדו כמה בקשות היא יכולה לייצר, כיצד היא מתנהגת כאשר מוסיפים מחוללים ומהו קצב השגיאות שלה ללא קשר לאפליקציה. ללא baseline, קשה להבדיל בין מגבלה של התשתית לבין בעיה במוצר.
הפרדה תפעולית: מחולל עומס הוא מוצר תשתיתי בפני עצמו. הוא צריך ניטור, הרשאות, תקציב, תיעוד ותהליך עצירה.
למה CI/CD עדיף על אירוע חד־פעמי
בדיקה לפני השקה תופסת בעיות של הגרסה הנוכחית. היא לא תופסת בהכרח regression שנוצר בשבוע הבא, שינוי ב־ORM, אינדקס שהוסר, תור שהוגדר אחרת או מודל AI שצורך יותר זמן. לכן load testing צריך להיכנס ל־CI/CD בהדרגה, לא להישאר פרויקט מיוחד שמופעל רק כאשר מנהל טכנולוגי נזכר בו.
התחילו בבדיקה קטנה, עם נתיב אחד ומדדי הצלחה ברורים. לאחר שהצוות סומך על התוצאה, הרחיבו את מספר התרחישים, את האבחון ואת תשתית ההרצה. AWS עצמה ממליצה לבצע בדיקות חוזרות לאחר כל שינוי מערכת, ולא להסתפק בריצה יחידה.
שילוב Load Testing בתוך CI/CD
לסטארטאפ בשלב Seed אין צורך להתחיל בפלטפורמה מורכבת. הוא כן צריך להחליט איזה שינוי לא יכול להיכנס ל־main אם הוא פוגע בביצועים. ההחלטה הזאת הופכת performance testing מפעילות של אדם אחד לתהליך שהצוות כולו יכול להפעיל ולתחזק.
שני מסלולים, שתי מטרות
Smoke Test קצר מתאים לכל Pull Request. הוא יכול להפעיל תרחיש קריטי בעומס מוגבל, לוודא שה־API זמין ולבדוק שאין פגיעה ברורה ב־thresholds. הבדיקה צריכה להיות מהירה מספיק כדי לא לעכב מפתחים, אך עשירה מספיק כדי לתפוס שינוי בסיסי בהתנהגות.
Full Load Test מתאים לריצה לילית או לאחר merge ל־main. הוא כולל תמהיל משתמשים, ramp-up, ניטור תשתית ושמירת תוצאות להשוואה. חברות רבות נופלות בפער שבין שני המסלולים. ה־smoke עובר, אבל אף אחד לא מריץ בדיקה שמדמה תנועה משמעותית לפני השקה.
החלטות שצריך לקבל מראש
- סף הכשל: האם pipeline נכשל רק כאשר יש הפרת SLO, או גם כאשר נרשמת הידרדרות עקבית מול baseline.
- תקציב זמן: בדיקה קצרה על כל PR, ובדיקה רחבה יותר בחלון שמאפשר תשתית מבוזרת.
- מיקום ההרצה: runner מקומי מפשט התחלה, אך Kubernetes נפרד מספק בידוד ושליטה טובים יותר.
- שמירת תוצאות: שמרו תוצאות ב־Prometheus ו־Grafana, או ב־blob storage, כדי להשוות בין גרסאות ולא להסתמך על צילום מסך.
- אבחון: חברו את תוצאות הבדיקה ל־APM, לוגים, מדדי מסד נתונים ותורים.
ב־k6 מגדירים thresholds כחלק מהקוד, ולכן אפשר להפוך חריגה ל־exit status שמכשיל את ה־pipeline. ב־Gatling אפשר לנהל תסריטים וקריטריונים באותו repository של הקוד. בשני המקרים, הערך מגיע מהשוואה עקבית ולא מהרצה מרשימה אחת.
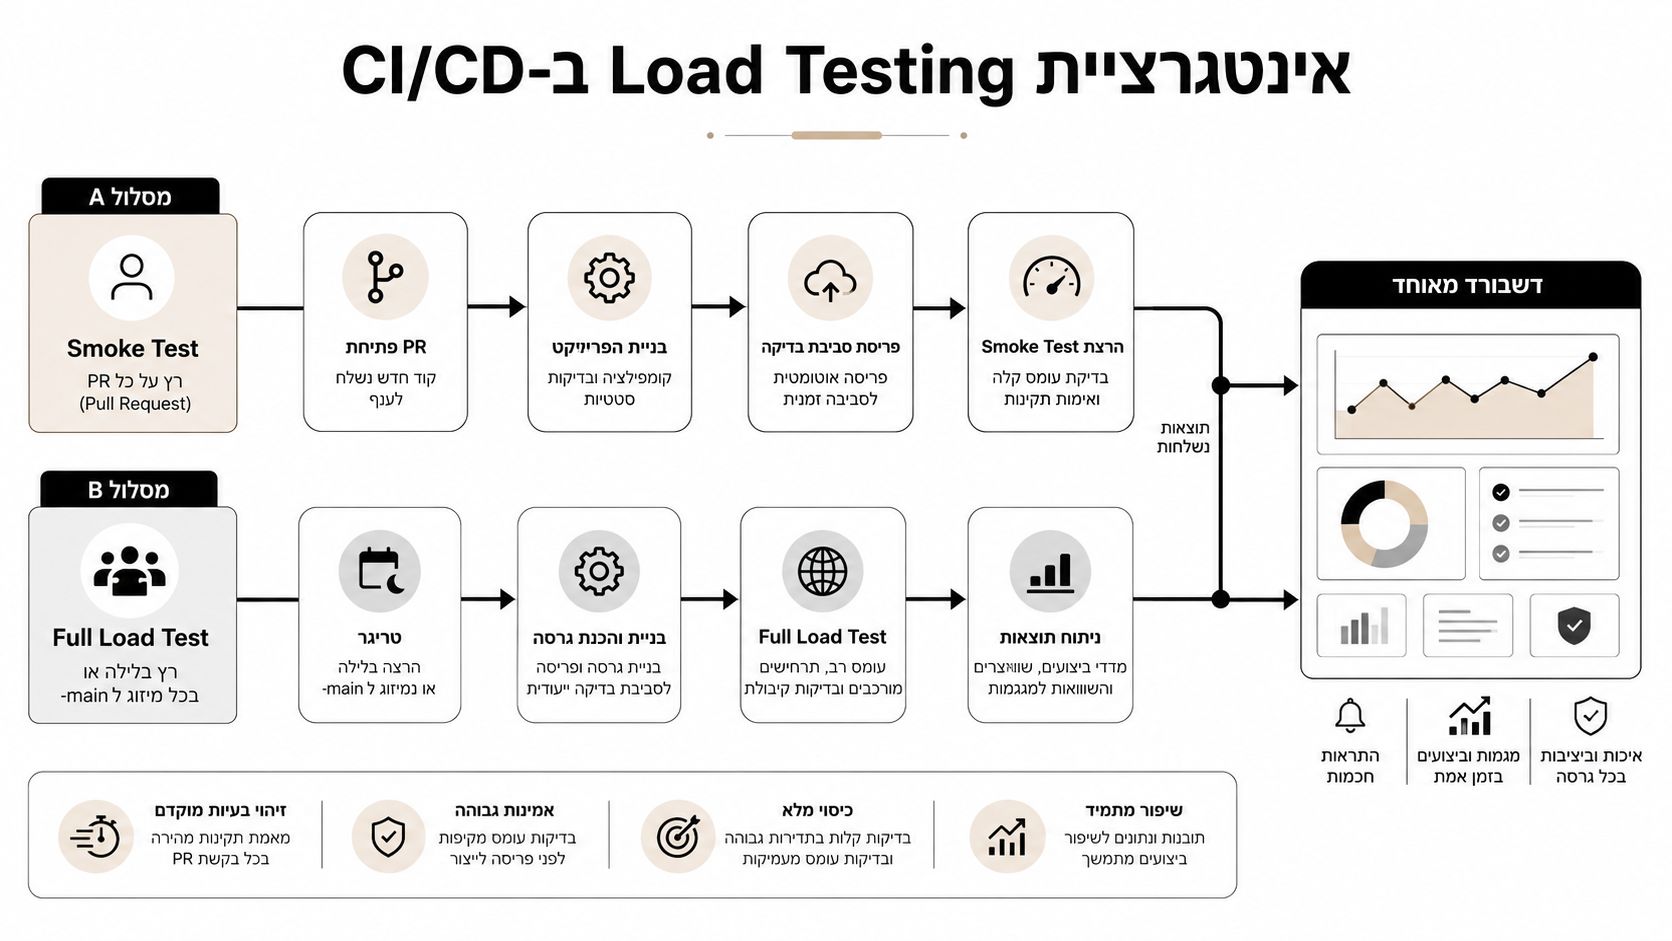
Workflow מעשי לצוות קטן
המסלול יכול להיראות כך:
- מפתח פותח PR.
- GitHub Actions או GitLab CI מריצים Smoke Test על השירות הקריטי.
- התוצאות נשלחות ל־Grafana או נשמרות באחסון אובייקטים.
- ה־pipeline משווה את התוצאה ל־baseline ומציג חריגות.
- לאחר merge ל־main, ריצה רחבה יותר מופעלת מסביבה מבודדת.
- הצוות בודק את ה־dashboard מול CPU, זיכרון, DB, תורים ושגיאות.
- שינוי שחורג מהיעד מקבל triage לפני פריסה.
Google Cloud ממליצה לבצע בדיקות לעומסים קריטיים שלושה עד חמישה חודשים לפני אירוע שיא, לבדוק מראש השלכות של quotas ועלויות, להגדיר Cloud Billing budget alerts, להעריך את התוצאות לאחר כל בדיקה, להשתמש ב־Capacity Planner ולבקש הגדלת quota לפי הצורך. ההמלצות מופיעות במדריך Google Cloud לבדיקות עומס לקראת אירועי שיא.
התחילו מ־LGTM gate פשוט על הסקריפט הקריטי ביותר. לאחר שהצוות לומד לפרש תוצאות, הוסיפו מסלולים, תשתית והיסטוריה. תהליך קטן שעובד בכל שינוי עדיף על מערכת שאפתנית שאיש אינו מפעיל.
מיסטרביט מסייעת לסטארטאפים ולארגונים לתכנן ולהטמיע load testing כחלק מארכיטקטורת המוצר, הענן ו־CI/CD, כולל פיתוח Web, מובייל, SaaS ופתרונות AI. אם אתם צריכים ייעוץ טכנולוגי, פיתוח תוכנה או Team Extension כדי להוכיח סקייל ולבנות תהליך אמין, בקרו במיסטרביט ותאמו שיחה מקצועית.