מערכות בינה עסקית: מדריך ארכיטקטורה והטמעה לארגונים
בלא מעט ארגונים, ישיבת הנהלה נראית אותו דבר. המנכ״ל שואל למה הרווחיות נשחקת, סמנכ״ל המכירות מציג מספר אחד, מנהלת השיווק מציגה מספר אחר, והכספים שולפים אקסל שלישי שנסגר בכלל על תאריך חתך שונה. כולם עובדים קשה, אבל כל אחד עובד מול גרסה אחרת של המציאות.
זה הרגע שבו מבינים שהבעיה אינה מחסור בדוחות. הבעיה היא היעדר תשתית. מערכות בינה עסקית לא נמדדות לפי כמה גרפים יש במסך, אלא לפי שאלה פשוטה יותר: האם ההנהלה יכולה לקבל החלטה על בסיס נתון מוסכם, עקבי וזמין בזמן.
בארגונים טכנולוגיים, ובעיקר בחברות SaaS, מוצרי Web ומובייל, סטארטאפים בצמיחה וארגונים עם כמה מערכות ליבה, הפער הזה הופך מהר מאוד לבעיה עסקית. ברגע שהמידע מפוזר בין CRM, מערכת פיננסית, מסדי נתונים אפליקטיביים, גיליונות ידניים וכלי אוטומציה, אין דרך אמינה להבין מה קורה בלי שכבת נתונים מסודרת. כאן מתחיל ההבדל בין התקנת כלי BI לבין בניית מנגנון קבלת החלטות שעובד במציאות.
תוכן עניינים
- למה הארגון שלכם באמת צריך מערכות בינה עסקית
- הארכיטקטורה שמאחורי מערכות בינה עסקית מודרניות
- בחירת כלי דשבורדים וממשל נתונים ארגוני
- תרחישי שימוש עסקיים שמניעים צמיחה
- הפער בין בינה עסקית לבינה מלאכותית בארגון
- מפת דרכים לבחירה והטמעה של פתרון BI
- סיכום והמלצות פרקטיות למקבלי החלטות
למה הארגון שלכם באמת צריך מערכות בינה עסקית
הסימן הראשון לכך שהארגון צריך BI אינו בהכרח גידול בכמות הנתונים. הסימן הוא ויכוחים חוזרים על מספרים בסיסיים. כמה לקוחות פעילים יש. מהו זמן האספקה בפועל. האם הקמפיין רווחי. למה יש פער בין ההכנסות המדווחות למערכת התפעולית לבין מה שמופיע בדוח ההנהלה.
איפה הכאב העסקי באמת מתחיל
בשלב מוקדם, ארגונים מסתדרים עם דוחות ידניים. אנליסט אחד מוציא נתונים, מנהל מוצר משלים עם CSV, ומנהלת כספים מוסיפה תיקונים. זה עובד עד שזה מפסיק לעבוד.
אחרי נקודה מסוימת, כל תיקון ידני מייצר עוד תלות. כל טבלת עזר הופכת לגרסה מקומית של האמת. כל KPI מקבל שתי הגדרות. במצב כזה, גם מנהלים טובים מקבלים החלטות חלשות, פשוט כי שכבת המידע לא אמינה.
כלל אצבע מעשי: אם אותה שאלה עסקית מקבלת תשובות שונות משלוש מחלקות, אין לכם בעיית דשבורד. יש לכם בעיית נתונים.
הערך של מערכת BI אמיתית הוא לא רק נוחות. היא בונה אמת ארגונית אחת. במקום שיווק שיראה המרות ממערכת אחת, מכירות שיספרו עסקאות בדרך אחרת, ותפעול שיעבוד עם סטטוס אחר לגמרי, מגדירים מודל נתונים מוסכם ומגישים אותו לכולם.
מתי ארגון בשל להטמעת BI
לא כל חברה צריכה להתחיל במחסן נתונים עצום. אבל יש כמה מצבים שבהם דחייה כבר עולה כסף:
- ריבוי מערכות מקור: CRM, ERP, מערכת חיוב, מוצר SaaS, אתר, אפליקציה וכלי תמיכה.
- החלטות תכופות עם תלות בין מחלקות: מחיר, מלאי, שימור לקוחות, תחזית הכנסות.
- עבודה ידנית שחוזרת כל שבוע: הורדת קבצים, איחוד אקסלים, תיקון פורמטים, הצלבת שדות.
- חוסר אמון במספרים: הנהלה שמבקשת “בדיקה מחדש” כמעט על כל דוח.
בישראל, האימוץ של יכולות AI ונתונים כבר אינו שולי. לפי נתוני הלשכה המרכזית לסטטיסטיקה שפורסמו ב-2025, 28% מהעסקים בישראל דיווחו על שימוש בבינה מלאכותית כחלק אינטגרלי מהפעילות העסקית, ו-32% מהעובדים מועסקים בעסקים כאלה. עוד עלה כי כ-16% מהעסקים שילמו על כלי בינה מלאכותית, ו-63% מהמשתמשים דיווחו על חיסכון בזמן, 50% על שיפור במוצרים ו-38% על צמצום התלות בגורמים חיצוניים לפי סקירת הלמ״ס והסוכנות לעסקים קטנים ובינוניים.
המספרים האלה חשובים לא כי AI ו-BI זה אותו דבר, אלא כי הם מראים שהארגון הישראלי כבר עבר את שלב הסקרנות. מי שלא יבנה תשתית מסודרת יישאר עם הרבה כלים ומעט שליטה.
הארכיטקטורה שמאחורי מערכות בינה עסקית מודרניות
מערכת BI טובה נראית פשוטה למשתמש. מאחורי הקלעים היא כמעט אף פעם לא פשוטה. מי שמדלג על הארכיטקטורה בדרך כלל משלם אחר כך בביצועים, באמינות ובעלויות ענן.
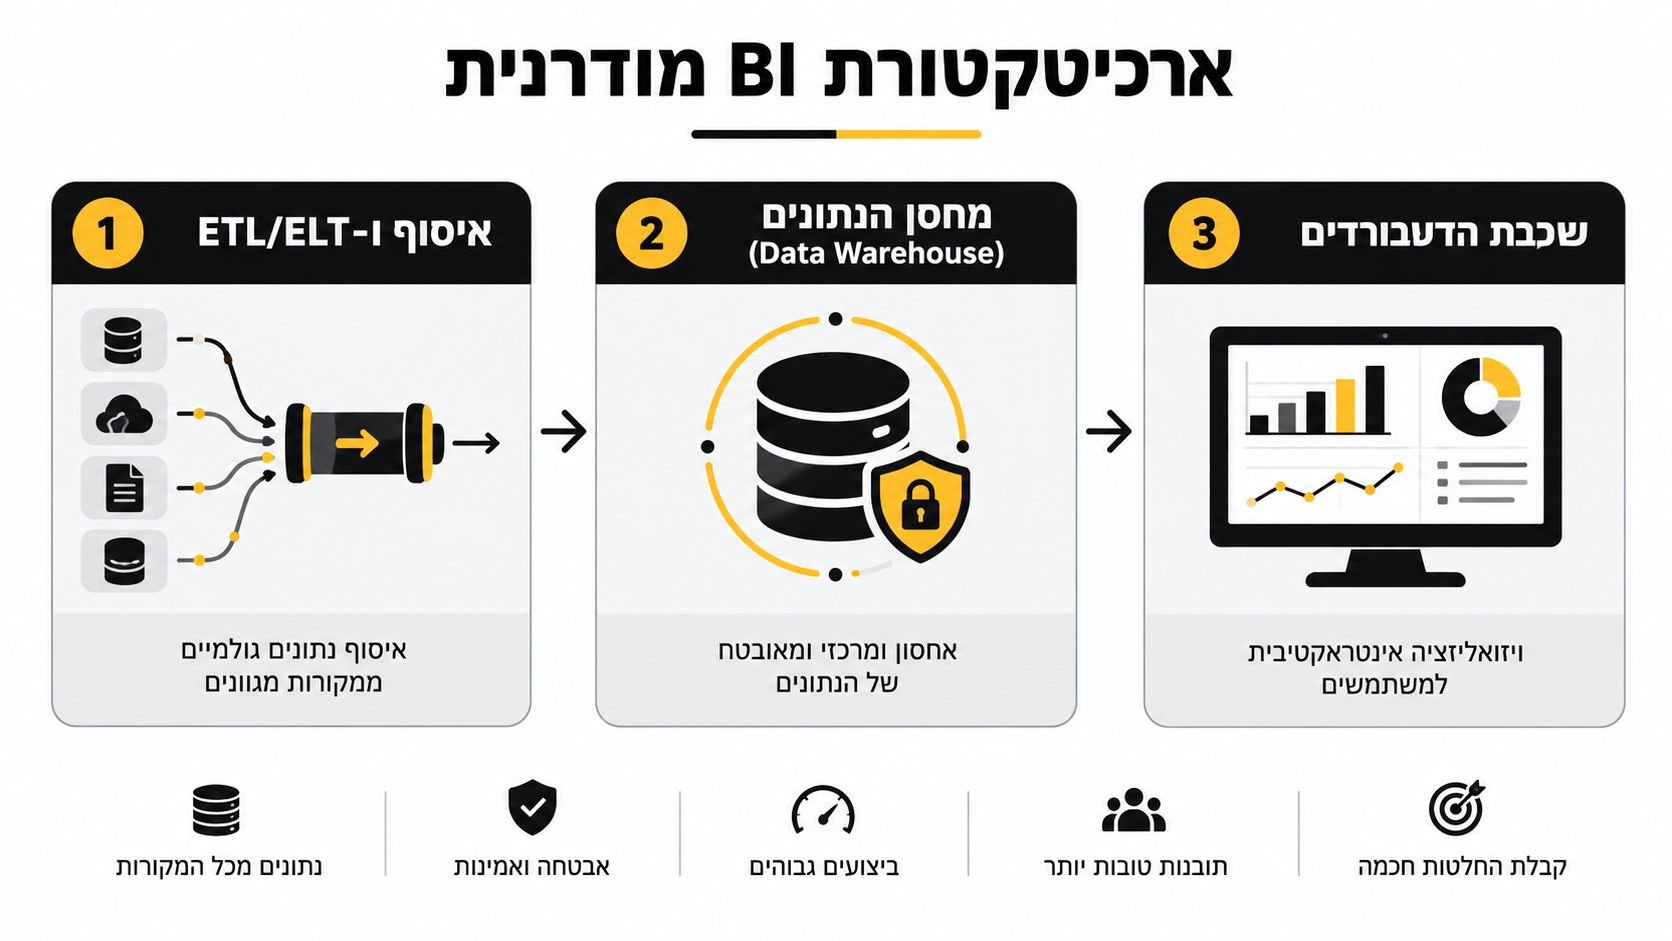
שכבת האיסוף והטרנספורמציה
השכבה הראשונה היא Ingestion. כאן מושכים נתונים ממערכות המקור: בסיסי נתונים אפליקטיביים, CRM, מערכות פיננסיות, לוגים, מערכות SaaS חיצוניות ו-API פנימיים. זה המקום שבו מחליטים אם עובדים בגישת ETL או ELT.
ETL מתאים כשצריך לנקות, לאחד ולהחיל חוקים לפני שהמידע נכנס למחסן. ELT מתאים כשמעוניינים לטעון מהר יותר ליעד ואז לבצע טרנספורמציות בתוך סביבת האחסון עצמה. אין פה תשובה אחת נכונה. אם מערכות המקור מבולגנות, ETL מוקפד יחסוך כאב. אם הקצב חשוב ורוצים גמישות אנליטית גבוהה, ELT יהיה לרוב עדיף.
בפועל, רוב הארגונים משלבים. נתונים רגישים או רועשים עוברים עיבוד מוקדם, ונתונים אחרים נכנסים גולמיים יותר לשכבת staging. צוותי Data Engineering ו-backend צריכים לחשוב כאן כמו בוני מוצר. Schema drift, שדות חסרים, מזהים כפולים וטעויות timezone הם לא “בעיות דאטה”. אלה תקלות מוצר לכל דבר.
שכבת האחסון
השכבה השנייה היא Storage, בדרך כלל Data Warehouse. כאן נבנית היסטוריה, נוצרת עקביות, ומוגדרים מודלים שעליהם הארגון יסתמך. זו גם הסיבה שמערכות BI לא אמורות לרוץ ישירות על מסד הנתונים התפעולי.
שאילתות BI כבדות על מערכת OLTP פוגעות במערכת חיה. אם אתר המכירות, מערכת ההזמנות או ה-ERP חולקים עומס עם הדוחות של ההנהלה, מישהו ישלם על זה. בדרך כלל הלקוחות או אנשי התפעול.
מחקר אקדמי על תכנון סכמות למחסני נתונים מגדיר את מחסן הנתונים כתשתית המרכזית של מערכות BI, ומציג גישות של המרה אוטומטית מסכמות יחסיות לסכמת מחסן נתונים מבוססת גרפים כדי לשפר עקיבות בין מקור ליעד ולצמצם חוסר עקביות בטרנספורמציות, כפי שמסוכם ב-סקירה על ארכיטקטורת Data Intelligence ו-BI בישראל. המשמעות המעשית ברורה: כשהארגון מאחד פיננסים, מכירות ותפעול, כל אוטומציה שמקטינה טעויות מיפוי שווה הרבה יותר מכל ויזואליזציה נוצצת.
שכבת האחסון היא המקום שבו הארגון מחליט אם הוא רוצה “דוחות” או “תשתית”.
שכבת ההגשה למשתמשים
השכבה השלישית היא Serving. כאן יושבים כלי הדשבורדים, שכבות semantic, APIs אנליטיים ולעיתים גם אפליקציות מותאמות אישית. זה החלק שכולם רואים, אבל הוא חייב להישען על השכבות שמתחתיו.
במוצרים מורכבים אני מעדיף לחשוב על שכבת Serving כעל מוצר נפרד. יש לה משתמשים, הרשאות, latency סביר, versioning ולעיתים גם צרכנים חיצוניים. אם בונים פורטל SaaS ללקוחות, אפליקציית Web פנימית ב-React, או שכבת API ב-Node.js/Python שמגישה מדדים למובייל, כדאי לנהל את זה כמו כל מערכת תוכנה אחרת.
רשימת הבדיקות שכדאי לאשר לפני העלייה לאוויר:
- הפרדה עומסית: שאילתות אנליטיות לא נוגעות בביצועי המערכות התפעוליות.
- איכות נתונים: לכל KPI יש owner עסקי והגדרה טכנית.
- התאוששות מתקלות: כשל ב-pipeline לא מוחק היסטוריה ולא שובר דשבורדים בשקט.
- עלות: כל טרנספורמציה כבדה וכל שאילתה לא ממוטבת יופיעו בסוף בחשבון הענן.
בחירת כלי דשבורדים וממשל נתונים ארגוני
כשארגון אומר “אנחנו צריכים BI”, הוא לרוב מתכוון לדשבורדים. זו התחלה לגיטימית, אבל זו גם אחת הטעויות השכיחות. הדשבורד הוא שכבת ההצגה. אם מאחוריה אין ממשל נתונים מסודר, הארגון רק יעטוף בלגן קיים בעיצוב יפה יותר.
כלי מדף מול פיתוח מותאם
כלי מדף כמו Power BI, Looker או Tableau נותנים מהירות התחלתית טובה. אפשר להרים דוחות מהר, לחבר מקורות נפוצים ולהתחיל לעבוד בלי לבנות frontend מלא מאפס. עבור ארגון שצריך להוכיח ערך מוקדם, זה לעיתים הצעד הנכון.
פיתוח מותאם אישית מתאים כאשר הדשבורד הוא חלק ממוצר, כאשר נדרשת חוויית משתמש ייחודית, או כשיש דרישות הרשאה, workflow או embedded analytics שכלי מדף לא נותנים בצורה מספקת. אז בונים שכבת SaaS ייעודית, בדרך כלל עם React או Vue בצד הלקוח ו-Node.js או Python בצד השרת.
השוואת גישות להנגשת נתונים
| קריטריון | כלי BI מדף (PowerBI/Looker) | פיתוח מותאם אישית (Custom SaaS) |
|---|---|---|
| זמן עלייה ראשוני | מהיר יחסית | ארוך יותר |
| גמישות UX | מוגבלת למסגרת הכלי | גבוהה מאוד |
| התאמה למוצר חיצוני | אפשרית, אך לא תמיד חלקה | טבעית יותר |
| שליטה בהרשאות מורכבות | קיימת, אך תלויה בכלי | מלאה לפי צרכי המוצר |
| תחזוקה | פחות קוד אפליקטיבי | יותר אחריות הנדסית |
| תלות בספק | גבוהה יותר | תלויה בארכיטקטורה שתבחרו |
| עלויות נסתרות | רישוי, צריכה, ממשקים | פיתוח, תחזוקה, DevOps |
מה באמת מכריע את הצלחת הפרויקט
הגורם הקריטי אינו אם בחרתם Looker או מסך React. הגורם הקריטי הוא Data Governance. בלי זה, גם הדשבורד הכי טוב יפיק מדדים סותרים.
במסגרת התוכנית הדיגיטלית הלאומית, גופי ממשל בישראל מציינים צורך מפורש לשלב מערכות מידע, לשפר איתור ושיתוף מסמכים והחלטות, ולעודד שימוש בכלי BI בתהליכי קבלת החלטות. ברמה המעשית זה מחייב KPI definitions אחידים, קטלוג ארגוני ומנגנוני lineage כדי למנוע מדדים סותרים בין יחידות עסקיות, כפי שמתואר ב-סקירה על יישומי BI ו-Data Analytics בישראל.
מה זה אומר בשטח:
- הגדרת KPI אחידה: “לקוח פעיל”, “הזמנה מאושרת” ו”הכנסה מוכרת” חייבים לקבל הגדרה אחת.
- קטלוג ארגוני: אנשים צריכים לדעת מאיזה מקור הגיע כל שדה, מי הבעלים שלו ומה רמת האמינות שלו.
- Lineage אמיתי: כשל במדד לא נפתר בניחוש. צריך לדעת דרך אילו טבלאות, jobs וטרנספורמציות הוא עבר.
- הרשאות גרעיניות: סמנכ״ל אזורי, מנהל מוצר, כספים ושותף חיצוני לא אמורים לראות את אותה תמונה.
הבחנה חשובה: Self-service BI עובד רק אחרי שהארגון הגדיר גבולות. בלי מילון נתונים, self-service הופך מהר מאוד ל-self-confusion.
תרחישי שימוש עסקיים שמניעים צמיחה
מערכות בינה עסקית לא מצדיקות את עצמן בגלל הטכנולוגיה. הן מצדיקות את עצמן כשהן משנות החלטות יומיומיות. לא החלטות “אסטרטגיות” פעם ברבעון, אלא החלטות של שיווק, תפעול, כספים ומוצר בכל שבוע.
שיווק וצמיחה
בצוותי שיווק, BI טוב מחבר בין ערוץ, קמפיין, קבוצת משתמשים, התנהגות במוצר ותוצאה עסקית. לא רק כמה לידים נכנסו, אלא אילו לידים הפכו להזדמנויות, מי נשאר פעיל, ואיפה נוצרה נטישה.
בחברות SaaS זה המקום שבו ניתוח cohort, חישובי LTV/CAC וניתוח onboarding מפסיקים להיות תרגיל אקסל. כשהנתונים מחוברים נכון, מנהל מוצר יכול לראות אם פיצ׳ר מסוים מעלה שימושיות אצל לקוחות מסוימים, והשיווק יכול להפסיק להגדיל תקציב לקהל שנרשם יפה אבל לא נשאר.
מי שמחפש זוויות נוספות על עבודה עם דאטה, מוצר ואוטומציה בארגון יכול לעיין גם ב-בלוג הטכנולוגי של MisterBit, שבו עולים תרחישים דומים מעולם הפיתוח והמערכות.
תפעול ושרשרת אספקה
במחלקות תפעול, הערך מגיע מיכולת לראות צווארי בקבוק מוקדם. זמני טיפול, חוסרים, איחורי אספקה, תקלות חוזרות, עומסים לפי אזור או ספק. ברגע שיש שכבת BI תקינה, לא צריך לחכות לסוף החודש כדי להבין איפה המערכת נתקעת.
בדשבורדים תפעוליים טובים, השאלה איננה רק “מה קרה”, אלא “למה זה קרה” ו”איפה נכון להתערב”. ארגון עם כמה מקורות מידע יכול לחבר בין הזמנה, מלאי, SLA שירות ונתוני לוגיסטיקה, ולראות שהבעיה כלל אינה במחסן אלא במדיניות תיעדוף או בנתון מקור לא תקין.
כספים והנהלה
הנהלה וכספים צריכים משהו אחר. פחות מסכים יפים, יותר אמינות, חתכי זמן עקביים ויכולת drill-down מהתמונה הגדולה לפרט שמסביר אותה. תחזית פיננסית טובה נשענת על היסטוריה נקייה, סיווגים אחידים ויכולת לעקוב אחרי שינויים לאורך זמן.
בשלב הזה BI מתחיל להשפיע גם על החלטות מוצר. אם צוות הנהלה רואה שחבילת SaaS מסוימת נשחקת ברווחיות בגלל עלות שירות, הוא יכול לשנות תמחור, חבילת יכולות או אסטרטגיית onboarding. זו כבר לא אנליטיקה לשם אנליטיקה. זו שכבת שליטה עסקית.
- לשיווק: מקור אמת אחד למסע הלקוח.
- לתפעול: זיהוי מוקדם של חריגות ותקלות תהליך.
- לכספים: תחזית מהימנה ולא רק סיכום רטרואקטיבי.
- למוצר: חיבור בין שימושיות, הכנסה ושימור.
הפער בין בינה עסקית לבינה מלאכותית בארגון
אחת הטעויות הנפוצות היום היא לחשוב שאם הארגון “משתמש ב-AI”, אז הוא כבר מתקדם גם ב-BI. בפועל, אלה שני דברים שונים לחלוטין.
שימוש ב-AI אינו תחליף לתשתית BI
ארגון יכול להשתמש בכלי AI לכתיבה, חיפוש, סיכום ישיבות, שירות לקוחות או אוטומציות נקודתיות, ועדיין לא לדעת לענות בצורה אמינה על שאלות בסיסיות כמו רווחיות לפי לקוח, נטישה לפי cohort או ביצועי מוצר לפי מגזר.
לפי ניתוח של המכון הישראלי לדמוקרטיה על בסיס סקר הלמ״ס, 28% מהעסקים בישראל השתמשו ב-AI בחצי השנה שקדמה לסקר, לעומת 13% בממוצע באיחוד האירופי ב-2024, כלומר יותר מכפול מהממוצע האירופי. באותו ניתוח צוין גם כי בארגונים גדולים השיעור הגיע לכ-52% במרץ 2026 לעומת 34% ביוני 2025, ובעסקים קטנים עלה ל-37% לעומת 28% קודם לכן, לפי הדיווח על ממצאי IDI והשוואת ישראל לאיחוד האירופי. זה מראה קצב אימוץ גבוה, אבל לא אומר שנבנתה שכבת BI תקינה.
איפה נוצר הבלבול
AI טוב עובד על קלט. אם הקלט לא נקי, לא מקוטלג, לא מנוהל ולא עקבי, גם המודל המתקדם ביותר יפיק תוצרים שגויים או מטעים. Agentic AI, חיזוי מגמות, המלצות מבוססות מודל ואוטומציה חכמה דורשים שכבת נתונים מהימנה לפני הכול.
בהנחיות הממשלתיות לשימוש אחראי בבינה מלאכותית בישראל מודגש שיש לבנות כללים לניהול הנתונים המשמשים מודלים ומערכות AI בתיאום עם ה-CDO, כדי להבטיח שהמידע יהיה תקף, מדויק ועדכני ולצמצם סיכוני פרטיות, הטיות ותוצרים שגויים, לפי המדריך הממשלתי לשימוש אחראי ב-AI.
אם הנתון שמזין את הדשבורד לא אמין, הוא גם לא יהיה אמין כשהוא יוזן למודל.
חוב נתונים הוא החוב החדש
בישראל רואים גם את הפער שבין שימוש נקודתי ליכולת ארגונית עמוקה יותר. לפי פרסום הלמ״ס, רק 28% מהעסקים עם 10 עובדים ומעלה דיווחו על שימוש ב-AI כחלק אינטגרלי מהפעילות העסקית, ו-17% השתמשו בפתרונות בתשלום. עוד עולה שעסקים קטנים דיווחו על שימוש נמוך יותר, 18%, לעומת 32% בעסקים בינוניים, לפי הודעת הלמ״ס בנושא שימוש בבינה מלאכותית בעסקים.
המשמעות למקבלי החלטות פשוטה. אפשר לרוץ מהר עם כלי AI, אבל אם מדלגים על Data Warehouse, governance וקטלוג נתונים, החוב יצטבר. אחר כך תשלמו עליו באמינות, בעיכובים ובהמון “פיילוטים” שלא עוברים לייצור.
מפת דרכים לבחירה והטמעה של פתרון BI
הטמעת BI טובה לא מתחילה בבחירת כלי. היא מתחילה בבחירת בעיה עסקית אחת ששווה לפתור, ובהבנה מי אחראי על כל שכבה. בלי זה, הפרויקט יתפזר בין IT, פיתוח, כספים ומנהלי מוצר בלי בעלים אמיתי.
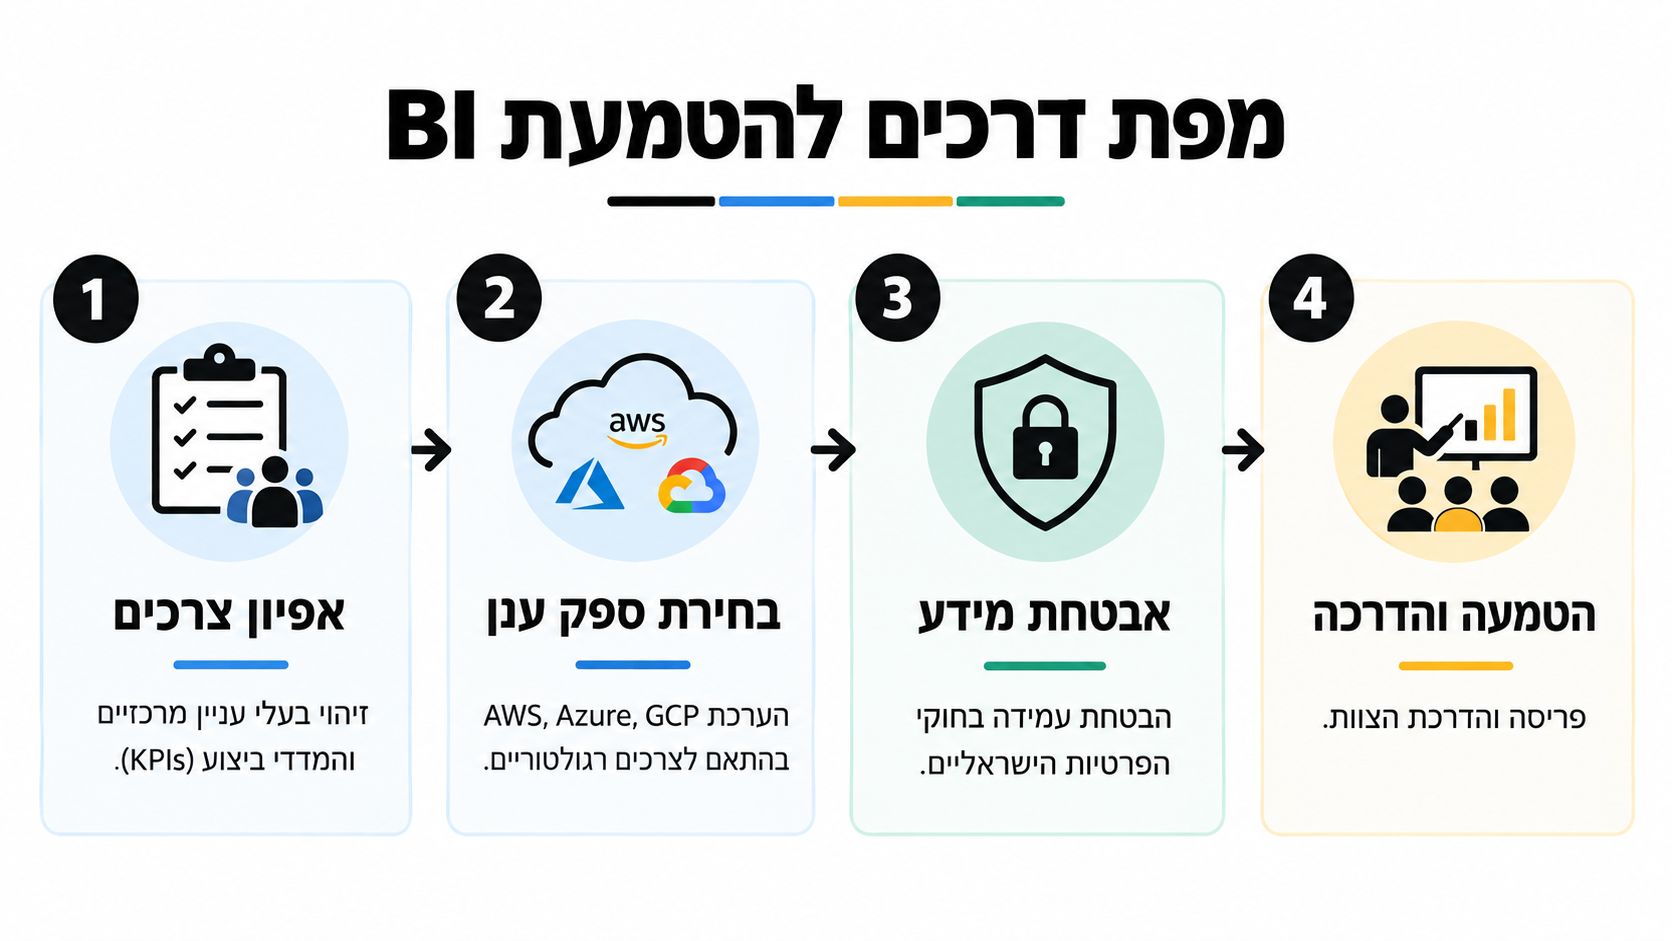
שלב ראשון מגדירים שאלה עסקית ובעלי אחריות
אל תתחילו מ-20 דשבורדים. התחילו משאלה אחת. למשל, למה רווחיות לקוחות נשחקת, איפה יש צוואר בקבוק תפעולי, או למה יש פער בין שימוש במוצר להכנסה בפועל. אחרי שבוחרים שאלה, ממנים owner עסקי ו-owner טכנולוגי.
בארגונים מתקדמים זה יכול להיות CDO, CTO, VP R&D או מנהל נתונים פנימי. בארגונים קטנים יותר, לפעמים נכון להשתמש במודל של CTO as a Service או בליווי חיצוני כדי לייצר את ההחלטות הראשונות נכון, במיוחד אם אין עדיין צוות Data בשל.
שלב שני בוחרים ארכיטקטורה וספק ענן
AWS, Azure ו-GCP כולם יכולים להתאים. ההחלטה צריכה להתבסס על אקו-סיסטם קיים, דרישות אינטגרציה, זמינות כוח אדם, כלי אבטחה, ודרישות רגולטוריות. אם המוצר כבר בנוי ב-Node.js ו-Python ורץ בענן מסוים, לרוב עדיף לא לפתוח חזית מיותרת רק בגלל שכלי BI מסוים נוח יותר בענן אחר.
בישראל אין רגולציה כללית אחת שמסדירה שימוש בענן לכל הארגונים, וארגונים צריכים לבנות משטר ממשל נתונים וענן לפי רגולציה ענפית וסיווג המידע. בנוסף, קיימות ארבע רמות של חובת אבטחת מידע לפי תקנות אבטחת המידע, כפי שמוסבר ב-סקירה המשפטית על פרטיות, סייבר וענן בישראל. המשמעות היא שארכיטקטורת BI אינה רק החלטה טכנית. היא החלטת ציות, סיכון ותפעול.
שלב שלישי מטפלים באבטחת מידע לפני העלייה לאוויר
במידע רגיש, ובוודאי בפרויקטים עם הקשר ממשלתי או שרשרת אספקה, לא מספיק “לאבטח בהמשך”. במסמך ההנחיות הממשלתי לשרשרת אספקה בישראל נקבע כי כל מידע בתנועה חייב להיות מוצפן ב-TLS או IPsec עם מפתח מינימלי של 128 ביט, וכן נדרש מספק המערכת להציג דוח בדיקת קוד ודוח חדירה מחברה חיצונית כאשר מבוצעת פיתוח תוכנה, לפי הנחיות אבטחה לשרשרת אספקה.
זו נקודה קריטית גם לפיתוח תוכנה בהתאמה אישית. אם אתם בונים דשבורדים מותאמים, מערכת SaaS אנליטית, אפליקציית Web פנימית או הרחבת מוצר קיים, אבטחה צריכה להיות חלק מהארכיטקטורה, לא שכבת קוסמטיקה.
שלב רביעי מתחילים ב-MVP ומרחיבים בהדרגה
הדרך היעילה ביותר היא פיילוט מצומצם. מחלקה אחת, כמה מקורות נתונים, מספר קטן של KPIs, ומדידה של שימוש אמיתי. אם זה עובד, מרחיבים. אם זה לא עובד, מתקנים מוקדם.
צ'קליסט קצר ליישום:
- בחרו תרחיש שימוש אחד: לא “מערכת BI לארגון”, אלא בעיה עסקית ספציפית.
- מפו מקורות נתונים אמיתיים: כולל איכות, owner, זמינות ותדירות עדכון.
- החליטו על שכבת Serving: כלי מדף או פיתוח מותאם.
- תכננו עלות ענן מראש: שאילתות, אחסון, ריענון, סביבות dev ו-production.
- קבעו מנגנון תחזוקה: מי בודק כשמדד נשבר, מי מאשר שינוי הגדרה, ומי מטפל בהרשאות.
למי שמחפש שותף ליישום, MisterBit היא אחת האפשרויות עבור ארגונים שצריכים ייעוץ ארכיטקטוני, פיתוח תוכנה מותאם, חיזוק צוותי פיתוח ו-Data, או ליווי בהקמת תשתיות SaaS ו-AI סביב מערכות ארגוניות.
סיכום והמלצות פרקטיות למקבלי החלטות
הטעות הגדולה ביותר בפרויקטי BI היא להתאהב במסך לפני שבונים את המערכת שמזינה אותו. דשבורדים לא פותרים כאוס נתונים. הם רק מציגים אותו מהר יותר.
שלושה כללי אצבע לפני שמתחילים
- אם אין הגדרה אחידה ל-KPI, אל תבנו דשבורד. קודם מיישרים שפה עסקית, אחר כך מפתחים.
- אם הנתונים יושבים רק במערכות תפעוליות, בנו שכבת Data Warehouse. בלי הפרדה כזו, הביצועים והאמינות ייפגעו.
- אם הארגון רץ ל-AI לפני governance, עצרו רגע. שכבת BI יציבה היא בסיס טוב יותר לאוטומציות, אנליטיקה מתקדמת ו-Agentic AI.
איך נראית בשלות אמיתית
ארגון בשל לא אומר ארגון גדול. הוא אומר ארגון שיודע לענות על שלוש שאלות:
- מי הבעלים של הנתונים ושל כל KPI.
- מאילו מקורות מגיע כל מדד ואיך הוא מחושב.
- מי רשאי לראות מה, ובאיזו רמת פירוט.
הנתון החשוב ביותר בפרויקט BI הוא לא מה שמופיע בגרף. זה האם ההנהלה סומכת עליו.
למנכ״לים, CTOs, מנהלי מוצר ו-VP R&D, ההמלצה ברורה. התחילו בבעיה עסקית אחת, בנו תשתית לפני ויזואליזציה, והקפידו על governance ואבטחה מהיום הראשון. אם צריך, התחילו קטן עם MVP, אבל אל תבנו קטן בצורה שתתקעו איתה לשנים.
אם אתם בוחנים הקמה של תשתית נתונים, פיתוח מערכת SaaS אנליטית, שילוב AI על בסיס נתונים אמין, או חיזוק צוותי הפיתוח וה-Data שלכם, אפשר להיעזר בצוות של מיסטרביט. מיסטרביט מלווה ארגונים באפיון, ארכיטקטורה, פיתוח תוכנה מותאם ויישום פתרונות ענן ו-AI, בצורה שמחברת בין צורך עסקי, מוצר ותשתית שעובדת לאורך זמן.