Platform Engineering: מדריך מקצועי לארכיטקטורה ויישום
אם אתם מרגישים שצוות הפיתוח שלכם עובד קשה אבל מתקדם לאט, הבעיה לא תמיד נמצאת במפתחים. הרבה פעמים היא נמצאת בין הקוד לפרודקשן. מפתח רוצה להרים שירות חדש ב-Node.js או Python, ואז מתחיל מסע צדדי: לפתוח הרשאות ב-AWS או Azure, להגדיר secrets, לחבר CI/CD, להקים ניטור, להבין איפה נשמרים לוגים, ולגלות בדיעבד שאין סביבת staging שדומה באמת ל-production.
בשלב הזה הארגון לא סובל ממחסור בטאלנט. הוא סובל ממחסור במערכת. כל צוות פותר שוב את אותן בעיות תשתית, כל שירות נפרס קצת אחרת, וכל תקלה חושפת שאין שפה תפעולית אחידה. זה נכון ב-MVP קטן, במערכת SaaS צומחת, וגם בארגון Enterprise שמריץ עשרות שירותים, אפליקציות Web ומובייל, ותהליכי AI Transformation.
כאן נכנס Platform Engineering. לא כבאזז וורד, אלא כדרך להפוך תשתית, אוטומציה, הרשאות ו-governance למוצר פנימי שעובד עבור צוותי הפיתוח, במקום נגדם. אם עושים את זה נכון, מפתחים מבלים יותר זמן בבניית מוצר ופחות זמן בלרדוף אחרי גישה, pipeline או שרת. אם עושים את זה לא נכון, מקבלים שכבת מורכבות יקרה שאף אחד לא אוהב.
תוכן עניינים
- הבעיה העסקית שפלטפורמה פנימית פותרת
- מה זה Platform Engineering ואיך הוא שונה מ-DevOps
- המרכיבים הטכניים של פלטפורמה
- ארכיטקטורות נפוצות של פלטפורמה פנימית
- מי עושה מה, תפקידי פלטפורמה, SRE ו-DevOps
- Minimum Viable Platform לסטארטאפ ולסקיילאפ
- Best Practices והקשר הישראלי
- מתי להיעזר בשירותי Team Extension ולסיכום
הבעיה העסקית שפלטפורמה פנימית פותרת
התרחיש מוכר. צוות מוצר צריך לשחרר פיצ'ר חדש לאפליקציית SaaS. הקוד כמעט מוכן, אבל deployment מתעכב כי צריך לפתוח role חדש, להוסיף bucket policy, לחבר log shipping, ולוודא שהסביבה לא שוברת שירות אחר. בינתיים מנהל המוצר שואל למה זה "רק עוד שינוי קטן", וה-CTO כבר מבין שהבעיה לא נקודתית.
בארגונים כאלה, צוותי הפיתוח לא באמת איטיים. הם פשוט משלמים שוב ושוב את מס התשתית. כל בקשה עוברת דרך אנשים אחרים, כל החלטה דורשת תיאום, וכל פרויקט חדש מתחיל מאפס במקום מתבנית. זו בדיוק הנקודה שבה פלטפורמה פנימית הופכת מהשקעה טכנית להחלטה עסקית.
בפועל, הפלטפורמה מחליפה מודל ריאקטיבי של "תפתחו טיקט ונחזור אליכם" במודל מוצרי. צוות הפיתוח מקבל תבניות, pipelines, הרשאות, ניטור וסביבות עבודה סטנדרטיות. במקום שמומחה תשתיות יקים לכל צוות פתרון ידני, הארגון בונה יכולת חוזרת.
צוות שלא יכול להרים שירות חדש בלי לערב שלושה אנשים שונים לא סובל מבעיית פרודוקטיביות. הוא סובל מארכיטקטורה ארגונית לא נכונה.
המעבר הזה כבר קורה בישראל. בסקר ישראלי של Calcalist Tech, 63% מהארגונים דיווחו שכבר הקימו צוות Platform ייעודי, ו-75% דיווחו על פונקציית FinOps, לפי הניתוח של Deloitte על השפעת הענן בישראל. מבחינתי, זה אומר שהשוק המקומי כבר לא מתייחס לפלטפורמה כאל nice to have. הוא מתחיל להבין שזה מנגנון תפעולי שמחבר בין מהירות פיתוח, שליטה בעלויות ויכולת צמיחה.
איך זה נראה ביום יום
- צוות Web צריך להרים microservice ב-React ו-Node.js. בלי פלטפורמה, הוא בונה pipeline, לוגים והרשאות לבד.
- צוות מובייל צריך backend חדש. בלי תבניות מוסכמות, הוא משכפל repo ישן ומקווה לטוב.
- צוות AI רוצה לחבר מודל חיצוני. בלי guardrails, מידע רגיש עלול לזלוג לשירות שלא אושר.
בכל אחד מהמקרים, הבעיה מתחילה טכנית ומסתיימת עסקית. עיכובים, חוסר עקביות, עלויות ענן מיותרות, וסיכון אבטחה שצץ בדיוק כשלא צריך אותו.
מה זה Platform Engineering ואיך הוא שונה מ-DevOps
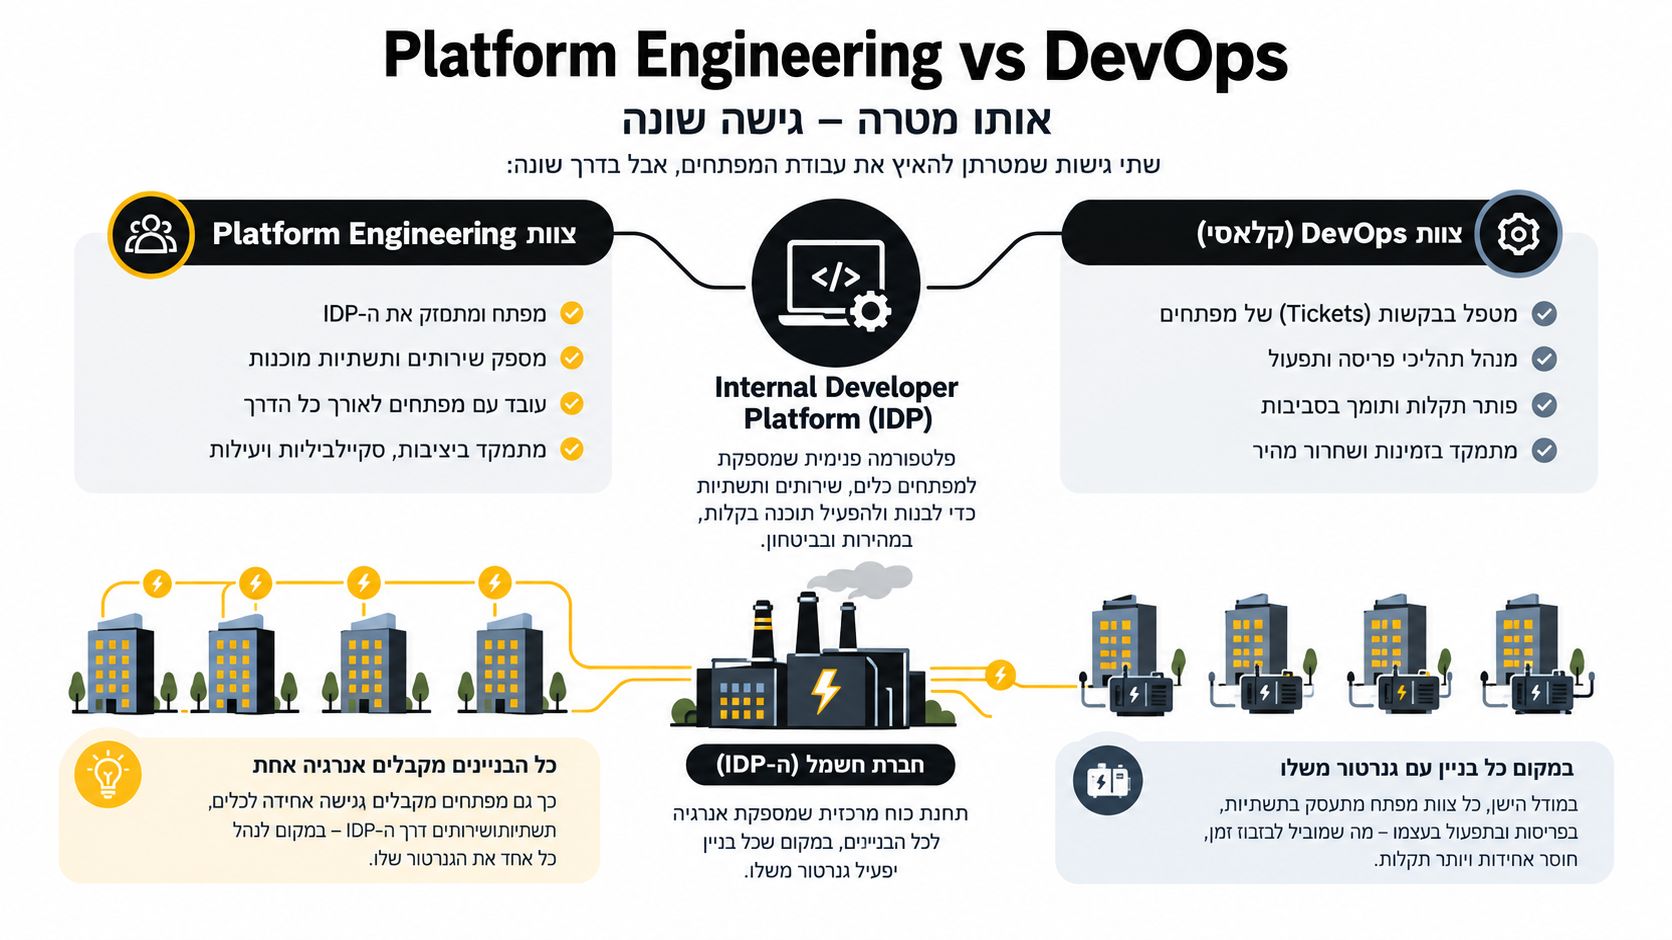
Platform Engineering הוא תחום שבונה פלטפורמת מפתחים פנימית. לא עוד צוות שמטפל בטיקטים, אלא צוות שמספק שירות עצמי. המפתח לא מבקש "תפתחו לי DB" או "תגדירו לי deployment". הוא משתמש בנתיב עבודה מוסדר. לפעמים דרך פורטל, לפעמים דרך repository template, לפעמים דרך CLI או pipeline מוכן.
פלטפורמה פנימית היא לא רק אוטומציה
הרבה ארגונים חושבים שהם "עושים פלטפורמה" כי יש להם Terraform, GitHub Actions ו-Kubernetes. זה לא מספיק. אוסף כלים הוא לא מוצר. פלטפורמה אמיתית נמדדת בשאלה פשוטה: האם צוות פיתוח יכול להתקדם מהר יותר עם פחות תלות בצוותי תשתיות, בלי לשבור governance.
האנלוגיה הטובה ביותר היא חברת חשמל. אתם לא רוצים שכל בניין יפעיל גנרטור משלו, יתחזק אותו, יפתור תקלות לבד וינהל מדיניות בטיחות מקומית. אתם רוצים רשת מרכזית עם חיבור סטנדרטי, אמינות וכללי שימוש ברורים. כך בדיוק צריך להיראות internal developer platform.
ההבדל המעשי בין DevOps, SRE ו-Platform Engineering
DevOps במקור הוא לא תפקיד אלא גישה. בפועל, בהרבה חברות בישראל "צוות DevOps" הפך לצוות שמנהל ענן, CI/CD, הרשאות, secrets ופריסות. הוא עסוק בבקשות שוטפות ולכן נשאב לעבודה תגובתית.
SRE ממוקד באמינות production. הוא חושב על SLOs, on-call, response לאירועים, capacity, postmortems, ועמידות מערכתית. SRE לא אמור להיות הבעלים של חוויית המפתח.
Platform Engineering מתמקד ב-Developer Experience ובסטנדרטיזציה. הוא בונה golden paths, תבניות, guardrails ו-self-service. המטרה אינה להחליף את צוותי המוצר, אלא להקטין להם עומס קוגניטיבי.
מתי צריך את זה
- אם כל deployment נראה אחרת, אתם צריכים פלטפורמה.
- אם כל צוות בוחר stack תפעולי אחר, אתם צריכים פלטפורמה.
- אם מפתחים מחכים להרשאות, סביבות או ניטור, אתם צריכים פלטפורמה.
- אם יש לכם צוות אחד קטן ומוצר אחד פשוט, כנראה שאתם עדיין צריכים סדר, לא פלטפורמה מלאה.
כלל אצבע מעשי: כשאותה בעיית תשתית נפתרת שלוש פעמים בשלושה צוותים שונים, צריך לעצור ולבנות יכולת משותפת.
המרכיבים הטכניים של פלטפורמה
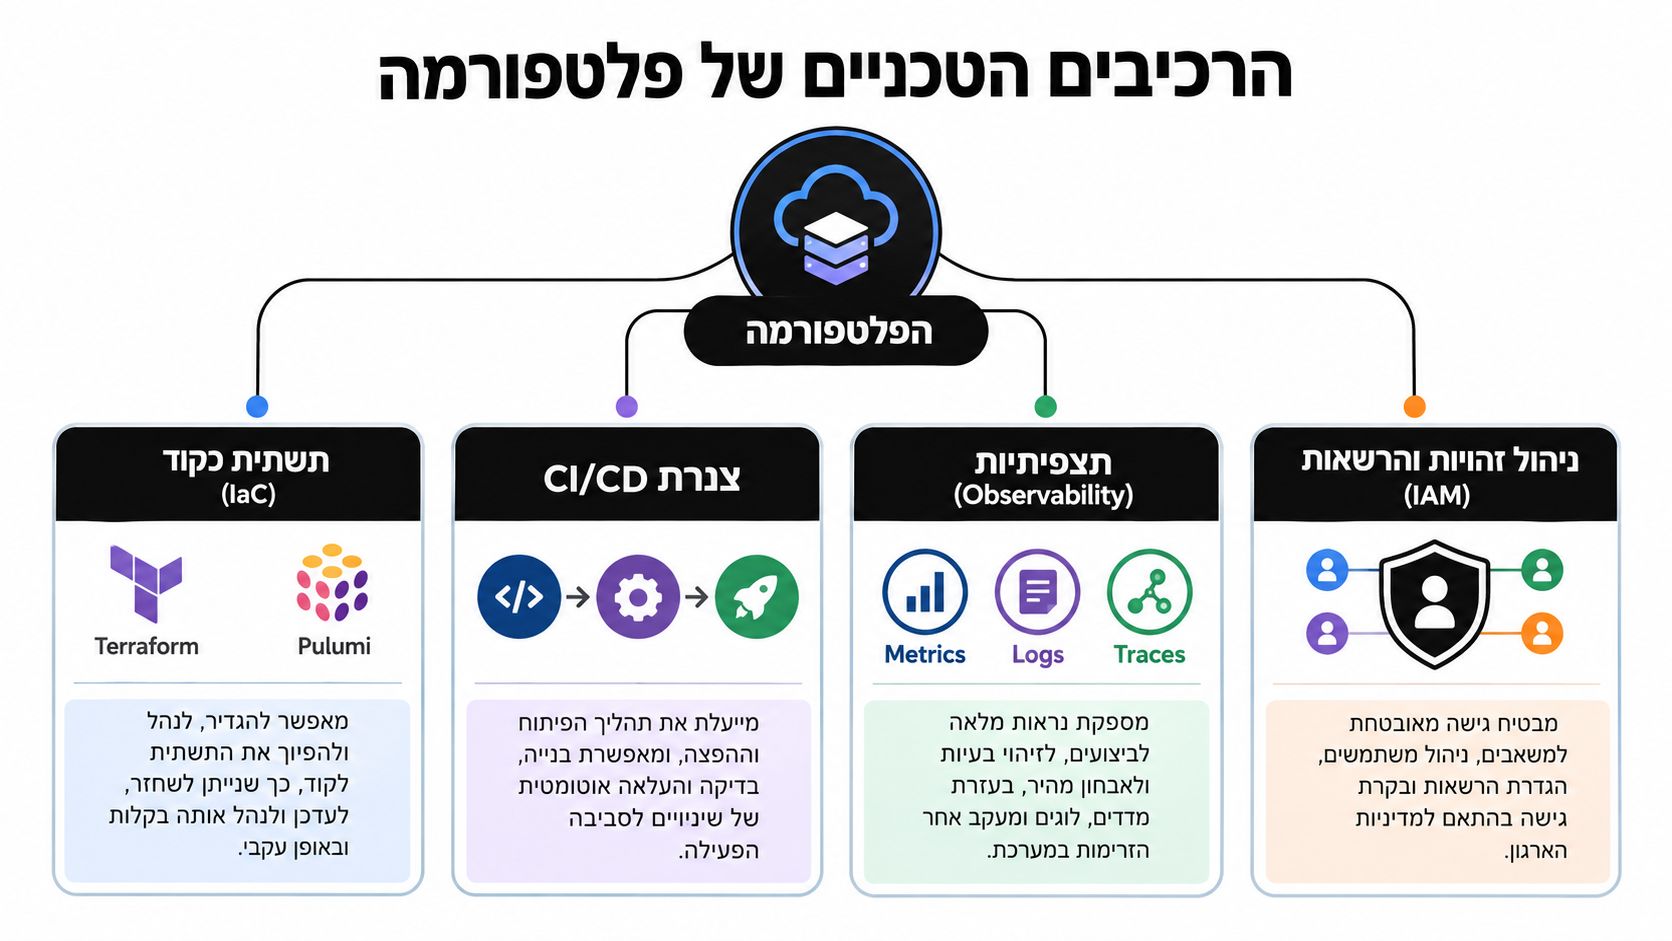
פלטפורמה טובה לא מתחילה מ-Kubernetes. היא מתחילה מהבסיס. מדיניות הענן הממשלתית בישראל מחברת בין Infrastructure as Code, ניהול תצורה, אינטגרציה רציפה, פריסה אוטומטית וצוותי DevOps. אלה מרכיבים המהווים את הבסיס לפלטפורמות מפתחים פנימיות, כפי שמתואר במודל ההפעלה הממשלתי בענן.
Infrastructure as Code
אם תשתית נבנית ידנית, היא תישבר ידנית. Terraform הוא ברירת המחדל בהרבה ארגונים. Pulumi מתאים לצוותים שמעדיפים לעבוד בשפה תכנותית מלאה. בשני המקרים, המטרה זהה: לייצר תשתית ניתנת לשחזור, לביקורת ול-review.
בסטארטאפ שבונה MVP, מספיק לעיתים להתחיל עם מודול Terraform פשוט שמרים VPC, database, IAM בסיסי ו-storage. לא צריך מערכת מודולרית ענקית. כן צריך להפסיק לפתוח משאבים דרך קונסול.
CI/CD ותבניות פריסה
GitHub Actions, GitLab CI, Azure DevOps, CircleCI. הכלים פחות חשובים מהעיקרון. כל שירות חדש צריך להיוולד עם pipeline סטנדרטי: בדיקות, build, סריקות, deployment ו-rollback בסיסי.
חברה שמפתחת אפליקציות Web, backend ב-Node.js או Python, ושירותי SaaS לא צריכה עשרה סוגי pipelines. היא צריכה שניים או שלושה patterns טובים. אחד לשירות backend, אחד ל-frontend ב-React או Vue, ואחד אולי ל-worker או job.
Observability בלי להגזים
Observability לא אומר שביום הראשון אתם צריכים OpenTelemetry, tracing מלא, custom dashboards ו-alerting אולימפי. זה אומר שלכל שירות יש לוגים מרוכזים, מדדים בסיסיים, ודרך עקבית להבין למה משהו נפל.
- לוגים עוזרים להבין מה קרה.
- Metrics עוזרים להבין אם יש בעיה מתמשכת.
- Traces חשובים כשיש ארכיטקטורת microservices או זרימות מורכבות.
- Dashboards חשובים רק אם מישהו באמת משתמש בהם.
אם אין לכם בעלות ברורה על alerts, אתם לא מנהלים observability. אתם רק מייצרים רעש.
זהויות והרשאות
זה החלק שהכי קל להזניח והכי יקר לשלם עליו אחר כך. Role-based access, סביבות מופרדות, secrets management, והרשאות מינימליות הם לא "שיפור עתידי". הם חלק מליבת הפלטפורמה.
במערכות SaaS, במוצרי AI, ובאוטומציות עסקיות, הבעיה הזאת מחמירה. שירות אחד שולח מידע לא נכון, role אחד רחב מדי, ופתאום אירוע אבטחה הופך לאירוע הנהלה.
מה לא צריך מוקדם מדי
- Kubernetes אם יש לכם שני שירותים ובלי צורך תפעולי אמיתי.
- Service catalog מלא אם כולם עדיין מכירים את כל המערכות בעל פה.
- Policy engine מורכב כשעוד אין מדיניות אחת ברורה לאכוף.
Platform Engineering טוב מוריד מורכבות. אם הכלי מוסיף יותר overhead מהערך שהוא מייצר, הוא כנראה הגיע מוקדם מדי.
ארכיטקטורות נפוצות של פלטפורמה פנימית
אין ארכיטקטורה אחת נכונה. יש ארכיטקטורה שמתאימה לשלב, לגודל הארגון ולרמת המשמעת ההנדסית שלו. ראיתי חברות בונות פורטל יפהפה לפני שיש להן בכלל סטנדרט לפריסה, וראיתי אחרות נתקעות עם shared scripts לנצח כי פחדו "למסד". שתי הטעויות עולות ביוקר.
שלוש גישות שחוזרות שוב ושוב
הגישה הראשונה היא Internal Developer Platform מבוסס Backstage או פורטל פנימי דומה. זו בחירה טובה כשיש הרבה צוותים, הרבה שירותים, וצורך אמיתי בקטלוג, תיעוד, תבניות onboarding ו-self-service במקום אחד.
הגישה השנייה היא Shared Services Layer. אין פורטל נוצץ. יש תבניות repo, מודולי Terraform, workflow קבועים, סטנדרט הרשאות, וספריית רכיבים משותפת. זו לרוב הבחירה הנכונה לארגונים בינוניים ולסקיילאפים פרקטיים.
הגישה השלישית היא Platform מבוסס Kubernetes ו-Operators. כאן הפלטפורמה בנויה סביב cluster as a product. זה מתאים לארגונים עם עומק תפעולי גבוה, הרבה שירותים, והרבה צורך באחידות runtime.
השוואת ארכיטקטורות פלטפורמה
| ארכיטקטורה | מתאים ל | יתרון מרכזי | חיסרון מרכזי |
|---|---|---|---|
| Internal Developer Platform | ארגון עם צוותים רבים ומגוון שירותים | חוויית מפתח מסודרת וקטלוג אחיד | דורש השקעה מוצרית ותפעולית עקבית |
| Shared Services Layer | סטארטאפ בוגר או סקיילאפ | מהיר יחסית ליישום, פחות שכבות | קל להידרדר לאוסף סקריפטים בלי בעלות ברורה |
| Kubernetes-based Platform | ארגון עם מורכבות תפעולית גבוהה | אחידות חזקה סביב deployment ו-runtime | עלול להכניס מורכבות מוקדם מדי |
איך לבחור בלי ליפול לטרנד
תשאלו ארבע שאלות:
- כמה צוותים באמת משתמשים ביכולות משותפות
- עד כמה ה-stacks שלכם מגוונים
- כמה autonomy אתם רוצים לתת לצוותי מוצר
- האם יש לכם אנשים שיכולים לתחזק את מה שאתם בונים
אם אתם חברת MVP עם מוצר אחד, אל תקימו Backstage רק כי ראיתם אותו בכנס. אם אתם Enterprise עם עשרות צוותים, shared scripts כבר לא יספיקו. ואם אתם בונים הרבה שירותי AI, data pipelines ו-workloads שונים, תבחרו ארכיטקטורה שמכבדת את המורכבות במקום להסתיר אותה מתחת לשטיח.
מי עושה מה, תפקידי פלטפורמה, SRE ו-DevOps
הבלבול בין התפקידים האלה יוצר חיכוכים מיותרים. מנהלים מגייסים "DevOps" ומצפים למוצר פנימי. צוות SRE נגרר לתחזק pipelines. וצוות platform נשפט על uptime של מערכת שהוא בכלל לא הבעלים שלה. זה מתכון לכאוס ארגוני.
חלוקת אחריות בריאה
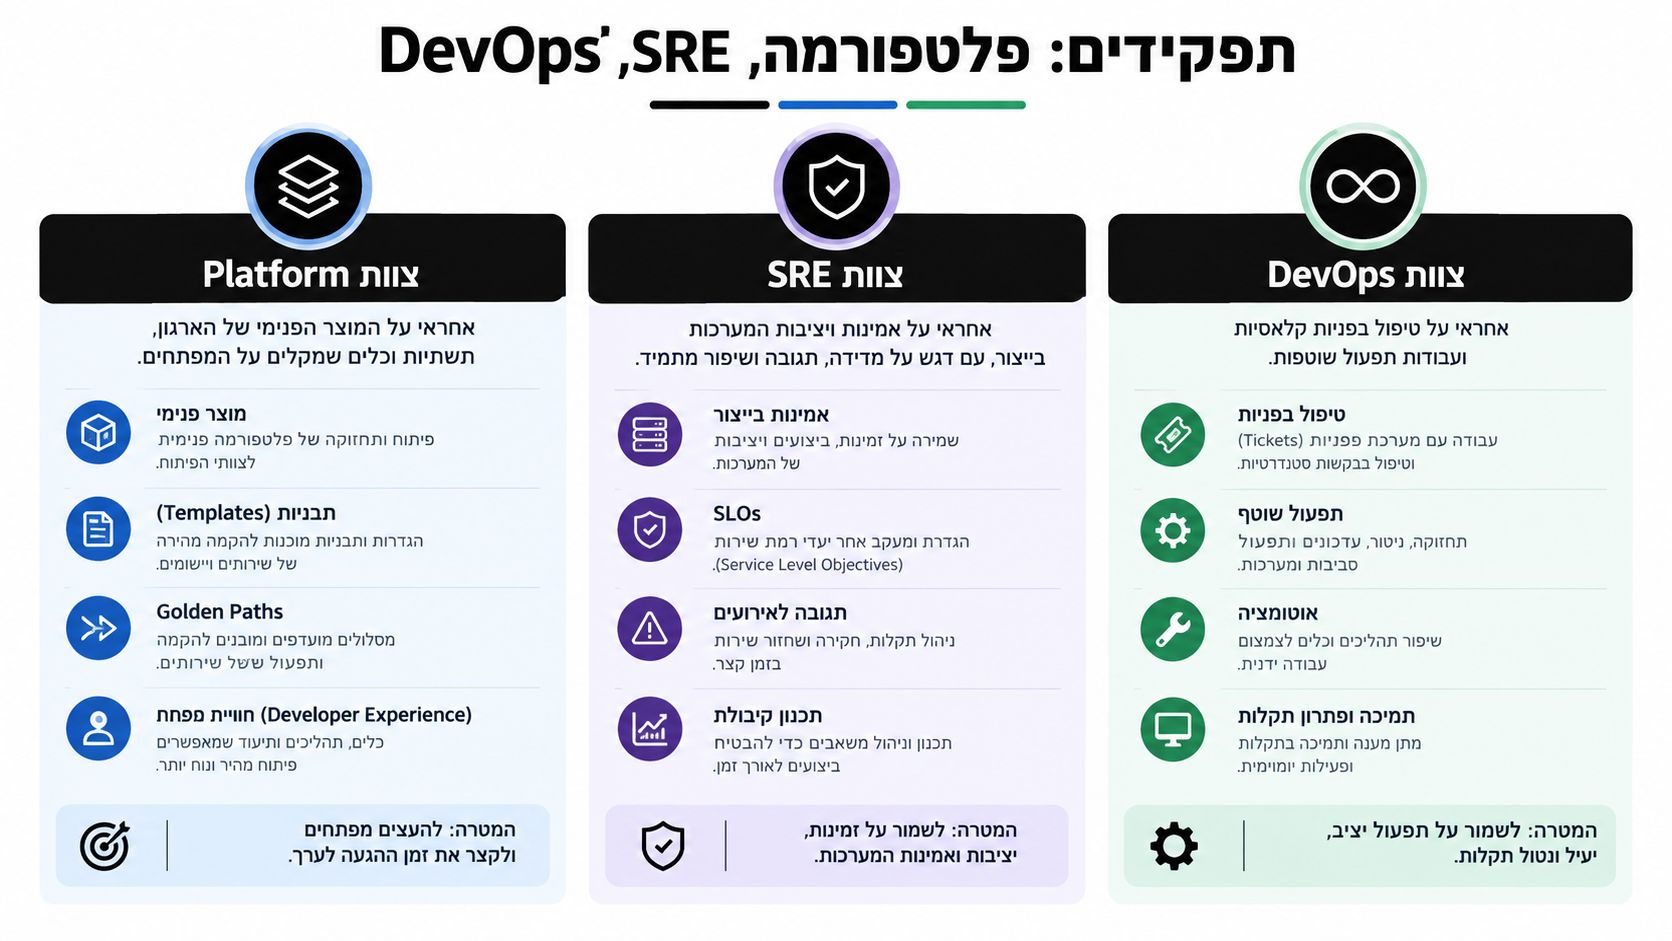
צוות Platform אחראי על המוצר הפנימי. זה כולל golden paths, תבניות repo, תבניות deployment, self-service לסביבות, זהויות, guardrails, ו-developer experience.
צוות SRE אחראי על אמינות production. הוא מטפל ב-SLOs, incident response, capacity planning, שיפור עמידות, וניתוח תקלות אחרי אירוע.
DevOps הוא לרוב או תפקיד מעשי בתוך צוותי המוצר, או פונקציה משותפת שמחברת בין פיתוח לתפעול. כשמשאירים אותו כמטריה עמומה, כולם דורכים לכולם על הרגליים.
תרחיש פשוט שמחדד את ההבדל
פיצ'ר חדש עולה בלילה לפרודקשן וקורס תחת עומס. מי עושה מה?
- SRE נכנס לאירוע, מייצב את המערכת, מפעיל playbook, ומנתח השפעה.
- צוות המוצר מתקן את הבאג בקוד או בהתנהגות העסקית.
- צוות Platform בודק למה היה אפשר בכלל לפרוס שירות בלי health checks, limits או observability ראויים, ומעדכן את ה-template כדי למנוע הישנות.
הבחנה חשובה: SRE מטפל בכשל הנוכחי. Platform Engineering אמור למנוע את הכשל הבא דרך מוצר פנימי טוב יותר.
איפה נוצרת רוב הבעיה
הצרה מתחילה כשאין owner ברור על הסטנדרט. למשל, צוות אחד עובד עם GitHub Actions, אחר עם Jenkins, שלישי מעלה ידנית קונטיינרים ל-ECR, ורביעי בכלל על שירות מנוהל. ברגע כזה, אין שפה ארגונית. יש אוסף החלטות מקומיות.
במילים פשוטות, צוות Platform אחראי על הכביש. SRE אחראי שהתנועה לא תיעצר. צוותי המוצר אחראים לנהוג.
Minimum Viable Platform לסטארטאפ ולסקיילאפ
סטארטאפ צעיר ששומע "בנו פלטפורמה כמו באנטרפרייז" בדרך כלל שורף זמן על שכבת תשתית שלא משרתת את העסק. לפני Product-Market Fit, הצוות צריך מינימום מסודר, כזה שמאפשר לזוז מהר בלי להפוך כל שינוי לפרויקט.
בישראל זה בולט במיוחד. ההייטק המקומי אחראי לכ-17% מהתוצר, אך התוצר כמעט שלא השתנה במשך שנתיים, לפי סקירת ההייטק הממשלתית. כשעובדים בסביבה כזו, יעילות הונית, מהירות אספקה ושליטה בעלויות קובעות יותר מעוד שכבת טכנולוגיה מרשימה.
מה חייב להיות ב-Minimum Viable Platform
אין צורך בצוות Platform מלא בשלב הזה. צריך כמה יסודות ברורים, ולא יותר מדי קסם.
- תבנית repo אחת טובה. למשל שירות backend ב-Python או Node.js עם CI/CD, linting, test ו-deployment מובנה.
- הפרדה ברורה בין dev, staging ו-production. לא קומבינה של environment variables.
- ניהול secrets והרשאות בסיסי. בלי shared credentials בין מפתחים.
- Observability בסיסי. לוגים מרכזיים, health checks ו-alerts מינימליים.
- תגיות עלות והתראות ענן. גם ב-MVP צריך לראות מי צורך מה.
מה להשאיר כשירות מנוהל
כאן הרבה CTOs טועים. הם מנסים לבנות control plane פנימי מוקדם מדי, ואז מפזרים את הצוות על תחזוקה במקום על מוצר.
לסטארטאפ קטן עדיף לא פעם להשתמש ב-Vercel, Render, managed databases, GitHub Actions, וביכולות native של AWS, Azure או GCP. אם המוצר הוא אפליקציית Web, SaaS B2B או MVP למובייל, הזמן של הצוות שווה יותר מהשלמת עוד שכבת abstraction.
מתי כן לעבור לפלטפורמה בוגרת יותר
יש כמה סימנים שלא כדאי להתעלם מהם.
- צוותי מוצר מתחילים להתחרות על אותם משאבים
- כל onboarding למפתח חדש דורש יותר מדי ידע שבעל פה
- פריסות נעשות לא עקביות
- עלויות ענן מתחילות לברוח בלי ownership
- פרויקטי AI, data או אוטומציות עסקיות מכניסים דרישות חדשות של הרשאות ו-governance
בשלב הזה, נכון לבנות golden paths, קטלוג שירותים מצומצם, ותשתית IaC עם בעלות ברורה. זה הרגע שבו פלטפורמה מפסיקה להיות אוסף החלטות מאולתרות והופכת למערכת עבודה.
סטארטאפ לא צריך platform team מוקדם. הוא צריך משמעת ארכיטקטונית מוקדם.
בנייה פנימית מול עזרה חיצונית
לפעמים נכון שהארכיטקטורה, ה-CI/CD, ניטור, סביבות והרשאות יוקמו יחד עם שותף חיצוני שמכיר הקמה של מוצרי SaaS, מערכות ענן ופתרונות AI. למשל, שותף חיצוני כמו מיסטרביט מספק שירותי ייעוץ טכנולוגי, Team Extension והקמת ארכיטקטורות ענן, לצד חלופות כמו יועצי DevOps עצמאיים או אינטגרטורים ממוקדים. העיקר הוא לא מי בונה, אלא האם הידע נשאר בארגון והאם בונים רק את מה שבאמת צריך עכשיו.
Best Practices והקשר הישראלי
בישראל, platform engineering לא יכול להיות מנותק מרגולציה, סייבר ו-AI. זה לא רק סיפור של Developer Experience. זה גם סיפור של פרטיות, משילות וריבונות מידע. הנחיות הרשות להגנת הפרטיות מחייבות להתייחס לפרטיות לאורך כל מחזור החיים של מערכת בינה מלאכותית, מאיסוף דרך אימון ועד הטמעה והפעלה בזמן אמת, כפי שמתואר במדריך העדכני על פרטיות והגנת מידע בישראל.
מה צריך לאכוף בפלטפורמה ולא במסמך מדיניות
- Golden paths שמכוונים צוותים לפתרון מאושר. למשל template לשירות AI שלא שולח מידע אישי לספק חיצוני בלי בקרה.
- Guardrails שאי אפשר לעקוף. הצפנה כברירת מחדל, audit logs, הרשאות מינימליות, הפרדת סביבות וניהול זהויות.
- Policy-as-code. לא לסמוך על checklists ידניים כשאפשר לחסום provisioning לא תקני.
- Data catalog בסיסי. במיוחד בארגונים שמריצים Agentic AI, data products או אוטומציות עם מידע רגיש.
זה נכון גם לארגונים שעובדים מול מגזר ציבורי, גם לחברות SaaS שמנהלות מידע רגיש, וגם לסטארטאפים שמפתחים מוצר AI ונוגעים בנתוני לקוחות מוקדם מהצפוי.
מה למדוד בפועל
הרבה צוותי פלטפורמה מודדים את מה שקל למדוד. מספר pipelines, מספר repositories, מספר שירותים על Kubernetes. אלה מדדים חלשים.
עדיף למדוד:
- זמן הקמת סביבה חדשה
- שיעור פריסות self-service
- כמה זמן onboarding לוקח למפתח חדש
- כמות חריגות מהגדרות אבטחה
- זמן שמפתחים מבזבזים על תפעול במקום על מוצר
מי שרוצה להעמיק בתכנים כאלה יכול למצוא מאמרים משלימים בבלוג הטכנולוגי של מיסטרביט, במיוחד סביב ארכיטקטורת תוכנה, AI Transformation ופיתוח מערכות ענן.
איך לא להפוך לפלטפורמה מרכזית איטית
הטעות הגדולה ביותר היא לבנות צוות מרכזי ששולט בכל החלטה. פלטפורמה טובה מכתיבה מעט דברים ולא מנהלת כל דבר.
תכפו רק את מה שמסוכן לא לאכוף. תנו חופש בכל מה שלא מסכן אבטחה, עלויות או יציבות.
למשל, סביר לכפות הצפנה, audit logging ו-IAM תקני. אין צורך להכתיב לכל צוות אם להשתמש ב-React, Angular או Vue, או אם worker פנימי צריך לרוץ כך או אחרת, כל עוד הוא עומד ב-baseline.
מתי להיעזר בשירותי Team Extension ולסיכום
לא כל חברה צריכה להקים צוות Platform פנימי עכשיו. לפעמים שירות מנוהל מספיק. לפעמים צריך ארכיטקט בכיר לזמן מוגבל. ולפעמים נכון להביא Team Extension כדי לבנות את היסודות יחד עם הצוות הקיים, בלי להעמיס גיוס מוקדם.
שלושה מצבים חוזרים על עצמם.
- חברה שצריכה גישור מהיר. יש מוצר, יש לחץ, אין זמן לגייס. כאן נכון להביא חיזוק זמני.
- חברה שצריכה כיוון ארכיטקטוני. לא עוד ידיים, אלא מישהו שיודע להגדיר baseline, לבחור כלים, ולמנוע טעויות יקרות.
- ארגון שצריך הקמה והעברת ידע. לא רק delivery, אלא תהליך שבסופו הצוות הפנימי מחזיק את הפלטפורמה.
בישראל יש גם שכבה נוספת. רגולציית פרטיות, מימשל סייבר, ועבודה מול גופים שמצפים לבקרה הדוקה דוחפים ארגונים לבנות פלטפורמה מדויקת, לא מנופחת. בסטארטאפ, במיוחד מול Nimbus, עדיף להתחיל ב-Mimum Viable Platform ממושמע, כזה שמשרת את המוצר ולא את האגו של צוות התשתיות.
ההמלצה שלי פשוטה. בונים פלטפורמה כשיש כאב חוזר, כשהמורכבות כבר גוזלת זמן וכסף, וכשאפשר להגדיר מוצר פנימי עם משתמשים ברורים. אם אתם בשלב הזה, שווה לבחון Team Extension וייעוץ טכנולוגי דרך מיסטרביט במקום לגייס מהר מדי או להקים שכבה שתהפוך לעוד עומס.
מיסטרביט עוזרת לסטארטאפים, חברות מוצר וארגונים לתכנן ולהקים ארכיטקטורות ענן, CI/CD, תשתיות SaaS ופתרונות AI בצורה פרקטית, כולל Team Extension ו-CTO as a Service כשצריך הנהגה טכנולוגית בלי לנפח את הארגון מוקדם מדי. אם אתם שוקלים Platform Engineering, Minimum Viable Platform או שדרוג של סביבת הפיתוח והפריסה שלכם, אפשר להתחיל משיחה ממוקדת.