Regression Testing מהיסודות ועד אוטומציה ב-CI/CD
ביום ראשון נכנס לפרודקשן פיצ'ר חדש. צוות ה-QA בדק את הזרימה המרכזית, מנהל המוצר אישר, והגרסה נראתה יציבה. כמה ימים אחר כך לקוח מדווח שתהליך התשלום נשבר, אף שמפתחי הצוות לא שינו את מודול התשלום עצמו. חקירה קצרה מגלה ששינוי בולידציה של קופון השפיע על חישוב המע״מ במסלול אחר.
זהו באג רגרסיה. הוא נוצר כאשר שינוי חדש פוגע בפונקציונליות שכבר עבדה, ולכן הוא מסוכן במיוחד למוצרים עם גרסאות תכופות, אינטגרציות רבות או ארכיטקטורה מורכבת. עלות הטיפול בו אינה מסתכמת בשורת הקוד שצריך לתקן. היא כוללת חקירה, עצירת עבודה, חריגה מתכנית השחרור, פגיעה באמון המשתמשים ולעיתים גם תיקון חירום בפרודקשן.
תוכן עניינים
- למה באגים חוזרים ומה זה עולה לכם
- מהי בדיקת רגרסיה ואיפה היא נכנסת לתהליך
- הסוגים המרכזיים של בדיקות רגרסיה
- איך בונים ומתחזקים סט בדיקות רגרסיה יעיל
- השוואת כלי אוטומציה Selenium Playwright ו-Cypress
- שילוב בדיקות רגרסיה בתוך pipeline של CI/CD
- מה לעשות בפועל בסטארטאפ או בארגון
למה באגים חוזרים ומה זה עולה לכם
באגים חוזרים מאותה סיבה בסיסית: קוד חדש כמעט אף פעם לא חי בבידוד. שינוי ב-API עשוי להשפיע על אפליקציית מובייל, שירות רקע, מערכת SaaS או מסך React שלא הופיעו במשימת הפיתוח. תיקון ב-Node.js יכול לשנות מבנה נתונים ש-Python מעבד, וחוק עסקי קטן יכול לעבור דרך כמה שירותים ולשנות תוצאה במסלול שלא נבדק.
בתרחיש התשלום, בדיקות הפיצ'ר החדש עשויות לעבור בהצלחה. הן מאשרות שהקופון עובד, אך אינן מוכיחות שחישוב המע״מ, החזר כספי, חשבונית או סל קיים ממשיכים לעבוד. ההבדל המעשי הוא בין בדיקת השינוי עצמו לבין בדיקת ההשפעה שלו על המוצר.
הבעיה העסקית אינה רק באג
כאשר תקלה מתגלה בזמן הפיתוח, המפתח עדיין מחזיק בהקשר של השינוי. הוא מכיר את הקוד, את מטרת ה-PR ואת ההחלטות שקיבל. כאשר אותה תקלה מתגלה אצל לקוח, הצוות צריך לשחזר תנאים, לזהות את הגרסה שרצה, לאסוף לוגים ולבדוק אם המקור נמצא בקוד, בנתונים, בתשתית הענן או באינטגרציה חיצונית.
במערכות Web, מובייל ו-SaaS, תקלה כזו עלולה לעצור תהליך עסקי שלם. היא יכולה להשפיע על הרשמה, התחברות, חיוב, הרשאות או סנכרון עם מערכת אחרת. בארגון Enterprise, שירותים רבים חולקים נתונים ותהליכים, ולכן שינוי מקומי עשוי להרחיב את מעגל הבדיקה גם כשה-commit קטן.
כלל מעשי: אם אין דרך סדורה לבדוק מה השתנה ומה עלול להיות מושפע, כל release נשען במידה רבה על זיכרון הצוות ועל מזל.
מה בדיקות רגרסיה מונעות
Regression testing מחזיר לתהליך שאלה שה-QA לא יכול לענות עליה באמצעות בדיקת הפיצ'ר החדש בלבד: האם מה שעבד לפני השינוי עדיין עובד עכשיו? אין צורך להריץ כל בדיקה בכל build. צריך שכבת הגנה שמחוברת לסיכון, למסלולי המשתמש ולמבנה המערכת.
הצוות צריך למפות:
- מה קריטי למוצר: הרשמה, התחברות, תשלום או יצירת מסמך.
- מה השתנה בפועל: קבצים, שירותים, סכמות, חוזי API ותלויות.
- מה כבר נשבר בעבר: אזורים עם היסטוריית תקלות מקבלים עדיפות.
- מה המחיר של כשל: תקלה בתהליך פנימי אינה דומה לכשל בחיוב לקוח.
הגישה הזו חשובה במיוחד כשסוכני AI כותבים ומשנים קוד. בחירת הבדיקות אינה יכולה להישען רק על הדרישות המקוריות. היא צריכה להתבסס גם על השינוי בפועל, על התלויות שנפגעו ועל אזורים שבהם המערכת נכשלה בעבר. שילוב הנתונים דומה לאופן שבו מכונאי בודק גם את החלק שתוקן וגם מערכות סמוכות שעלולות להיפגע ממנו.כך מקבלים החלטת בדיקה מדויקת יותר מאשר מהסתכלות על רשימת המשימות בלבד, כפי שמתואר בדיון על בדיקות תוכנה בישראל והקשר ההיסטורי לרגרסיה.
מהי בדיקת רגרסיה ואיפה היא נכנסת לתהליך
לפי תכנית הלימודים הרשמית של ISTQB, בדיקת רגרסיה נועדה לזהות אם שינויים במערכת גרמו לפגמים באזורים שלא השתנו. היא אינה בודקת רק את הפיצ'ר החדש, אלא את השפעתו על פונקציונליות קיימת. הגדרה זו חשובה משום שהיא מונעת טעות נפוצה: לחשוב שבדיקת רגרסיה היא פשוט “עוד סבב QA”.
יש להבחין בין שני סוגי בדיקות שמופיעים יחד אחרי שינוי:
- Confirmation testing: בדיקה ממוקדת שמוודאת שתקלה מסוימת אכן תוקנה.
- Regression testing: בדיקה שמחפשת תקלות חדשות באזורים אחרים בעקבות התיקון או השינוי.
נניח שמפתח שינה את ה-validation של קוד קופון במסך checkout. בדיקת confirmation תוודא שקופון לא חוקי נדחה ושקופון תקין מתקבל. בדיקת רגרסיה תבדוק גם את חישוב המע״מ, סכום ההזמנה, משלוח, תשלום בכרטיס, החזר כספי ויצירת חשבונית. ייתכן שאף אחד מהמסלולים האלה לא השתנה בכוונה, אבל כולם תלויים בהתנהגות של מסך התשלום.
השכבה הנכונה במחזור הפיתוח
בדיקות רגרסיה אינן מחליפות unit tests או integration tests. כל שכבה עונה על שאלה אחרת:
- Unit testing: האם פונקציה או רכיב מבודד מתנהגים נכון?
- Integration testing: האם כמה רכיבים עובדים יחד?
- Regression testing: האם ההתנהגות הקיימת של המערכת נשמרה לאחר שינוי?
- UAT: האם המוצר מתאים לצורך העסקי ולקריטריוני הקבלה?
בפועל, בדיקות רגרסיה יכולות להופיע בכמה נקודות. בדיקות קצרות רצות אחרי build או pull request. בדיקות ממוקדות רצות לאחר שינוי באזור מסוים. סוויטה רחבה יותר רצה בסביבת staging לפני release. תקן ISO/IEC/IEEE 29119-1:2022 כולל regression testing ו-retesting כחלק ממסגרת בינלאומית רחבה לבדיקות תוכנה, לצד תכנון, גישות בדיקה ובדיקות ידניות ואוטומטיות.
הסוגים המרכזיים של בדיקות רגרסיה
אין סוג אחד של regression testing שמתאים לכל שינוי. הרצת כל הסוויטה אחרי כל commit יכולה לספק כיסוי רחב, אבל היא עלולה להאט את הפיתוח ולייצר צוואר בקבוק. מצד שני, בחירה צרה מדי יכולה להשאיר מחוץ לבדיקה מסלול עסקי שהושפע בעקיפין.
| סוג | מטרה | זמן ריצה | כיסוי | מתי להריץ |
|---|---|---|---|---|
| Full regression | בדיקת כל הסוויטה הקיימת | ארוך יחסית | רחב ביותר | לפני גרסה מרכזית, שינוי ארכיטקטוני או release בסיכון גבוה |
| Selective regression | בדיקת אזורים שנבחרו לפי ההשפעה של השינוי | בינוני או קצר | ממוקד | אחרי שינוי מקומי, תיקון באג או עדכון שירות |
| Smoke regression | אימות שהמערכת והמסלולים הקריטיים זמינים | קצר | בסיסי | בכל build, PR או deployment לסביבה |
| Sanity regression | בדיקה ממוקדת של פיצ'ר או מסך ששונו | קצר מאוד | צר | מיד אחרי שינוי קטן או תיקון נקודתי |
איך לבחור את הסוג הנכון
Full regression משתלם כאשר מחיר הכשל גבוה או כאשר השינוי נוגע בתשתית משותפת, מודל נתונים, הרשאות או מנגנון routing. הוא פחות מתאים כתגובה אוטומטית לכל שינוי קטן, במיוחד אם הסוויטה כוללת בדיקות UI איטיות ולא יציבות.
Selective regression דורש impact analysis טוב. אם שיניתם endpoint של הזמנות, בחירת הבדיקות צריכה לכלול את השירות עצמו, את הצרכנים שלו, את תהליכי התשלום ואת הדוחות הרלוונטיים. היא לא צריכה לכלול באופן אוטומטי כל מסך במערכת, אלא אם קיימת תלות שלא מופיעה במפת הקוד.
Smoke regression הוא שער כניסה, לא הוכחת איכות מלאה. הוא צריך לענות במהירות על שאלות כמו האם המערכת עולה, האם משתמש יכול להתחבר והאם ניתן להשלים פעולה עסקית מרכזית. אם smoke נכשל, אין טעם להמשיך להריץ סוויטה עמוקה על build שאינו שמיש.
Sanity regression מתאים כאשר אתם צריכים לבדוק שינוי צר לפני הרחבת הבדיקה. הוא יעיל בפיתוח מהיר, אך מסוכן אם הצוות משתמש בו כברירת מחדל גם לשינויים שחוצים גבולות בין שירותים.
איך בונים ומתחזקים סט בדיקות רגרסיה יעיל
סט טוב מתחיל במסלולי משתמש, לא ברשימת מסכים. מנהלי מוצר, מפתחים ואנשי QA צריכים למפות את הפעולות שמחזיקות את המוצר: הרשמה, התחברות, יצירת עסקה, שינוי הרשאה, שליחת מסמך או סנכרון עם מערכת חיצונית. רק אחר כך בוחרים אילו שכבות בדיקה מכסות כל מסלול.
הגישה המעשית היא לבנות עומק בהדרגה:
- מיפוי מסלולים קריטיים: תעדו את התוצאה העסקית, לא רק את רצף הקליקים.
- Smoke suite: ודאו שהמערכת עולה ושניתן לבצע את הפעולות הבסיסיות.
- Critical path: הוסיפו את השלבים המרכזיים שמייצרים ערך למשתמש.
- Business rules: בדקו הרשאות, חישובים, סטטוסים ותנאי קצה עסקיים.
- Edge cases: הוסיפו תרחישים חריגים רק כאשר הסיכון מצדיק את עלות התחזוקה.
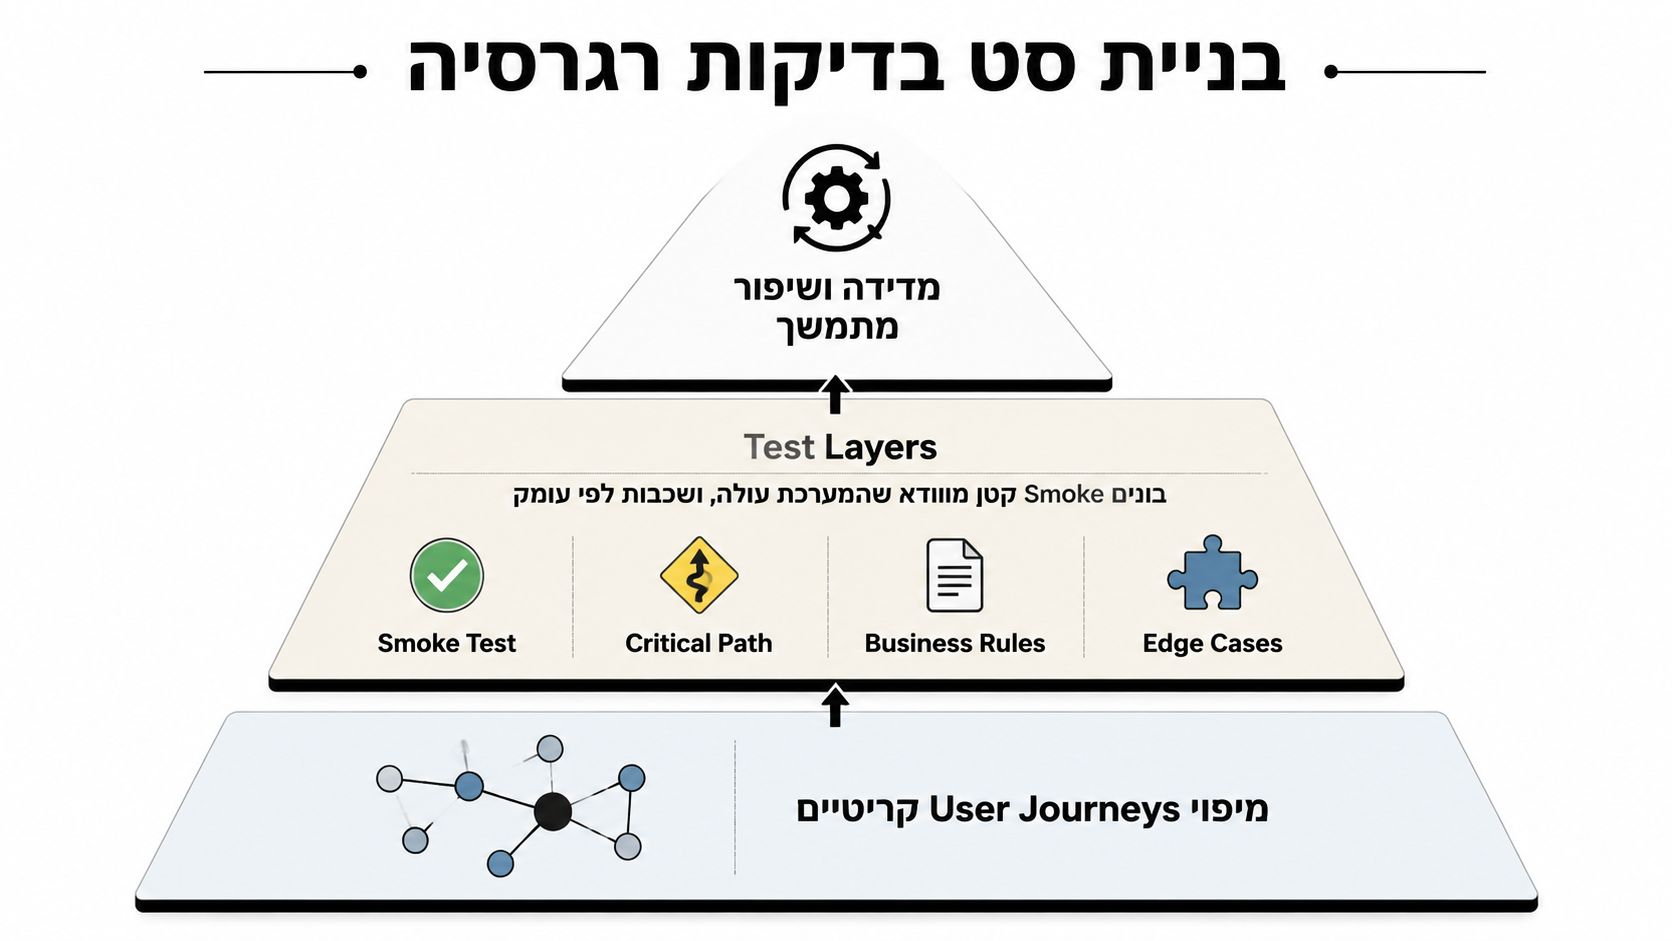
בחירת בדיקות לפי שינוי וסיכון
Test case selection לפי שינוי מתחיל בגרף ההשפעה של הקוד. בודקים אילו קבצים השתנו, אילו שירותים צורכים אותם, אילו חוזי API קשורים ומהם מסלולי המשתמש שנשענים על ההתנהגות הזו. במערכת גדולה, הבחירה יכולה להיעזר בניתוח תלויות וב-test impact analysis במקום להסתמך על שם ה-ticket בלבד.
Risk-based prioritization מוסיף את ההקשר העסקי. בדיקה של תהליך חיוב תקבל קדימות גבוהה יותר מבדיקה של מסנן חיפוש פנימי, גם אם מספר הקבצים ששונו דומה. היסטוריית תקלות, תדירות שינוי, רגישות הנתונים והשפעה על משתמשים צריכים להיכנס להחלטה.
במחקר של Red Hat על Test Case Prioritization, הדיון מתמקד בסידור מקרי בדיקה לפי סיכון כדי לחשוף כשלים קריטיים מוקדם יותר ב-CI. הכיוון המעניין הוא מעבר מסוויטה אחידה לאופטימיזציה דינמית שמתחשבת בהיסטוריית כשלים ובשינויים בקוד.
תחזוקה לפני הרחבה
לכל בדיקה צריכה להיות כוונה ברורה, נתוני בדיקה נשלטים ובעלות מוגדרת. תייגו בדיקות לפי שכבה, מוצר, סיכון וטריגר הרצה. בדיקות contract בין שירותים ובדיקות data-driven יכולות לצמצם כפילויות, במיוחד כאשר כמה תרחישים חולקים את אותו API.
בדיקה לא יציבה אינה “כיסוי”. היא רעש שמלמד את הצוות להתעלם מה-pipeline. אם בדיקה נשברת שוב ושוב בלי לספק איתות שימושי, תקנו את מקור חוסר היציבות, צמצמו את היקפה או הסירו אותה. סט קטן ואמין עדיף על אוסף גדול שאיש אינו סומך עליו.
השוואת כלי אוטומציה Selenium Playwright ו-Cypress
הכלי הנכון תלוי בארכיטקטורה, בשפות שהצוות מכיר ובסוגי הדפדפנים והמערכות שעליכם לבדוק. אין יתרון אוניברסלי ל-Selenium, Playwright או Cypress. ההחלטה הטובה היא זו שמקטינה את עלות התחזוקה בלי להסתיר מגבלות חשובות.
| קריטריון | Selenium | Playwright | Cypress |
|---|---|---|---|
| התאמה לצוות | מתאים לצוותים בשפות ובטכנולוגיות מגוונות | מתאים במיוחד לצוותי JavaScript או TypeScript | נוח לצוותי Frontend ולמפתחים שרוצים להתחיל מהר |
| יציבות הרצה | דורש טיפול מוקפד ב-locators ובתזמון | כולל auto-wait ומנגנונים מודרניים לסנכרון | מספק חוויית פיתוח טובה, אך התנהגות הבדיקה תלויה במגבלות הארכיטקטורה |
| דפדפנים וסביבות | גמיש מאוד, כולל שימוש ב-Selenium Grid | תמיכה מובנית בכמה דפדפנים והרצה מקבילית | מצטיין בסביבת הדפדפן שלו, עם מגבלות בתרחישי cross-domain ובחלק ממקרי השימוש |
| איתור תקלות | נשען במידה רבה על logs ותשתית הצוות | trace, screenshots וכלי debug מפחיתים זמן חקירה | סביבת debug אינטראקטיבית היא נקודת חוזק מרכזית |
| עלות תחזוקה | יכולה להיות גבוהה בסוויטות גדולות | נוטה להיות נוחה יותר בפרויקטים מודרניים, אם ה-selectors יציבים | כתיבה מהירה, אך יש לבחון מגבלות לפני התחייבות לסוויטה רחבה |
| מתי לבחור | Legacy, מגוון שפות, תאימות רחבה ודרישות ארגוניות | מוצר SaaS מודרני עם צוות JS או TS | צוות קטן שמעדיף feedback מהיר וחוויית פיתוח פשוטה |
Selenium
Selenium נשאר בחירה מעשית בארגונים עם מערכות Legacy, שפות תכנות שונות ודרישות תאימות רחבות. הוא משתלב היטב עם תשתיות קיימות ועם Grid, אבל הגמישות הזו מגיעה עם אחריות: הצוות צריך לנהל locators, תזמון, דרייברים ויציבות הרצה.
Playwright
Playwright מתאים במיוחד למוצרי Web מודרניים ולצוותים שכבר עובדים ב-TypeScript או JavaScript. auto-wait, תמיכה בכמה דפדפנים ויכולת הרצה מקבילית מקטינים חיכוך, אך הם לא פותרים design בעייתי של בדיקות. אם הבדיקה תלויה ב-selectors שבירים או בנתונים משותפים, גם כלי מודרני ייכשל.
Cypress
Cypress בולט בחוויית המפתח. כתיבת בדיקה, צפייה בצעדים ואיתור כשל יכולים להיות מהירים ונוחים, ולכן הוא מתאים לצוות קטן שרוצה להכניס אוטומציה בלי לבנות תשתית כבדה. לפני הבחירה, בדקו תרחישי cross-domain, חלונות חיצוניים, אינטגרציות ודפדפנים שנדרשים אצלכם. כלי שמרגיש מצוין ב-demo עלול להיות פחות מתאים לזרימה העסקית האמיתית.
שילוב בדיקות רגרסיה בתוך pipeline של CI/CD
המעבר החשוב הוא לא מאוטומציה ידנית לאוטומציה בלבד, אלא מ”בדיקה לפני release” לשער איכות שמקבל החלטה לאורך כל ה-pipeline. כל pull request צריך לקבל feedback מהיר על מסלולים קריטיים, בעוד שגרסה שמועמדת לפריסה צריכה לעבור בדיקה רחבה יותר בסביבת staging.
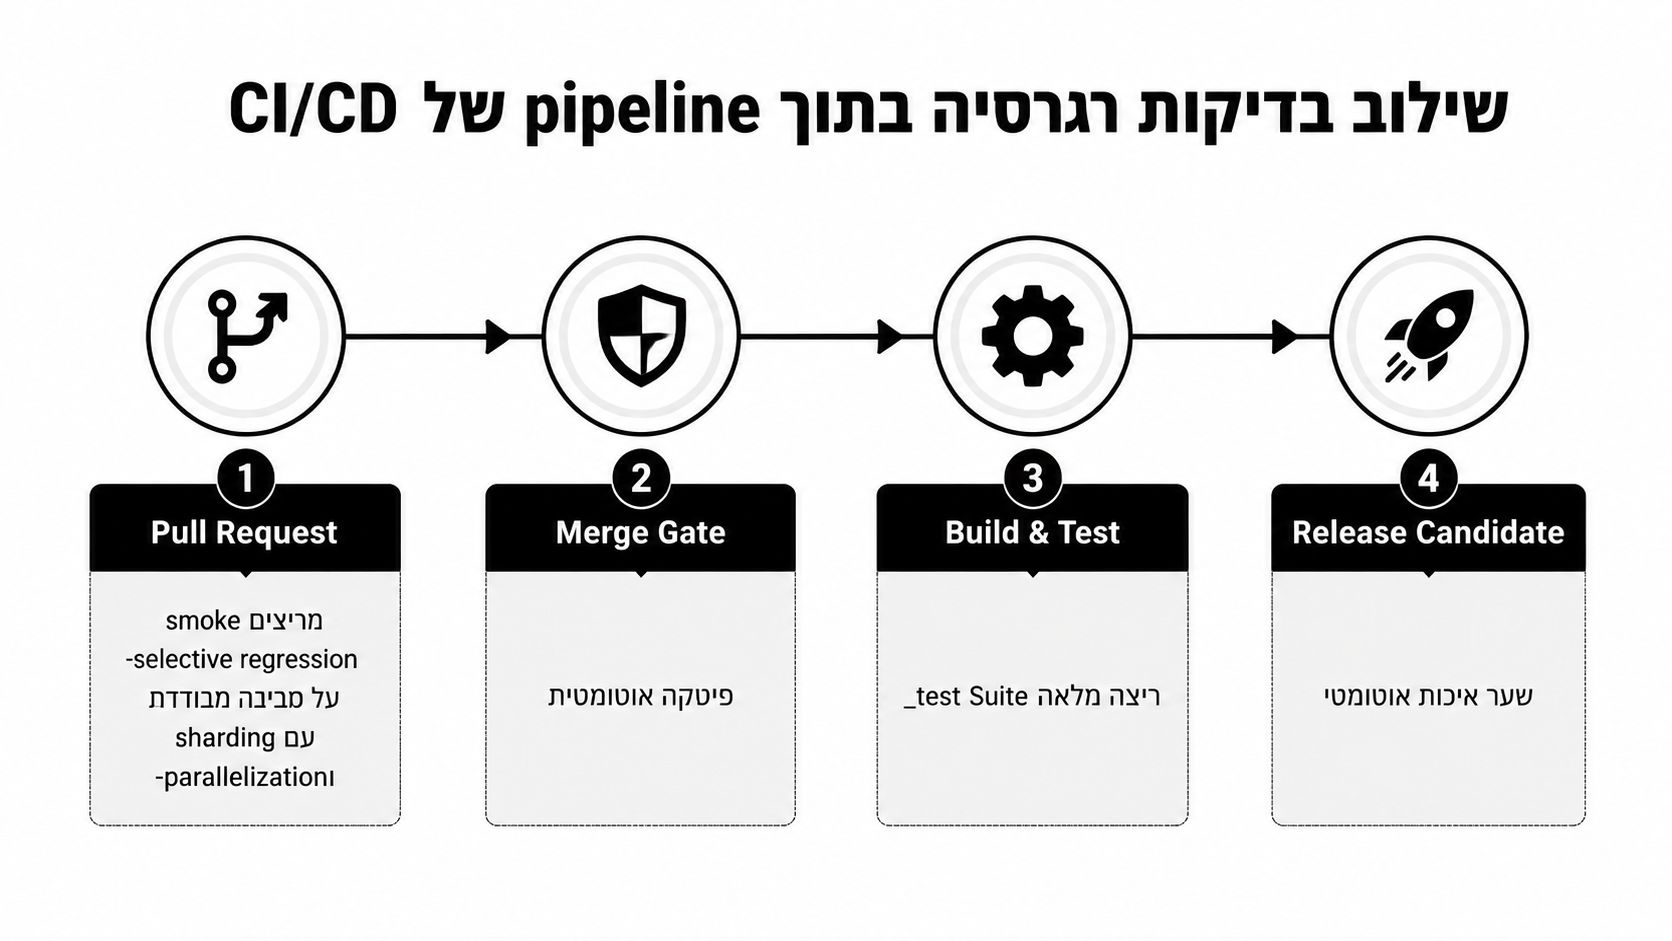
מבנה שימושי נראה כך:
- Pull request: מריצים smoke ו-selective regression על סביבה מבודדת. sharding ו-parallelization מחלקים את העבודה בין runners.
- Merge gate: חוסמים merge כאשר בדיקה קריטית נכשלת או כאשר קיימת אי-התאמה בחוזה API.
- Build and test: אחרי merge ל-main מריצים סוויטה עמוקה יותר, כולל בדיקות אינטגרציה ושירותים.
- Release candidate: בסביבת staging בודקים את המועמד לפריסה לפני החלטת release.
מדדים שמסייעים, ומדדים שמטעים
Code coverage לבדו אינו מדד איכות. הוא אומר אילו שורות קוד הורצו, לא אם נבדקו התוצאות העסקיות הנכונות. כדאי לשלב אותו עם requirement coverage, מיפוי מסלולי משתמש, failure rate per build, שיעור בדיקות flaky וזמן feedback.
גם “כל הבדיקות עברו” אינו מספיק אם הסוויטה לא מכסה את השינוי. לכן חשוב לקשר בין PR, רכיבים מושפעים, בדיקות שהורצו ותוצאות. תהליך כזה מאפשר ל-CTO ולמנהל המוצר להבין מה באמת נבדק, ולא רק לקבל סימון ירוק.
מה משתנה בעידן Agentic AI
כאשר סוכני AI מייצרים או משנים קוד, מספר הקבצים המושפעים עלול להיות פחות ברור לבני אדם. סוכן יכול לעדכן מודל, endpoint, קומפוננטת UI ובדיקת snapshot באותה משימה. מעבר מבחירת בדיקות לפי דרישות בלבד לבחירה לפי שינוי בפועל נעשה לכן חשוב יותר.
הגישה המעשית כוללת:
- ניתוח שינוי אוטומטי: זיהוי קבצים, תלויות, APIs והתנהגות UI שהושפעו.
- בדיקות חוזים: איתור שינוי בלתי צפוי במבנה בקשות ותשובות בין שירותים.
- בדיקות UI ממוקדות: אימות שמסלולים קריטיים לא השתנו גם אם ה-PR לא מזכיר אותם.
- אישור אנושי: סוכן יכול להציע בדיקות, אך בעל המוצר צריך להחליט מהו הסיכון העסקי המקובל.
תוכנית ה-AI הלאומית של רשות החדשנות מדגישה יצירת סביבות ניסוי ופיילוטים. בסביבה כזו, שבה צוותים בונים ומשנים פתרונות במהירות, regression testing צריך להיות אדפטיבי. הוא לא יכול להסתמך רק על סוויטה סטטית שמתנפחת בכל איטרציה, כפי שמנתח הדיון על גישת regression testing מבוססת שינוי בעידן AI.
מה לעשות בפועל בסטארטאפ או בארגון
סטארטאפ קטן לא צריך להעתיק את תשתית הבדיקות של Enterprise. צוות של שלושה מפתחים יכול להתחיל במסלולים שמייצגים את הסיכון האמיתי: הרשמה, התחברות, פעולה עסקית מרכזית ויציאה תקינה. את הבדיקות האלה אפשר להריץ בכל PR באמצעות Playwright ו-GitHub Actions, תוך שמירה על נתוני בדיקה מבודדים.
הצוות לא צריך לבנות מראש מאות בדיקות E2E או להקים תשתית Kubernetes רק כדי להריץ סוויטה ראשונית. עדיף להתחיל ב-Smoke Suite אמין, להוסיף בדיקות בעקבות תקלות אמיתיות ושינויים מהותיים, ולהקצות בעלות ברורה על תיקון בדיקות שנכשלות.
בארגון גדול, האתגר שונה. יש צורך בחלוקה מקבילית של בדיקות, בסביבות דפדפן מגוונות, בבדיקות API סינכרוניות, בבדיקות UI אסינכרוניות וב-contract tests בין שירותים. כאן כלי כמו Selenium Grid, שירותי דפדפנים מנוהלים או שילוב Playwright עם orchestrator יכולים להיות מוצדקים, אבל רק אם המערכת מנוהלת סביב סיכונים ולא סביב מספר הכלים.
| קריטריון | סטארטאפ, 5 עד 15 מפתחים | ארגון, 100 מפתחים ומעלה |
|---|---|---|
| מטרת העל | Feedback מהיר והגנה על מסלולי ליבה | כיסוי בין צוותים, שירותים וסביבות |
| סוויטה ראשונית | Smoke ו-critical path | שכבות Smoke, API, contract, UI ו-full regression |
| כלי מתאים | Playwright או Cypress, לפי ה-stack | Selenium Grid, Playwright או שילוב מנוהל |
| הרצה | בכל PR ובפריסות מרכזיות | PR, merge gate, staging ו-release candidate |
| תחזוקה | בעלות ישירה של צוות הפיתוח | בעלות מחולקת, סטנדרטים וביקורת מרכזית |
| סיכון מרכזי | Over-engineering והאטת הפיתוח | flaky tests, כפילויות ותלות בין צוותים |
| החלטת השקעה | מוסיפים בדיקות לפי תקלות ושינוי | מתעדפים לפי השפעה עסקית ו-impact analysis |
המלצה ניהולית: הגדירו זמן מקסימלי מקובל לריצת ה-pipeline, אבל אל תקריבו בדיקה קריטית רק כדי לעמוד ביעד. אם הסוויטה איטית, חלקו אותה לפי סיכון, שפרו נתונים וסביבות, והשתמשו בהרצה מקבילית.
הדבר החשוב ביותר הוא לתעד פשרות. כתבו אילו מסלולים נבדקים בכל PR, מה נדחה ל-staging, אילו בדיקות ידניות נשארו ומי אחראי לטפל בכשל. מדריך הבלוג המקצועי של מיסטרביט יכול לשמש נקודת התחלה נוספת לשיחה על ארכיטקטורה, פיתוח תוכנה ותהליכי delivery.
מיסטרביט מסייעת לצוותים לבנות אסטרטגיית regression testing, להטמיע אוטומציה ב-CI/CD ולחבר בין בדיקות, ארכיטקטורה ופיתוח מוצר. אם אתם צריכים פיתוח תוכנה מותאם אישית, פתרונות AI, Team Extension או חיזוק טכנולוגי לצוות קיים, בקרו באתר מיסטרביט ותאמו שיחה מקצועית.